doubao-seedream-5-0-flashDoubao Seedream 5.0 Flash es el nivel rápido y económico de la familia Seedream 5.0 de ByteDance, servido aquí desde el endpoint oficial de Volcano Ark. Está pensado para trabajo de gran volumen, donde el tiempo de respuesta y el coste por imagen importan más que el último detalle de calidad: en nuestras pruebas una imagen 2K tarda unos 13 a 15 segundos y una 1K unos 10. Texto a imagen y edición comparten el mismo endpoint, con hasta 10 imágenes de referencia para ediciones de fusión. También puede editar una imagen que ya tiene fondo transparente y conservar esa transparencia: envía un PNG con canal alfa y background "transparent", y recibes un PNG con alfa listo para colocar sobre un banner o una plantilla de producto. La salida es 1K o 2K (este modelo no tiene 4K), con proporciones de 21:9 a 9:16, a $0.03 por imagen y sin marca de agua. También puede separar una imagen en una imagen base más hasta 16 capas PNG transparentes (texto, sujetos, objetos), cada una con nombre, orden de apilado y posición en el original; la separación en capas se cobra a $0.03 por imagen de salida, así que una base más 11 capas cuesta $0.36.
Generated image will appear here
Enter a prompt and click Generate
Unos 10 segundos a 1K y entre 13 y 15 segundos a 2K en nuestras pruebas, pensado para grandes volúmenes y uso interactivo
Envía un PNG que ya tiene canal alfa con background "transparent"; la imagen editada vuelve como PNG con esa transparencia intacta (no recorta fondos de imágenes normales)
Texto a imagen, edición de una sola imagen y fusión con hasta 10 imágenes de referencia en el mismo endpoint
Mismo precio en 1K y 2K, una imagen por llamada, sin marca de agua
Separa una imagen en una base más hasta 16 capas PNG transparentes, cada una con nombre y posición; $0.03 por imagen de salida
La descomposición en capas es la función de Seedream 5.0 Flash que la documentación de ByteDance llama 图层拆分 y que los catálogos de terceros listan como doubao-seedream-5-0-flash-layerize: envías un PNG o un JPEG con layer_decomposition en true y el modelo te devuelve una imagen base más hasta 16 capas PNG transparentes. Cada capa trae un nombre, una descripción de una frase, un z_index que fija el orden de apilado y un bounding_box en dos sistemas de coordenadas, píxeles y normalizado (0–1000). En apimodels.app es un simple booleano sobre el mismo nombre de modelo doubao-seedream-5-0-flash que ya usas para texto a imagen y edición: una sola API key y sin cuenta de Volcengine.
Dos cosas de la salida de Seedream 5.0 Flash nos sorprendieron al probarla, y las dos importan en cuanto construyes algo encima. La primera: la imagen base no es el original, sino la imagen con todas las capas extraídas levantadas y los huecos rellenados. Un cartel de cafetería dividido en nueve capas vuelve con una cartulina crema lisa como base; un cartel del que solo pediste el texto vuelve con la zona del título repintada como cielo. La segunda: cada PNG de capa se renderiza más grande que su bounding box, normalmente entre dos y cuatro veces por lado (una caja de logo de 439×70 px volvió como un PNG de 1801×287 px), conservando la proporción. Al componer, coloca y escala cada capa según bounding_box.absolute, y toma los píxeles sobrantes como margen gratis para ampliar esa capa más adelante.
Todo lo que ves en esta página es una petición real por caso en apimodels.app, ejecutada el 27 y el 28 de septiembre de 2026 en el nivel 2K. Las imágenes, los nombres de capa, las descripciones y las cajas son lo que devolvió Seedream 5.0 Flash, sin retocar; los precios son la tarifa de lista de $0.03 por imagen de salida; los segundos son el tiempo real desde la llamada de creación hasta el resultado completado. Haz clic en cualquier capa de los exploradores de abajo para aislarla y ver su caja sobre la base.
| Campo | Dónde | Qué significa |
|---|---|---|
| resultUrls | resultado de la tarea | primero la imagen base y después cada capa en orden de z_index |
| resultJson.layers[i].z_index | cada imagen | 0 es la base; de 1 en adelante se apilan hacia el espectador |
| resultJson.layers[i].name, description | cada capa | los escribe el modelo, en el idioma que pida tu prompt (en chino si no lo pides) |
| resultJson.layers[i].bounding_box.absolute | cada capa | [x1, y1, x2, y2] en píxeles de la imagen base |
| resultJson.layers[i].bounding_box.normalized | cada capa | la misma caja sobre una cuadrícula de 0–1000, independiente de la resolución |
| archivos de capa | cada capa | PNG con alfa, más grande que la caja; la base sigue a output_format |
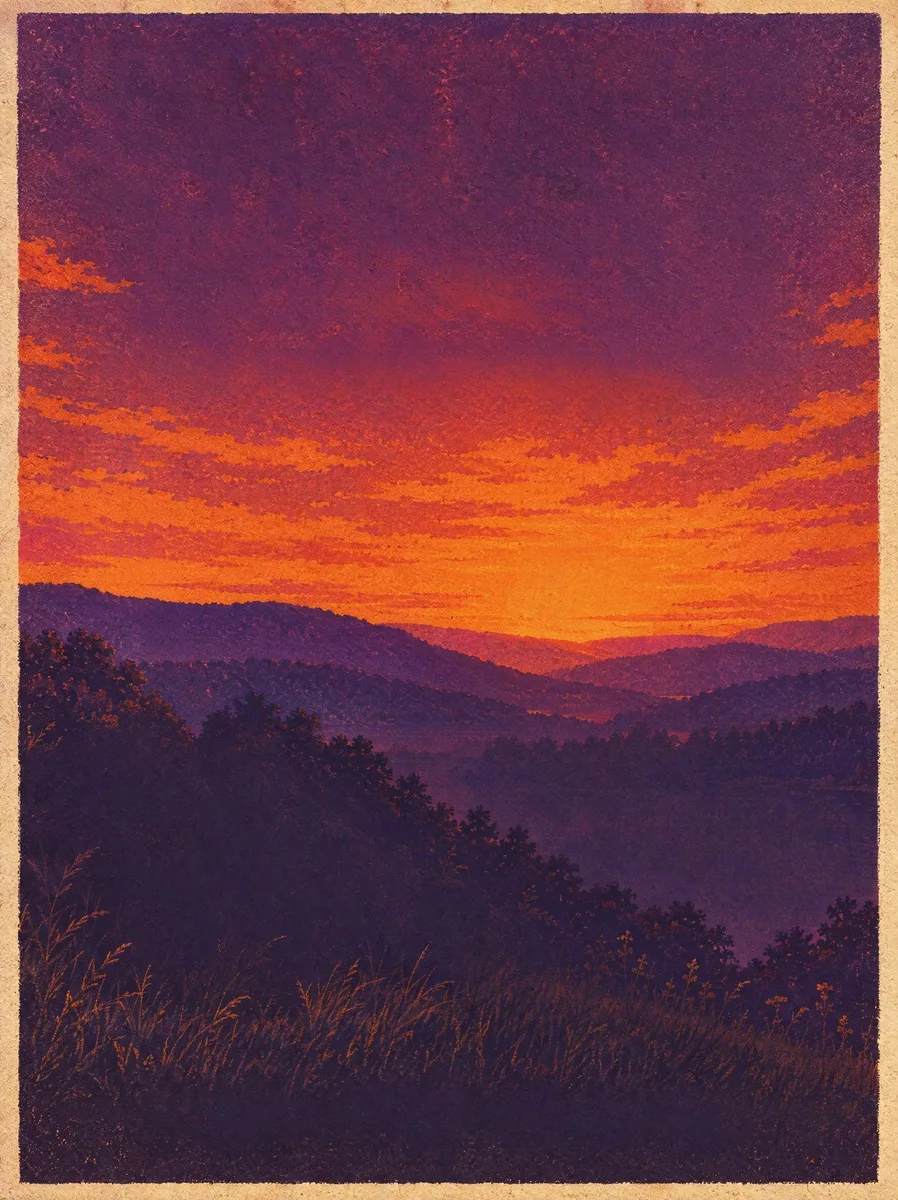
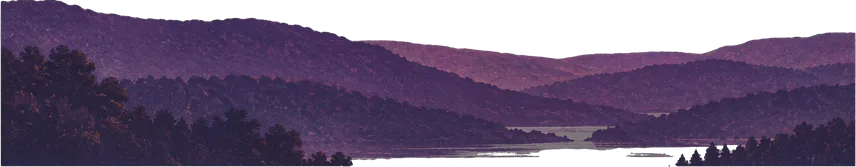
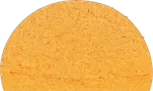
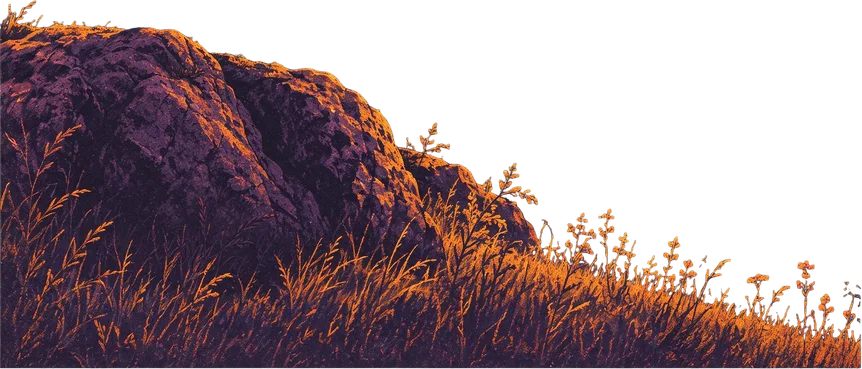
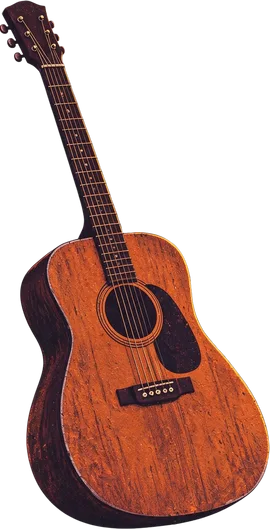

Haz clic en una capa para aislarla. El contorno es su bounding_box sobre la imagen base; la base es lo que el modelo rellenó tras extraer las capas.
prompt: Separate every main element onto its own layer. Write every layer name and description in English.
size 2K · 10 imágenes de salida · $0.30 a $0.03 cada una · 62s de espera
| z_index | name | bounding_box (normalizado, 0–1000) | description |
|---|---|---|---|
| 0 | imagen base (z_index 0): sin nombre, descripción ni caja; el formato sigue a output_format | ||
| 1 | Sunset Sky | [18, 11, 981, 497] | The gradient sunset sky with purple to orange textured clouds, forming the base background of the poster. |
| 2 | River Water | [400, 595, 908, 810] | The calm river surface reflecting the orange sunset glow, with subtle ripples. |
| 3 | Distant Hills and Forests | [24, 486, 976, 625] | The layered purple distant mountain ranges and dense dark forest tree silhouettes on both river banks. |
| 4 | Setting Sun | [559, 459, 728, 535] | The round yellow-orange setting sun above the distant hills, no other landscape elements included. |
| 5 | Foreground Rock and Grass | [20, 601, 980, 908] | The foreground rocky outcrop and tall wild grass with small wildflowers, excluding the guitar. |
| 6 | Acoustic Guitar | [92, 397, 392, 837] | The full wooden acoustic guitar leaning on the rock, no surrounding grass or rocks included. |
| 7 | Live at Riverside Park Text | [107, 284, 894, 322] | The text 'Live at Riverside Park' with two horizontal divider lines on both sides, in cream retro font. |
| 8 | Event Info Text | [55, 906, 945, 952] | The bottom text 'Aug 14 · 7 PM · Free entry' with two horizontal divider lines on both sides, in cream retro font. |
| 9 | SUMMER ECHOES Title Text | [73, 36, 926, 278] | The large bold vintage text 'SUMMER ECHOES' in cream textured font, no other elements included. |
Petición real en apimodels.app, 2026-09-28, tarea cmulg47z
Las ejecuciones de abajo cubren las tres formas en que de verdad se usa la descomposición en capas de Seedream 5.0 Flash: una división automática completa (sin prompt, o con "separate every main element"), una división selectiva ("only the text", "the sneaker and the price tag") y el recorte de un único elemento. El coste depende del número de imágenes que vuelven, no del tamaño ni de la complejidad de la entrada, así que la división selectiva es la manera económica de conseguir justo la pieza que necesitas: un recorte suelto cuesta $0.06, un cartel completo $0.30 y el techo de 16 imágenes $0.51.
| Escenario | Petición | Salidas | Precio de lista | Tiempo |
|---|---|---|---|---|
| Cartel de evento, 3:4 | división completa | 1 base + 9 capas | $0.30 | 62 s |
| Cartel promocional de cafetería, 3:4 | división completa | 1 base + 9 capas | $0.30 | 60 s |
| Anuncio de producto, 16:9 | división completa | 1 base + 7 capas | $0.24 | 53 s |
| Icono de app + logotipo, 3.8:1 | división completa, toca el tope de 16 imágenes | 1 base + 15 capas | $0.48 | 74 s |
| Cartel de evento, solo texto | selectiva | 1 base + 4 capas | $0.15 | 52 s |
| Anuncio de zapatillas | selectiva, dos elementos | 1 base + 2 capas | $0.09 | 37 s |
| Foto de dos personas | una persona | 1 base + 1 capa | $0.06 | 31 s |
| Cartel de cafetería, prompt en chino | una insignia | 1 base + 1 capa | $0.06 | 25 s |
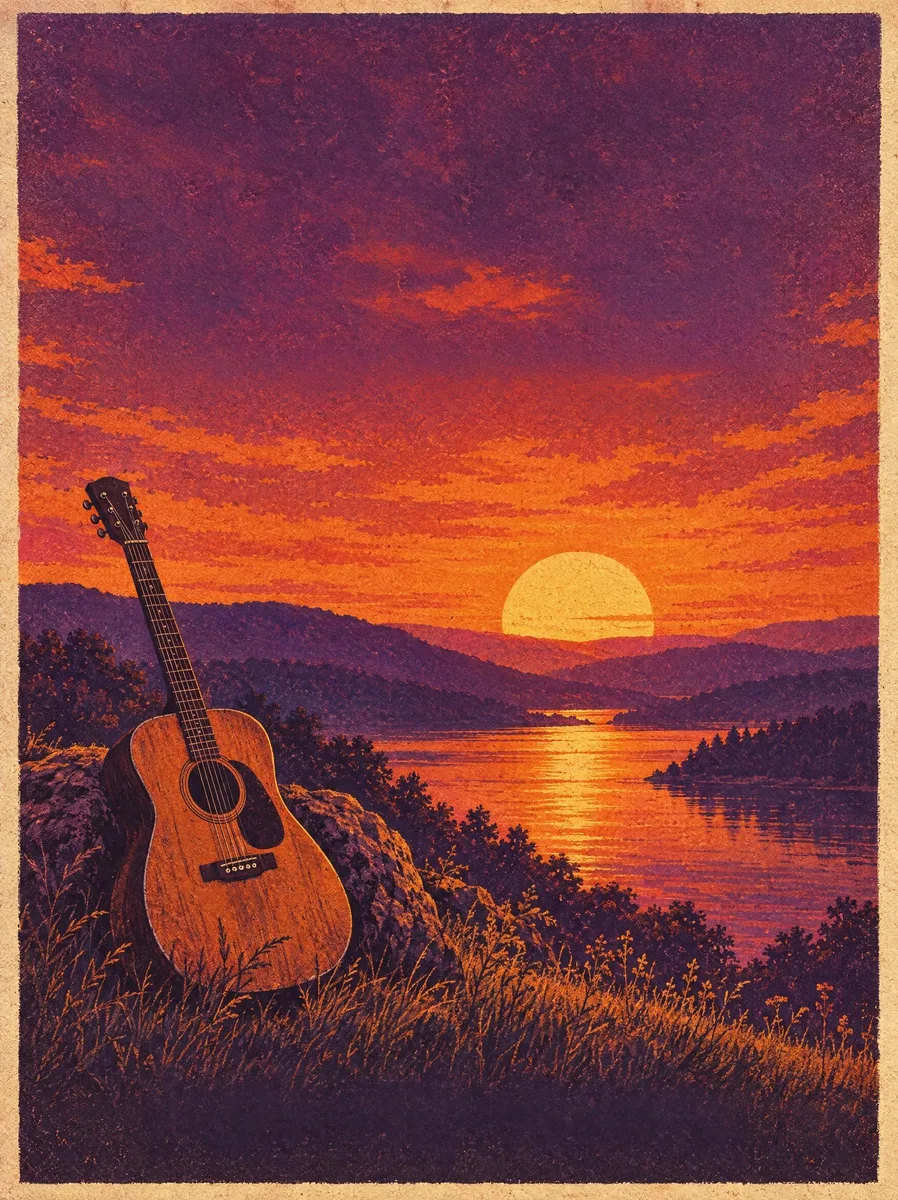
Un cartel de concierto de estilo vintage: atardecer, lago, colinas, una guitarra apoyada en una roca y tres bloques de texto. Con el prompt "Separate every main element onto its own layer", Seedream 5.0 Flash devolvió nueve capas: Sunset Sky, River Water, Distant Hills and Forests, Setting Sun, Foreground Rock and Grass, Acoustic Guitar, y los tres bloques de texto como tres capas independientes (el título, la línea "Live at Riverside Park" y la línea de la fecha). Diez imágenes de salida, $0.30, 62 segundos.
Es la división que quieres cuando el cartel va a reutilizarse: cambiar la fecha de la línea inferior, llevarte la guitarra a otro diseño o subir el título para dejar sitio a una franja de patrocinadores, y nada de eso obliga a repintar el cielo. Fíjate en que la descripción de la capa del sol dice "no other landscape elements included": el modelo deja explícito qué dejó fuera de cada recorte.
Haz clic en una capa para aislarla. El contorno es su bounding_box sobre la imagen base; la base es lo que el modelo rellenó tras extraer las capas.
prompt: Separate every main element onto its own layer. Write every layer name and description in English.
size 2K · 10 imágenes de salida · $0.30 a $0.03 cada una · 62s de espera
| z_index | name | bounding_box (normalizado, 0–1000) | description |
|---|---|---|---|
| 0 | imagen base (z_index 0): sin nombre, descripción ni caja; el formato sigue a output_format | ||
| 1 | Sunset Sky | [18, 11, 981, 497] | The gradient sunset sky with purple to orange textured clouds, forming the base background of the poster. |
| 2 | River Water | [400, 595, 908, 810] | The calm river surface reflecting the orange sunset glow, with subtle ripples. |
| 3 | Distant Hills and Forests | [24, 486, 976, 625] | The layered purple distant mountain ranges and dense dark forest tree silhouettes on both river banks. |
| 4 | Setting Sun | [559, 459, 728, 535] | The round yellow-orange setting sun above the distant hills, no other landscape elements included. |
| 5 | Foreground Rock and Grass | [20, 601, 980, 908] | The foreground rocky outcrop and tall wild grass with small wildflowers, excluding the guitar. |
| 6 | Acoustic Guitar | [92, 397, 392, 837] | The full wooden acoustic guitar leaning on the rock, no surrounding grass or rocks included. |
| 7 | Live at Riverside Park Text | [107, 284, 894, 322] | The text 'Live at Riverside Park' with two horizontal divider lines on both sides, in cream retro font. |
| 8 | Event Info Text | [55, 906, 945, 952] | The bottom text 'Aug 14 · 7 PM · Free entry' with two horizontal divider lines on both sides, in cream retro font. |
| 9 | SUMMER ECHOES Title Text | [73, 36, 926, 278] | The large bold vintage text 'SUMMER ECHOES' in cream textured font, no other elements included. |
Petición real en apimodels.app, 2026-09-28, tarea cmulg47z
Un cartel de "AUTUMN LATTE WEEK" con una insignia de 20% OFF, un latte de calabaza y cuatro hojas de arce en las esquinas. Seedream 5.0 Flash lo dividió en nueve capas y nombró cada hoja por posición y color (Top Left Yellow Maple Leaf, Bottom Right Orange Maple Leaf), separó la taza de la bebida con nata que lleva encima y dejó el titular y la línea inferior del evento como dos capas de texto. La base que volvió es una cartulina crema vacía: se levantó absolutamente todo.
Para una cadena que lanza la misma promoción en doce ciudades, esta es la plantilla: cambiar la línea inferior por tienda, pasar el 20% a 15% en la capa de la insignia y recolocar las hojas para una versión 9:16 de historias, todo a partir de una única división de $0.30 en lugar de doce regeneraciones que irían cambiando de estilo cada vez.

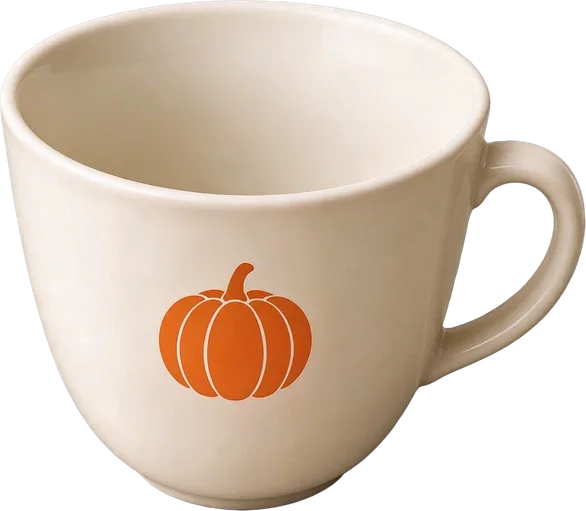
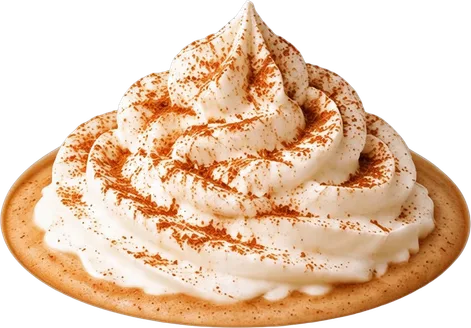
Haz clic en una capa para aislarla. El contorno es su bounding_box sobre la imagen base; la base es lo que el modelo rellenó tras extraer las capas.
prompt: Separate every main element onto its own layer. Write every layer name and description in English.
size 2K · 10 imágenes de salida · $0.30 a $0.03 cada una · 60s de espera
| z_index | name | bounding_box (normalizado, 0–1000) | description |
|---|---|---|---|
| 0 | imagen base (z_index 0): sin nombre, descripción ni caja; el formato sigue a output_format | ||
| 1 | Bottom Event Info Text | [100, 912, 899, 943] | The brown text 'Oct 1 - Oct 7 · Maple Street Café' with short horizontal line decorations on both sides, no extra elements included. |
| 2 | Bottom Left Red Maple Leaf | [43, 622, 311, 842] | The large red maple leaf decoration located at the bottom left of the cup, no other elements included. |
| 3 | Bottom Right Orange Maple Leaf | [743, 728, 937, 852] | The orange maple leaf decoration located at the bottom right of the cup, no other elements included. |
| 4 | Top Left Yellow Maple Leaf | [59, 326, 218, 461] | The yellow maple leaf decoration located at the top left of the cup, no other elements included. |
| 5 | Top Right Small Red Maple Leaf | [876, 521, 987, 607] | The small red maple leaf decoration located at the top right of the cup, no other elements included. |
| 6 | White Latte Cup with Pumpkin Logo | [213, 384, 869, 810] | The white ceramic latte cup with an orange pumpkin logo printed on the front, no coffee or cream inside included. |
| 7 | Latte Drink with Whipped Cream | [224, 274, 751, 547] | The pumpkin spice latte topped with swirled whipped cream dusted with cinnamon powder, placed inside the cup. |
| 8 | 20% OFF Red Badge | [682, 260, 950, 459] | The circular red discount badge with white dashed border and white text '20% OFF', no other elements included. |
| 9 | AUTUMN LATTE WEEK Title Text | [77, 52, 923, 227] | The bold brown text 'AUTUMN LATTE WEEK' with small leaf decorations on both sides, no extra elements included. |
Petición real en apimodels.app, 2026-09-28, tarea cmukjkdk
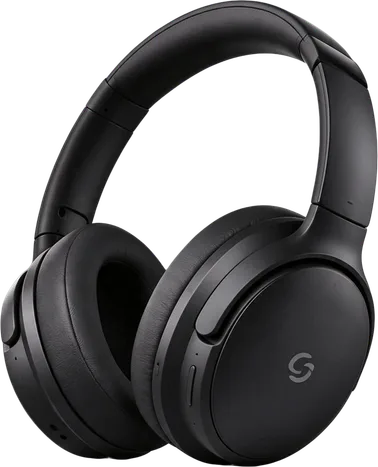
Un banner de auriculares con la maquetación clásica de e-commerce. Seedream 5.0 Flash devolvió siete capas que se corresponden una a una con cómo lo habría montado un diseñador: el logo de SoundPeak, el titular "Silence Everything", el subtítulo de características, el pedestal redondo de exposición, la etiqueta amarilla de precio $129, el botón "Shop Now" y los propios auriculares. La base es el fondo azul de estudio sin el pedestal. Ocho imágenes, $0.24, 53 segundos.
Esta ejecución fue también la que dejó claro el comportamiento de la resolución: el logo ocupa una caja de 439×70 px sobre la base de 2720×1536, pero su PNG mide 1801×287 px. Escálalo a la caja y queda exactamente donde estaba; conserva el PNG y tienes un logo que aguanta ampliarse cuatro veces para una posición de portada.
Haz clic en una capa para aislarla. El contorno es su bounding_box sobre la imagen base; la base es lo que el modelo rellenó tras extraer las capas.
prompt: Separate every main element onto its own layer. Write every layer name and description in English.
size 2K · 8 imágenes de salida · $0.24 a $0.03 cada una · 53s de espera
| z_index | name | bounding_box (normalizado, 0–1000) | description |
|---|---|---|---|
| 0 | imagen base (z_index 0): sin nombre, descripción ni caja; el formato sigue a output_format | ||
| 1 | SoundPeak Logo and Brand Text | [67, 64, 228, 109] | Extract the SoundPeak brand logo and the text 'SoundPeak', no extra elements included. |
| 2 | Headline Text Silence Everything | [66, 229, 429, 473] | Extract the bold dark blue headline text 'Silence Everything', no extra elements included. |
| 3 | Subtitle Feature Text | [67, 503, 404, 535] | Extract the subtitle text 'Active noise cancelling, 40-hour battery', no extra elements included. |
| 4 | White Round Display Pedestal | [455, 754, 917, 946] | Extract the light blue round display pedestal that holds the headphones, no extra elements included. |
| 5 | Yellow Price Tag $129 | [67, 565, 201, 665] | Extract the yellow price tag with the text '$129', no extra elements included. |
| 6 | Shop Now Button | [67, 705, 253, 792] | Extract the dark blue rounded 'Shop Now' button with arrow, no extra elements included. |
| 7 | Black Over-Ear Headphones | [512, 100, 826, 789] | Extract the black SoundPeak over-ear noise cancelling headphones, no extra elements included. |
Petición real en apimodels.app, 2026-09-27, tarea cmujyv1k
Un conjunto de logo plano: un icono negro de esquinas redondeadas con una estrella y ocho rayos de colores, junto a la palabra "Sparkpix". Seedream 5.0 Flash agotó todas las plazas que tiene: 15 capas más la base, 16 imágenes, $0.48, 74 segundos. Dio a cada rayo su propia capa (nombrada por color y posición), separó la estrella del fondo del icono y desmontó el logotipo: "Spark" se quedó como una sola capa, mientras que la p, la i, el punto de la i y la x recibieron una cada una.
Ese último detalle es el tope en acción. El modelo no se detiene en 16 descartando elementos: agrupa. Cuando tu arte tiene más de 15 cosas que te importan, pídelas de forma selectiva en dos o tres peticiones en vez de una; cada petición se cobra solo por lo que devuelve, así que dos divisiones selectivas de cuatro capas cada una cuestan $0.30 en total, menos que una división completa que de todos modos las habría fusionado.




Haz clic en una capa para aislarla. El contorno es su bounding_box sobre la imagen base; la base es lo que el modelo rellenó tras extraer las capas.
prompt: Separate every main element onto its own layer. Write every layer name and description in English.
size 2K · 16 imágenes de salida · $0.48 a $0.03 cada una · 74s de espera
| z_index | name | bounding_box (normalizado, 0–1000) | description |
|---|---|---|---|
| 0 | imagen base (z_index 0): sin nombre, descripción ni caja; el formato sigue a output_format | ||
| 1 | Black rounded square icon background | [62, 124, 250, 875] | The black rounded square base of the app icon, no other decorative elements included |
| 2 | Yellow four-pointed star | [88, 323, 176, 653] | The bright yellow four-pointed star shape at the center of the icon, no surrounding rays included |
| 3 | Green top-left ray | [38, 132, 98, 359] | The bright green teardrop-shaped ray at the top-left position of the icon |
| 4 | Green top-right ray | [164, 137, 225, 367] | The bright green teardrop-shaped ray at the top-right position of the icon |
| 5 | Green bottom-left ray | [39, 609, 99, 837] | The bright green teardrop-shaped ray at the bottom-left position of the icon |
| 6 | Green bottom-right ray | [166, 617, 226, 843] | The bright green teardrop-shaped ray at the bottom-right position of the icon |
| 7 | Orange top ray | [122, 55, 143, 280] | The orange teardrop-shaped ray at the top center position of the icon |
| 8 | Red bottom ray | [122, 695, 143, 917] | The red teardrop-shaped ray at the bottom center position of the icon |
| 9 | Pink left ray | [21, 447, 81, 526] | The bright pink teardrop-shaped ray at the left center position of the icon |
| 10 | Purple right ray | [183, 446, 242, 527] | The purple teardrop-shaped ray at the right center position of the icon |
| 11 | Yellow text 'Spark' | [306, 171, 755, 863] | The bold rounded yellow text spelling 'Spark', no other colored text included |
| 12 | Orange text 'p' | [752, 335, 861, 862] | The bold rounded orange lowercase letter 'p' that follows the yellow 'Spark' text |
| 13 | Red text 'i' | [859, 311, 898, 732] | The bold rounded red lowercase letter 'i' that follows the orange 'p' text |
| 14 | Yellow dot of 'i' | [857, 126, 901, 286] | The solid yellow circular dot positioned above the red 'i' letter |
| 15 | Pink text 'x' | [897, 326, 1000, 732] | The bold rounded bright pink lowercase letter 'x' that follows the red 'i' text |
Petición real en apimodels.app, 2026-09-28, tarea cmul6zg7
El mismo cartel de concierto del primer ejemplo, pero con el prompt "Separate only the text". Seedream 5.0 Flash devolvió cuatro capas — "Live at Riverside Park", "ECHOES", "SUMMER" y la línea de la fecha — y dejó la guitarra, el sol y el paisaje en la base, repintando el cielo donde antes estaba el título. Cinco imágenes, $0.15, 52 segundos: la mitad del precio de la división completa, porque solo pagaste las capas que pediste.
Es el camino más económico a un cartel localizado: conservas la base, sustituyes las cuatro capas de texto por tus versiones en japonés o en alemán, y el arte de debajo queda intacto. Ten en cuenta que el modelo decidió dividir el título de dos palabras en dos capas; si lo necesitas como un solo bloque, dilo en el prompt.

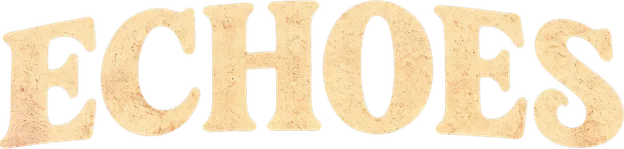
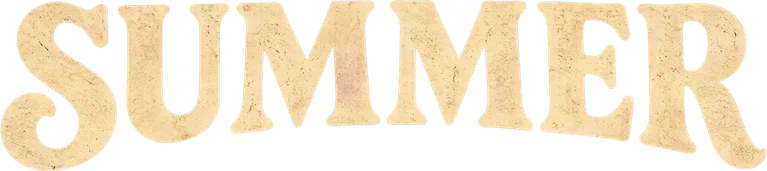
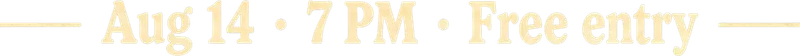
Haz clic en una capa para aislarla. El contorno es su bounding_box sobre la imagen base; la base es lo que el modelo rellenó tras extraer las capas.
prompt: Separate only the text. Write every layer name and description in English.
size 2K · 5 imágenes de salida · $0.15 a $0.03 cada una · 52s de espera
| z_index | name | bounding_box (normalizado, 0–1000) | description |
|---|---|---|---|
| 0 | imagen base (z_index 0): sin nombre, descripción ni caja; el formato sigue a output_format | ||
| 1 | Live at Riverside Park text | [107, 284, 893, 322] | Extract the text 'Live at Riverside Park' with its left and right horizontal divider lines only, no other elements included. |
| 2 | ECHOES text | [157, 155, 852, 278] | Extract the text 'ECHOES' only, no other elements included. |
| 3 | SUMMER text | [73, 36, 927, 178] | Extract the text 'SUMMER' only, no other elements included. |
| 4 | Event info text | [55, 906, 945, 952] | Extract the text 'Aug 14 · 7 PM · Free entry' with its left and right horizontal divider lines only, no other elements included. |
Petición real en apimodels.app, 2026-09-28, tarea cmukpy5o
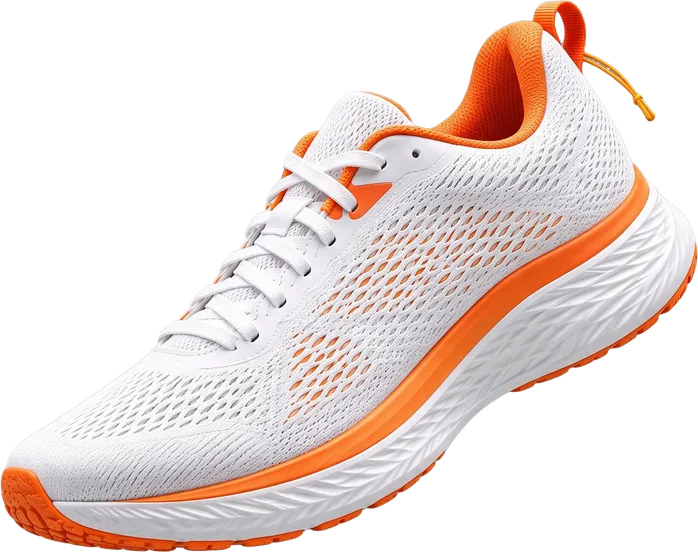
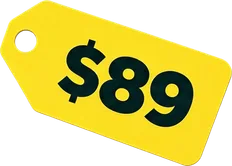
Un anuncio de zapatillas de running en verde menta con un titular, un botón "Shop now", la zapatilla y una etiqueta amarilla de $89. El prompt nombró exactamente dos cosas — "Separate the sneaker and the price tag" — y Seedream 5.0 Flash devolvió exactamente esas dos capas, dejando el titular y el botón en la base. Tres imágenes, $0.09, 37 segundos.
El trabajo de catálogo de producto casi siempre tiene esta forma: un objeto protagonista y un elemento de precio que cambia cada semana. Dividirlos una vez te da un recorte con borde alfa limpio para la página de listado y una capa de etiqueta que puedes rotular de nuevo, mientras el resto del anuncio se queda como fondo bloqueado.
Haz clic en una capa para aislarla. El contorno es su bounding_box sobre la imagen base; la base es lo que el modelo rellenó tras extraer las capas.
prompt: Separate the sneaker and the price tag. Write every layer name and description in English.
size 2K · 3 imágenes de salida · $0.09 a $0.03 cada una · 37s de espera
| z_index | name | bounding_box (normalizado, 0–1000) | description |
|---|---|---|---|
| 0 | imagen base (z_index 0): sin nombre, descripción ni caja; el formato sigue a output_format | ||
| 1 | Sneaker | [237, 130, 818, 744] | The white and orange running sneaker, including its mesh upper, laces, sole, heel tab, and the attached orange tag string, no price tag included |
| 2 | Price Tag | [761, 219, 954, 403] | The yellow price tag with black text '$89', no other elements included |
Petición real en apimodels.app, 2026-09-28, tarea cmukpzj6
Una foto de oficina con dos personas (las dos generadas por IA, así que aquí no interviene la imagen de ninguna persona real). Con "Separate the woman on the right", Seedream 5.0 Flash produjo una capa — el modelo la llamó exactamente así — y una base en la que ella ya no está y la sala de reuniones que tenía detrás se ha rellenado. Dos imágenes, $0.06, 31 segundos.
Recortar a un sujeto de una foto de grupo normalmente es un trabajo de máscara más un relleno de fondo en una segunda herramienta; aquí las dos cosas vuelven de una sola llamada. El relleno de la base es generado, así que míralo antes de entregarlo: en esta ejecución las sillas y el borde de la mesa se reconstruyeron limpiamente, pero el modelo está inventando lo que había detrás de la persona, no recuperándolo.
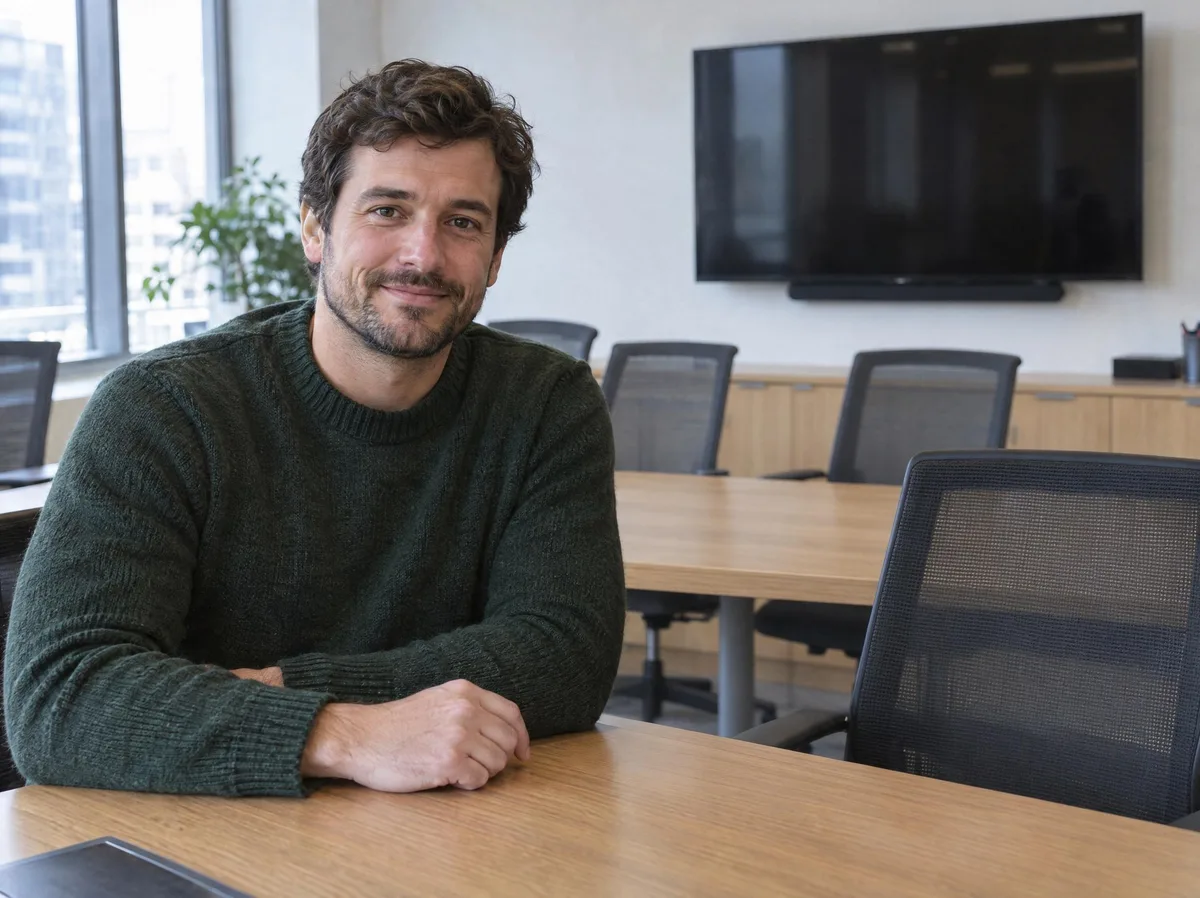
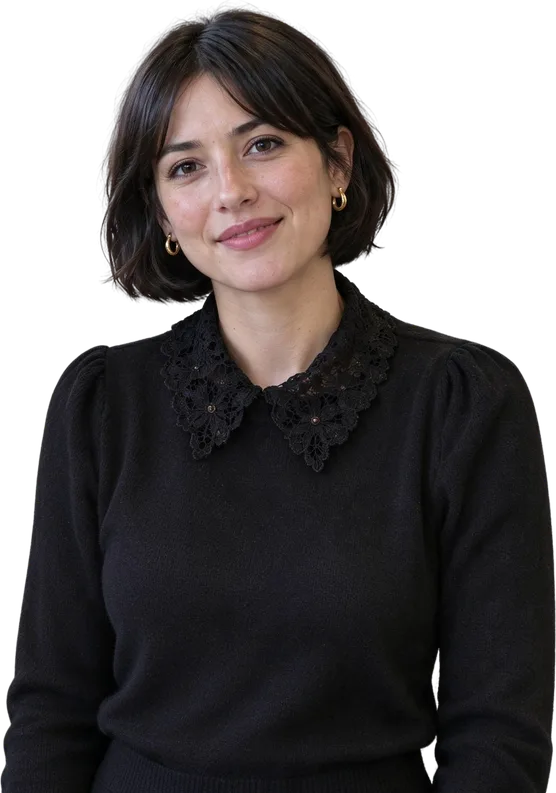
Haz clic en una capa para aislarla. El contorno es su bounding_box sobre la imagen base; la base es lo que el modelo rellenó tras extraer las capas.
prompt: Separate the woman on the right. Write every layer name and description in English.
size 2K · 2 imágenes de salida · $0.06 a $0.03 cada una · 31s de espera
| z_index | name | bounding_box (normalizado, 0–1000) | description |
|---|---|---|---|
| 0 | imagen base (z_index 0): sin nombre, descripción ni caja; el formato sigue a output_format | ||
| 1 | Woman on the right | [526, 116, 989, 999] | The full body of the woman sitting on the right side of the image, wearing a black sweater with lace collar and gold hoop earrings, no extra annotation elements included |
Petición real en apimodels.app, 2026-09-28, tarea cmukpy7d
Otra vez el cartel de la cafetería, esta vez con el prompt escrito en chino — 提取20% off的文字标签 ("extrae la insignia de texto de 20% off") — seguido de una frase en inglés pidiendo nombres y descripciones en inglés. Seedream 5.0 Flash devolvió una única capa llamada "20% OFF text badge" con descripción en inglés, y una base en la que la insignia ha desaparecido y el papel del cartel que tenía detrás se ha rellenado. Dos imágenes, $0.06, 25 segundos: la ejecución más rápida de esta página.
Dos conclusiones prácticas de este caso: puedes describir el objetivo en el idioma en que pienses, y el idioma de los metadatos devueltos se controla por separado con esa frase final. Si omites la frase, los nombres vuelven en chino, lo cual va bien para un producto chino y sorprende a todos los demás.
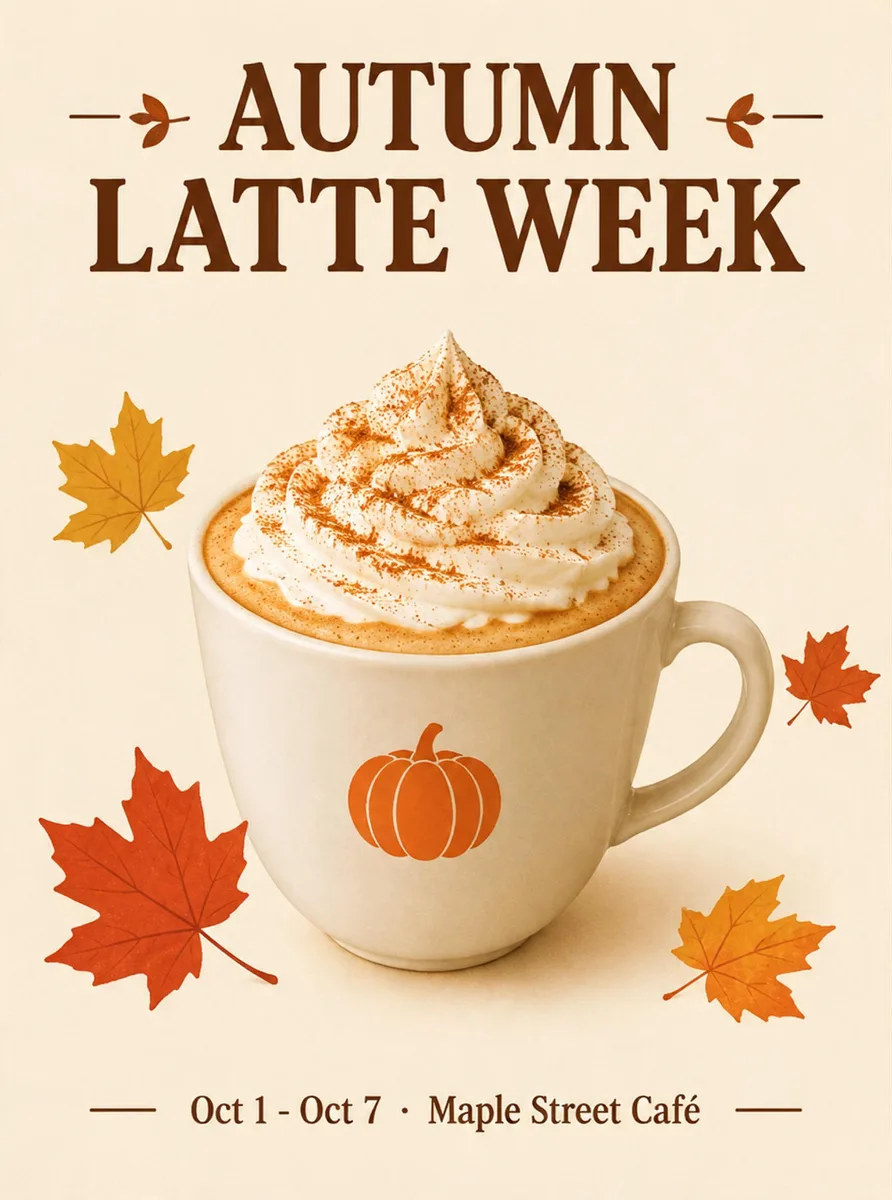
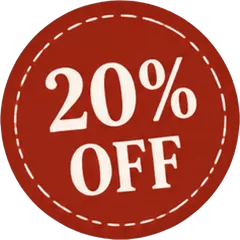
Haz clic en una capa para aislarla. El contorno es su bounding_box sobre la imagen base; la base es lo que el modelo rellenó tras extraer las capas.
prompt: 提取20% off的文字标签. Write every layer name and description in English.
size 2K · 2 imágenes de salida · $0.06 a $0.03 cada una · 25s de espera
| z_index | name | bounding_box (normalizado, 0–1000) | description |
|---|---|---|---|
| 0 | imagen base (z_index 0): sin nombre, descripción ni caja; el formato sigue a output_format | ||
| 1 | 20% OFF text badge | [681, 260, 950, 459] | Extract the red circular 20% OFF text badge with white dashed outline, only keep the complete badge including the '20% OFF' white text and red circular background, no extra elements included. |
Petición real en apimodels.app, 2026-09-28, tarea cmul38tl
La petición es el endpoint de imagen de siempre con dos campos más. POST https://api.apimodels.app/v1/images/generations con model "doubao-seedream-5-0-flash", image_url apuntando a un PNG o JPEG (URL pública o base64), layer_decomposition en true y, opcionalmente, prompt y size ("1K" o "2K"; la base conserva la proporción de la entrada). Recibes un taskId; consulta GET /v1/images/generations?task_id=… hasta que state sea completed y lee entonces resultUrls y resultJson.layers. Cada imagen de la tabla de abajo salió exactamente de esa llamada.
Tres patrones de prompt cubren casi todo. Omite el prompt, o escribe "Separate every main element onto its own layer", para una división completa. Nombra las piezas — "only the text", "the sneaker and the price tag", "the woman on the right" — para una división selectiva, y Seedream 5.0 Flash devuelve solo esas capas dejando todo lo demás en la base. Añade una frase, "Write every layer name and description in English", si quieres los metadatos en inglés; sin ella, los nombres y descripciones vuelven en chino, sea cual sea el idioma del prompt.
Qué esperar de la división en sí, a partir de estas ejecuciones: cada bloque de texto se convierte en una capa, y un título grande puede partirse por palabras (SUMMER y ECHOES volvieron por separado); los adornos pequeños como hojas y rayos reciben cada uno su propia capa, nombrada por color y posición; un producto y aquello sobre lo que se apoya se separan (taza y bebida, pedestal y auriculares). Cuando el recuento superaría las 15 capas, el modelo agrupa en lugar de descartar, así que para arte muy denso lanza dos o tres peticiones selectivas en vez de una.
| Objetivo | Prompt usado | Qué volvió |
|---|---|---|
| División completa | (omitido) o "Separate every main element onto its own layer." | 7–15 capas según el arte; cada bloque de texto, objeto y adorno separado |
| Solo texto | "Separate only the text." | 4 capas de texto; el arte queda en la base con las zonas de texto repintadas |
| Objetos nombrados | "Separate the sneaker and the price tag." | exactamente esas 2 capas |
| Un sujeto | "Separate the woman on the right." | 1 capa, base rellenada detrás de ella |
| Cualquier idioma | "提取20% off的文字标签." + la frase de nombres en inglés | 1 capa con nombre y descripción en inglés |
| Metadatos en inglés | añade "Write every layer name and description in English." | nombres y descripciones en inglés en lugar de chino |
Cada imagen que devuelve Seedream 5.0 Flash cuesta $0.03 — la base cuenta como una, cada capa cuenta como una — y no hay ninguna tarifa aparte por la descomposición en sí. Como el modelo decide cuántas capas devolver, la llamada de creación reserva de tu saldo el máximo de 17 imágenes ($0.51) y la tarea se liquida por el recuento real al completarse; la diferencia se libera de inmediato. Una petición fallida no devuelve nada y no se cobra: no existe un éxito parcial en el que pagues media división.
La consecuencia práctica es que la forma más económica de usar las capas de Seedream 5.0 Flash es pedir menos. Una división completa de cartel son $0.30; las cuatro capas de texto del mismo cartel, $0.15; una insignia, $0.06. Si un pipeline solo necesita el producto y la etiqueta de precio, un prompt selectivo cuesta un tercio de lo que cuesta la división completa y te deja menos archivos que gestionar.
| Imágenes devueltas | Composición | Pagas |
|---|---|---|
| 2 | base + 1 capa | $0.06 |
| 3 | base + 2 capas | $0.09 |
| 5 | base + 4 capas | $0.15 |
| 8 | base + 7 capas | $0.24 |
| 10 | base + 9 capas | $0.30 |
| 16 | base + 15 capas | $0.48 |
| 17 (máximo) | base + 16 capas | $0.51 — el importe reservado al crear la tarea |
Entrega a diseño. Un banner plano generado por IA es un callejón sin salida para un diseñador; ese mismo banner como base de Seedream 5.0 Flash más siete capas PNG con nombre y posición es un archivo PSD o de Figma esperando a que lo monten. Escribe cada capa en bounding_box.absolute, conserva z_index como orden de capas, y el titular, el precio y el botón vuelven a ser objetos editables. Las herramientas construidas sobre este modelo hacen exactamente eso: dividen un cartel o una foto en capas con nombre y las exportan como PSD.
Localización y variantes. Los ejemplos de solo texto y de la cafetería de arriba son el patrón: una división de Seedream 5.0 Flash de $0.15–$0.30 produce un fondo bloqueado y un puñado de capas de texto, y a partir de ahí cada idioma, región o nivel de descuento es un cambio de texto en lugar de una nueva generación que alteraría el arte. Lo mismo vale para hacer pruebas A/B de una etiqueta de precio o de una llamada a la acción entre conjuntos de anuncios.
Movimiento y composición. Capas con orden de profundidad y cajas son justo lo que necesitan las animaciones de parallax, la tipografía cinética y las revelaciones de producto: el cielo, las colinas, la guitarra y el título del cartel pueden moverse a distintas velocidades porque son archivos separados con posiciones conocidas. Las plantillas de e-commerce funcionan igual: el recorte de la zapatilla y su etiqueta pueden colocarse sobre cualquier fondo, y la resolución extra de cada PNG de capa hace que un recorte sacado de un anuncio 2K siga aguantando como imagen de portada.
Entrada: exactamente una imagen, PNG o JPEG. La fusión de varias imágenes, la generación desde texto y la descomposición en capas son modos distintos del mismo modelo Seedream 5.0 Flash y no pueden combinarse en una sola llamada, y layer_decomposition no puede combinarse con background "transparent": ese modo edita una imagen que ya tiene canal alfa y lo conserva, que es otro trabajo. size solo elige el nivel 1K o 2K; la imagen base conserva la proporción de la entrada, por eso el anuncio 16:9 volvió a 2720×1536 y los carteles 3:4 a 1760×2352.
Salida: tú no controlas el número de capas; Seedream 5.0 Flash decide entre 1 y 16 y agrupa elementos cuando se queda sin plazas. La imagen base se repinta allí donde se levantaron capas, así que trátala como contenido generado y revísala antes de entregar, sobre todo detrás de personas y productos. Los PNG de capa son más grandes que su bounding_box (entre dos y cuatro veces por lado en todas las ejecuciones de aquí) y hay que escalarlos a la caja al componer. Cuenta con una leve costura allí donde una capa grande de borde suave, como el agua o el cielo, se encuentra con la base repintada al volver a montar la imagen; los exploradores de arriba la muestran sin disimulo. Los nombres y descripciones de capa los escribe el modelo y llegan en chino salvo que el prompt pida otro idioma.
Tiempos y entrega: nuestras ocho ejecuciones tardaron entre 25 y 74 segundos, más o menos 25 segundos más tres por capa, frente a los 10–15 segundos de una imagen normal de Seedream 5.0 Flash; pon los timeouts del cliente en 180 segundos o usa callback_url en lugar de una espera bloqueante. Los enlaces de resultado son temporales: copia la base y las capas a tu propio almacenamiento en cuanto se complete la tarea.
Los tres niveles de Seedream 5.0 en apimodels.app responden en el mismo endpoint con los mismos parámetros, así que la elección depende de lo que aporta cada uno. Seedream 5.0 Flash es el nivel de volumen y, en esta plataforma, el único con descomposición en capas y edición con fondo transparente. Seedream 5.0 Pro añade edición interactiva — señalas una región con coordenadas, una caja o una marca dibujada a mano y solo cambia esa región — y texto dentro de la imagen más sólido. Seedream 5.0 Lite es el generalista de canal oficial a 2K/4K. Pasar de Seedream 5.0 Flash a Pro o Lite es modificar una sola cadena en model.
| Nivel | Id del modelo | Precio aquí | Descomposición en capas | Edición con fondo transparente | Ideal para |
|---|---|---|---|---|---|
| Seedream 5.0 Flash | doubao-seedream-5-0-flash | $0.03 por imagen de salida, 1K/2K | sí — base + hasta 16 capas | sí | volumen, divisiones en capas, ediciones que conservan el alfa |
| Seedream 5.0 Pro | doubao-seedream-5-0-pro | $0.03 (1K) / $0.06 (2K) | no se ofrece aquí | sí | ediciones interactivas por región, texto denso dentro de la imagen |
| Seedream 5.0 Lite | doubao-seedream-5-0-260128 | $0.055 por imagen, 2K/4K | no | no | generación y fusión generales a 2K/4K |
Doubao Seedream 5.0 Flash es una API de generación de imágenes de ByteDance. Doubao Seedream 5.0 Flash es el nivel rápido y económico de la familia Seedream 5.0 de ByteDance, servido aquí desde el endpoint oficial de Volcano Ark. Está pensado para trabajo de gran volumen, donde el tiempo de respuesta y el coste por imagen importan más que el último detalle de calidad: en nuestras pruebas una imagen 2K tarda unos 13 a 15 segundos y una 1K unos 10. Texto a imagen y edición comparten el mismo endpoint, con hasta 10 imágenes de referencia para ediciones de fusión. También puede editar una imagen que ya tiene fondo transparente y conservar esa transparencia: envía un PNG con canal alfa y background "transparent", y recibes un PNG con alfa listo para colocar sobre un banner o una plantilla de producto. La salida es 1K o 2K (este modelo no tiene 4K), con proporciones de 21:9 a 9:16, a $0.03 por imagen y sin marca de agua. También puede separar una imagen en una imagen base más hasta 16 capas PNG transparentes (texto, sujetos, objetos), cada una con nombre, orden de apilado y posición en el original; la separación en capas se cobra a $0.03 por imagen de salida, así que una base más 11 capas cuesta $0.36. A través de la plataforma APIMODELS puedes acceder a este modelo mediante una API unificada con precios de pago por uso transparentes. Precio actual: 1K: $0.03, 2K: $0.03.
Genera imágenes de producto de alta calidad para tiendas online, anuncios y material de marketing.
Crea contenido visual llamativo para redes sociales y aumenta la interacción y la visibilidad de marca.
Produce arte conceptual de personajes, escenarios y objetos para acelerar el desarrollo de juegos.
Diseña carteles, banners y gráficos promocionales a una fracción del coste tradicional.
Doubao Seedream 5.0 Flash está disponible a través de APIMODELS a: 1K: $0.03, 2K: $0.03. La facturación es de pago por uso: solo pagas por lo que generas.
Regístrate en APIMODELS, obtén tu clave API y llama a nuestro endpoint unificado. Ofrecemos documentación detallada con ejemplos en cURL, Python y Node.js.
APIMODELS ofrece el mismo modelo Doubao Seedream 5.0 Flash a través de nuestra plataforma de agregación. Proporcionamos una interfaz de API unificada, así que no necesitas cuentas separadas por proveedor: una sola clave para acceder a todos los modelos.
Envía un PNG o un JPEG a doubao-seedream-5-0-flash con layer_decomposition en true y el modelo lo divide en una imagen base más hasta 16 capas PNG transparentes. Cada capa tiene un nombre, una descripción de una frase, un z_index (0 es la base; los valores mayores se apilan encima) y un bounding_box tanto en píxeles absolutos como en una cuadrícula normalizada de 0–1000. resultUrls lista primero la base y después cada capa en orden de z; los mismos campos están en resultJson.layers. La documentación de ByteDance llama a la función 图层拆分 (descomposición en capas); en apimodels.app es un booleano sobre el mismo nombre de modelo que usas para texto a imagen, con una sola API key y sin cuenta de Volcengine.
$0.03 por imagen de salida, base incluida, sin ninguna tarifa aparte por la descomposición. El modelo decide cuántas capas devolver, así que la llamada de creación reserva el máximo de 17 imágenes ($0.51) y la tarea se liquida por el recuento real al completarse: un cartel que volvió como base más 9 capas costó $0.30, una división selectiva de dos elementos $0.09 y un recorte suelto $0.06. Las peticiones fallidas no devuelven nada y no se cobran; no existe el éxito parcial.
Sí: nómbralos en el prompt. "Separate only the text" sobre un cartel de concierto devolvió cuatro capas de texto y dejó la guitarra, el sol y el paisaje en la base ($0.15 en vez de los $0.30 de la división completa). "Separate the sneaker and the price tag" devolvió exactamente esas dos capas. "Separate the woman on the right" devolvió una. Omitir el prompt, o escribir "Separate every main element onto its own layer", da la división automática completa. Como pagas por imagen devuelta, los prompts selectivos son el camino económico hacia una pieza concreta.
Los nombres y descripciones los escribe el modelo y, por defecto, vuelven en chino sea cual sea el idioma de tu prompt. Añade una frase al final del prompt — "Write every layer name and description in English." — y volverán en inglés; lo mismo funciona con otros idiomas. El prompt que describe qué dividir puede estar en cualquier idioma: un prompt en chino (提取20% off的文字标签) acompañado de esa frase en inglés devolvió una capa llamada "20% OFF text badge".
No. La base es la imagen con todas las capas extraídas levantadas y los huecos rellenados. Un cartel de cafetería dividido en nueve capas volvió con una cartulina crema vacía como base; una división de solo texto volvió con la zona del título repintada como cielo; el recorte de una persona volvió con la sala que tenía detrás rellenada. Trata la base como contenido generado y revísala antes de entregarla, sobre todo detrás de personas y productos: el modelo está inventando lo que estaba oculto, no recuperándolo.
Porque Seedream 5.0 Flash renderiza cada capa a su propia resolución, mayor que la caja que ocupa en la base: entre dos y cuatro veces por lado en todas las ejecuciones que medimos (una caja de logo de 439×70 px volvió como un PNG de 1801×287 px), conservando la proporción. Al componer, escala cada capa a bounding_box.absolute y caerá exactamente donde estaba; conserva el PNG original y tendrás margen para ampliar ese elemento más adelante sin necesidad de reescalar.
No en apimodels.app: la descomposición en capas y la edición con fondo transparente se ofrecen solo en doubao-seedream-5-0-flash. Seedream 5.0 Pro es el nivel para la edición interactiva por región y el texto denso dentro de la imagen ($0.03 en 1K, $0.06 en 2K), y Seedream 5.0 Lite es el generalista 2K/4K a $0.055. Los tres responden en el mismo endpoint con los mismos parámetros, así que un pipeline puede dividir con Flash y editar con Pro cambiando únicamente la cadena de model.
Nuestras ocho ejecuciones tardaron entre 25 y 74 segundos — más o menos 25 segundos más unos tres por capa — frente a los 10–15 segundos de una imagen normal de Seedream 5.0 Flash. La llamada es asíncrona: la creación devuelve un taskId de inmediato; después consulta GET /v1/images/generations?task_id=… o pasa un callback_url. Pon los timeouts del cliente en al menos 180 segundos. Los enlaces de resultado son temporales, así que copia la base y las capas a tu propio almacenamiento en cuanto se complete la tarea.
En APIMODELS, Doubao Seedream 5.0 Flash convive con más de 60 modelos bajo una sola clave API y un solo saldo, así que elegir es cuestión de ajuste, no de dependencia. Admite Fast (~10–15s), Keeps PNG Transparency, Layer Decomposition (up to 16 layers), Multi-Image (up to 10), Aspect Ratio 21:9 to 9:16, 1K / 2K, $0.03/image y puedes valorarlo en precio y capacidad frente a otros modelos de generación de imágenes, y cambiar modificando una sola cadena con el nombre del modelo: sin nueva cuenta ni integración. Explora todas las opciones de generación de imágenes con precios en vivo en apimodels.app/models.
Doubao Seedream 5.0 Flash admite: Fast (~10–15s), Keeps PNG Transparency, Layer Decomposition (up to 16 layers), Multi-Image (up to 10), Aspect Ratio 21:9 to 9:16, 1K / 2K, $0.03/image. Consulta la documentación de APIMODELS para ver todos los parámetros y ejemplos de llamada.
Sí. APIMODELS expone Doubao Seedream 5.0 Flash mediante una única API unificada y una sola clave, sin cuentas separadas por proveedor ni necesidad de gestionar tú mismo el acceso de red regional de cada proveedor.
Aceptamos Stripe (Visa, Mastercard y otras tarjetas internacionales) y Alipay. El saldo está disponible al instante tras el pago.
Un uso típico del modo de separación en capas: herramientas que separan una foto o un cartel en capas con nombre y exportan cada una como PNG o PSD, para mover el titular o cambiar el producto sin redibujar el resto.
Prompts shared by their authors — copy and adapt them. Each one credits its author and links back to the original post.
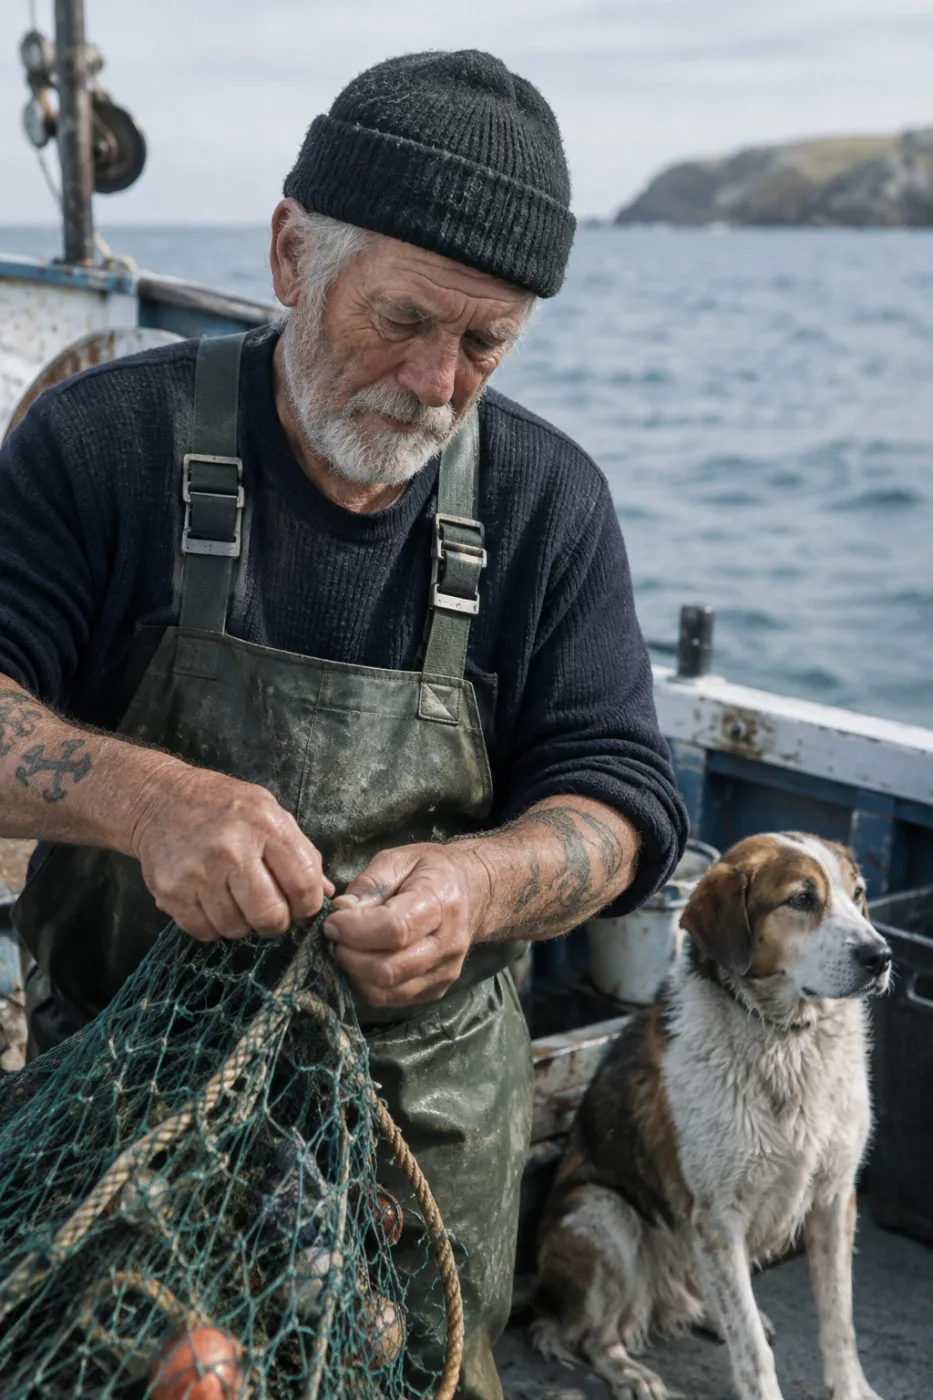
Weathered sailor on a fishing boat
Create a photorealistic candid photograph of an elderly sailor standing on a small fishing boat. He has weathered skin with visible wrinkles, pores, and sun texture, and a few faded traditional sailor tattoos on his arms. He is calmly adjusting a net while his dog sits nearby on the deck. Shot like a 35mm film photograph, medium close-up at eye level, using a 50mm lens. Soft coastal daylight, shallow depth of field, subtle film grain, natural color balance. The image should feel honest and unposed, with real skin texture, worn materials, and everyday detail. No glamorization, no heavy retouching.
by OpenAI
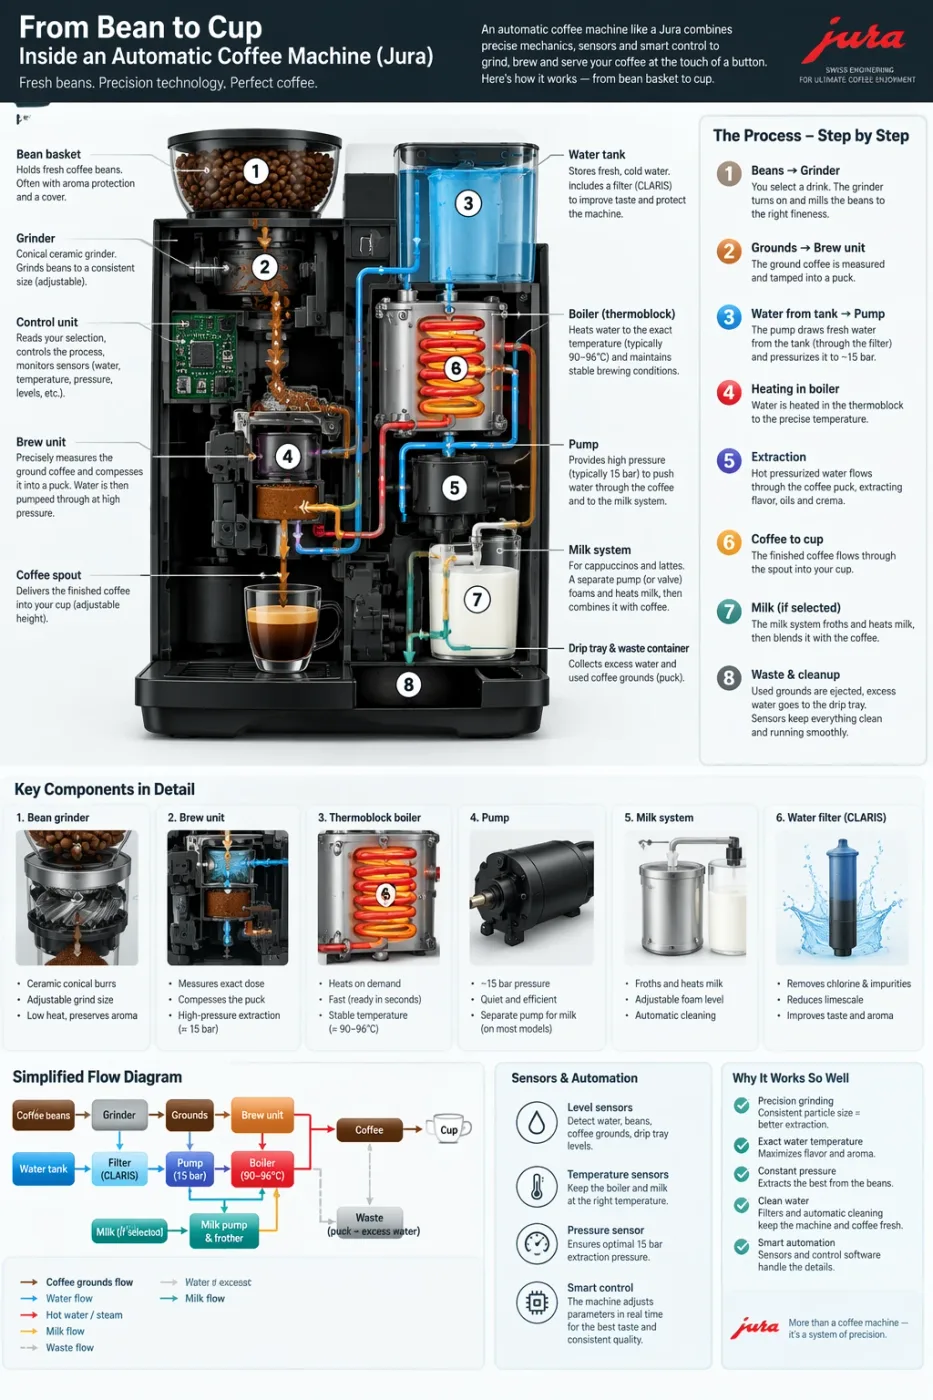
Automatic coffee machine workflow infographic
Create a detailed Infographic of the functioning and flow of an automatic coffee machine like a Jura. From bean basket, to grinding, to scale, water tank, boiler, etc. I'd like to understand technically and visually the flow.
by OpenAI
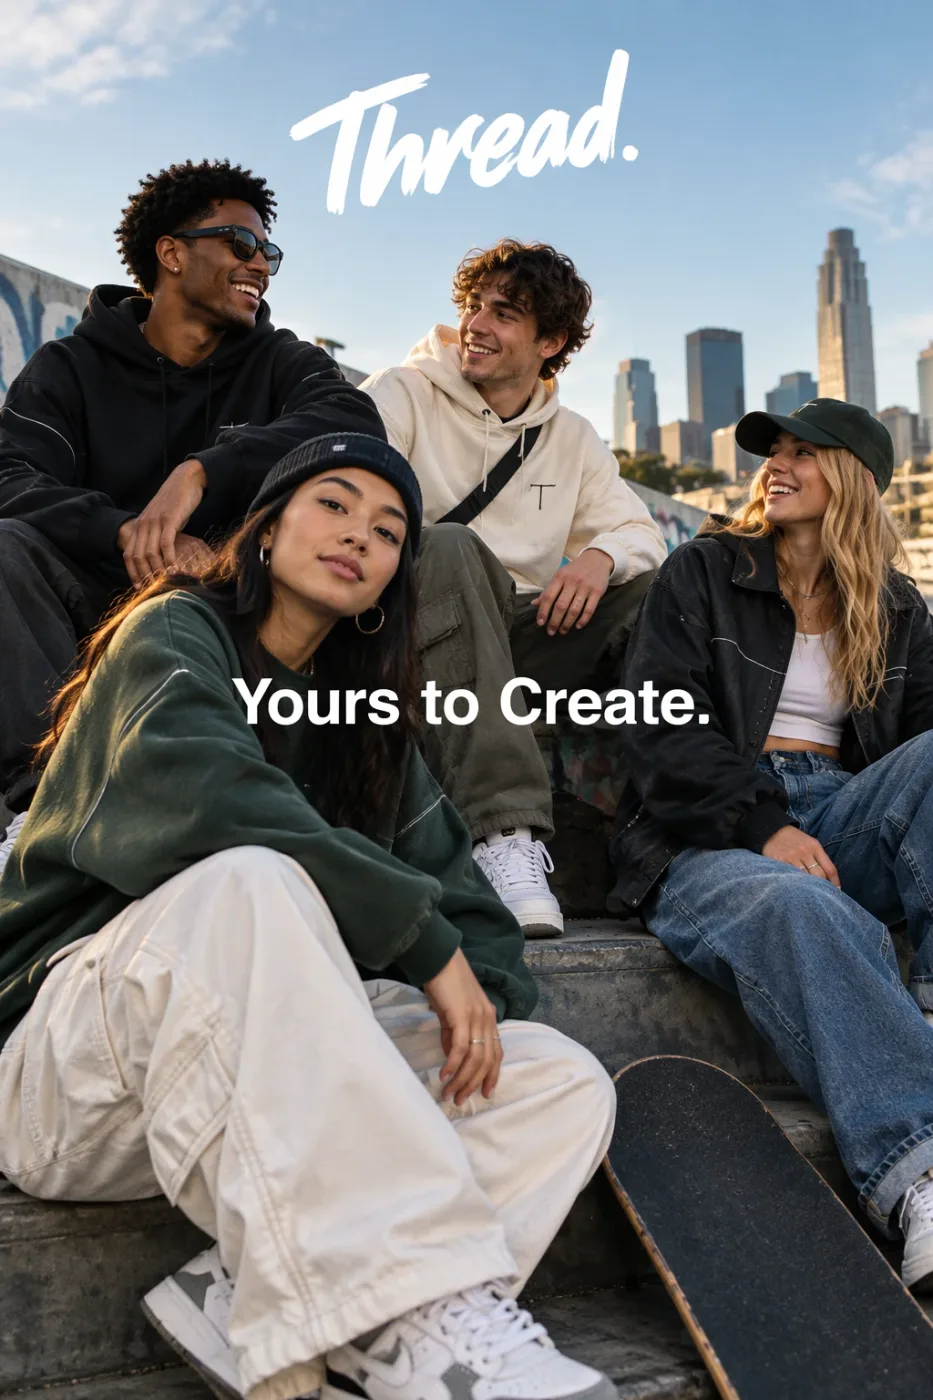
Thread streetwear ad with exact typography
Give me a cool in culture ad / fashion shot for a brand called Thread. It's a hip young street brand. The ad shows a group of friends hanging out together with the tagline "Yours to Create." Make it feel like a polished campaign image for a youth streetwear audience: stylish, contemporary, energetic, and tasteful. Use clean composition, strong color direction, natural poses, and premium fashion photography cues. Render the tagline exactly once, clearly and legibly, integrated into the ad layout. No extra text, no watermarks, no unrelated logos.
by OpenAI
We curate copy-ready prompt libraries — every entry shows its full text and a sample result, ready to adapt.
How to get access, regional availability, and how this model compares with its alternatives.
