
博客 · 2026-11-11
Fable 5.2 和 Opus 5.5 哪个好:Fable 多抓到别人漏的 bug,Opus 同样的活花得更少
模型页:Claude Fable 5.2 API · Claude Opus 5.5 API —— 价格、规格与在线体验
Claude Fable 5.2 和 Claude Opus 5.5 怎么选?两个都是 Anthropic 的模型。Fable 5.2 是 11 月 9 日发布的最强公开款,在官方跑分上几乎每项都赢,开发者的公开实测里也更会抓 bug、做代码审查。但它每 token 贵一倍、想得更久,同一个任务要多花 1.6 到 3.7 倍。本站 Fable 5.2 每百万 token $4.80 / $24,Opus 5.5 $2.40 / $12。日常活用 Opus,难修的 bug 和审查交给 Fable。
Claude Fable 5.2 是 Anthropic 在 2026 年 11 月 9 日发布的新一代 Fable,接替 Fable 5.1:官方价比 5.1 降了 20%,输出速度比 5.1 最多快 30%。Claude Opus 5.5 是 9 月 22 日发布的 Claude 5.5 家族第一款,Anthropic 当时的说法是:多数工作能做到 Fable 5.1 的水平,运行成本比 Opus 5 低 40%。两个模型规格一样:100 万 token 上下文,单次最多输出 12.8 万 token,输入支持文字和图片,思考一直开着、关不掉。
搜这两个模型的人,问得最多的是:哪个更强,一个任务要花多少钱,会不会更费 token,速度怎么样,写代码和写文章各选谁。这篇没有自己出题打分,而是把能核实的材料放在一起:Anthropic 发布时公布的跑分;发布后两天里开发者公开发出来的对比实测和 X 上的使用反馈,每一条我们都回到原帖核对过数字;再加上我们平台上两个模型的真实调用耗时。
先交代一下我们是谁:我们运营 apimodels.app,一个用同一个 API Key 就能调用 Claude Fable 5.2、Claude Opus 5.5 以及其他图像、视频、音频和语言模型的平台。文中的价格是本站 2026 年 11 月 11 日的现价;耗时数据来自平台上的生产调用,样本量不公开,已剔除我们自己的账号;第三方测试和用户反馈都注明了出处,数字以原帖为准。
先说结论
日常的编程工单,两个模型差不多。目前最完整的一份公开对比,是 paddo.dev 在一个真实 TypeScript 项目上让两个模型各跑 52 次:前两组改动两边通过数一模一样,一组 13 次对 13 次,另一组 4 次对 4 次。
差别出在难的地方。还是这份测试,让两个模型审查同一份「测试已通过」的修复,Fable 4 次都指出了里面的漏洞,Opus 只指出 1 次;另一位开发者让两个模型在同一个插件里找 bug,两边找到同样 6 个,但 Fable 多翻了几个文件,又多找到一个面板错误。代价是钱和时间:Fable 每 token 的价格是 Opus 的两倍,又更爱多想、多派子任务,公开实测里同一个任务要多花 1.6 到 3.7 倍,用时也常常长一倍以上。
在 apimodels.app,Fable 5.2 每百万 token 输入 $4.80、输出 $24,Opus 5.5 是 $2.40 / $12,都比 Anthropic 官方价低 40%,缓存读取两个都是 $0.12。一句话:Opus 5.5 当主力,难修的 bug、代码审查和大任务的规划交给 Fable 5.2。这和 Anthropic 自己的建议一致:多数编程和知识工作先从 Opus 5.5 开始。
两个模型有什么不同
- 价格:Fable 5.2 每百万 token $4.80 / $24,Opus 5.5 $2.40 / $12,输入输出都是两倍;缓存读取两个都是 $0.12,缓存写入 $6.00 对 $3.00。
- 默认思考深度:直接调 API 时,Fable 的 effort 默认是 high,Opus 默认是 medium;Claude Code 和 Claude 应用里两个都默认 medium。不设 effort 就拿来比,Fable 天然会想得更多、花得更多。
- 规格:两个都是 100 万 token 上下文、单次最多 12.8 万 token 输出、文字加图片输入、思考常开。
- 定位:Anthropic 建议多数编程和知识工作先用 Opus 5.5;Fable 留给最难、最开放的技术活,也可以当 Opus 的「顾问」,或者给小模型分派任务的「编排者」。
- 参数:Fable 5.2 不再接受 temperature、top_p、top_k,在本站传了会被自动去掉。靠这几个参数调风格的,换过去要留意。
跑分:Fable 几乎每项都领先,差距最大的是长时间任务
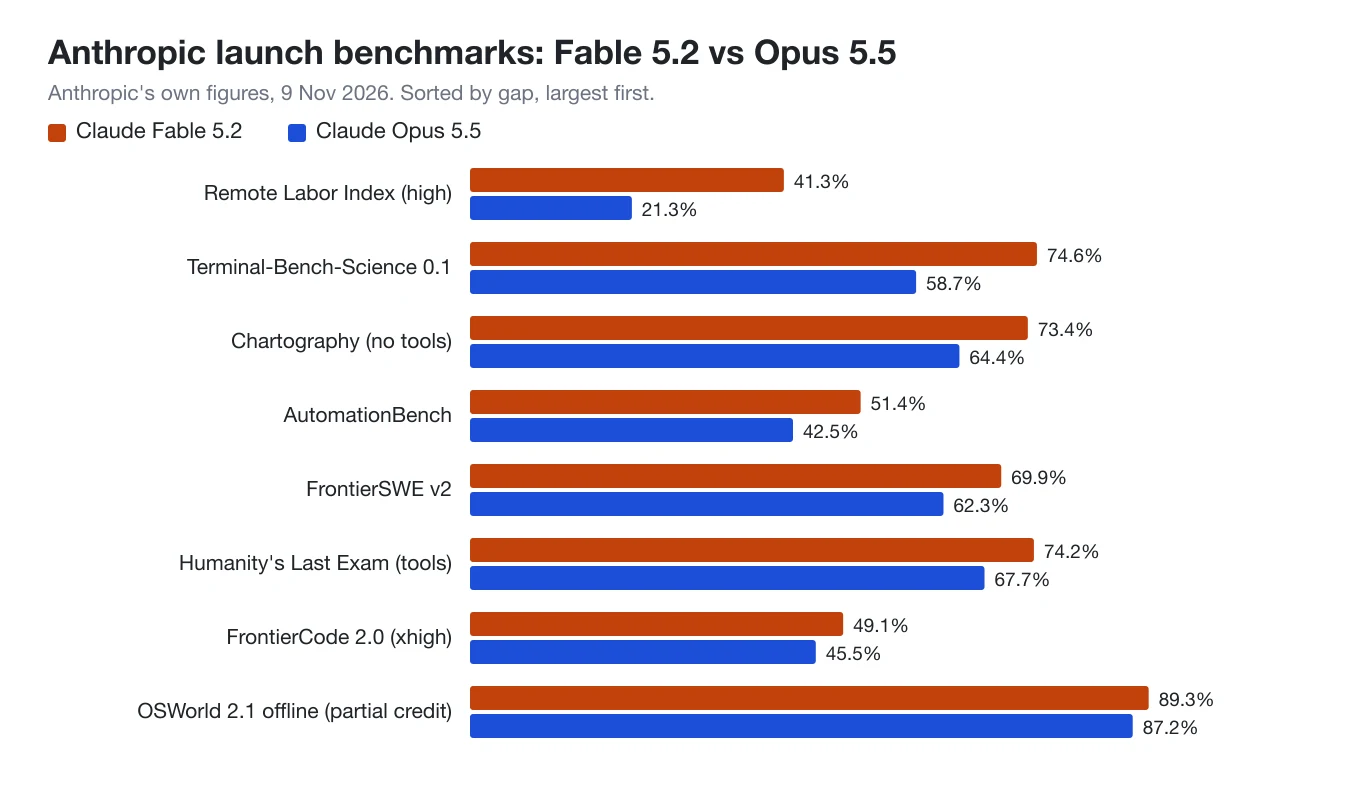
按 Anthropic 发布时的表,Fable 5.2 在每一项上都高于 Opus 5.5,但差距大小很不一样。差得最多的是 Remote Labor Index,41.3% 对 21.3%,几乎翻倍:这项测的是把真实的远程外包项目从头做到尾。科研类终端任务 Terminal-Bench-Science 是 74.6% 对 58.7%,不带工具读图表 Chartography 是 73.4% 对 64.4%。
差距最小的恰好是大家最关心的写代码:FrontierCode 2.0 是 49.1% 对 45.5%(都开到 xhigh),FrontierSWE v2 是 69.9% 对 62.3%;OSWorld 2.1 离线集 89.3% 对 87.2%,而且这项是按步骤给分,不是任务完整做完的比例。Anthropic 还给了一个口径:Fable 开 high 档在 FrontierCode 上拿到 45.3%,和 Opus 开到最高档的 45.5% 基本一样,每个任务的成本约为一半。这些都是 Anthropic 自己报的数,适合当起点,不适合当结论。
写代码:日常工单打平,难修的 bug 和代码审查 Fable 更强
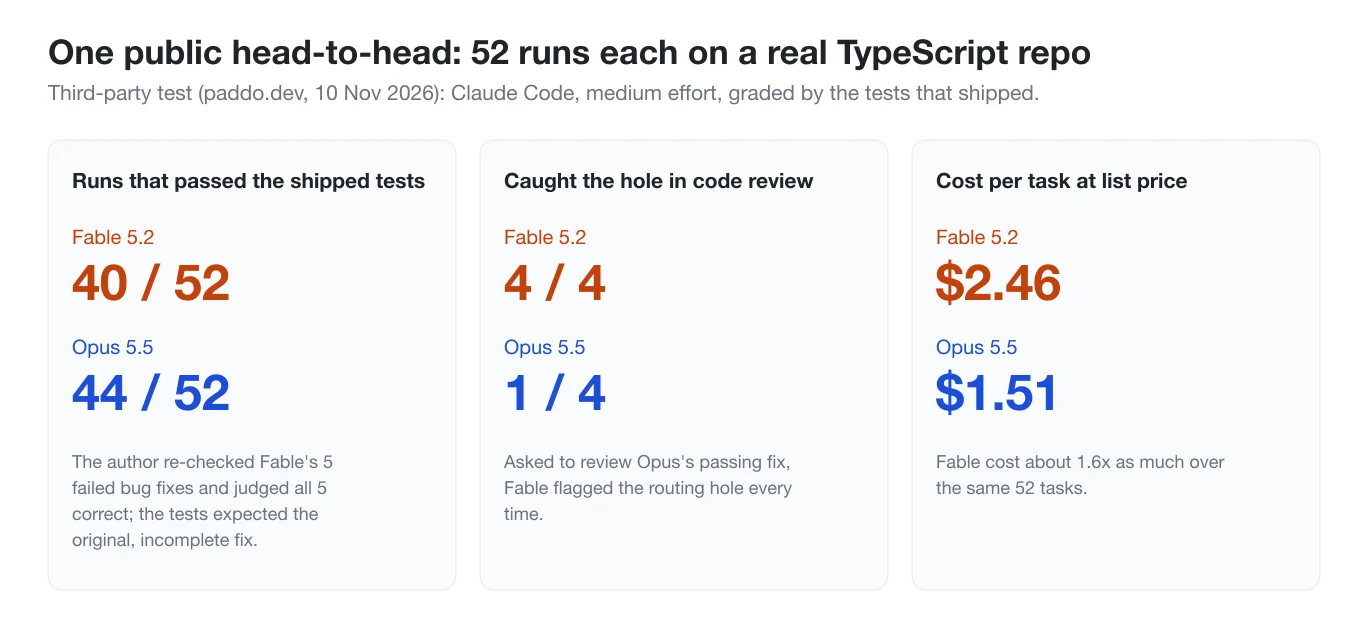
paddo.dev 11 月 10 日发的这份对比做得最扎实:在一个约 3,700 个文件的生产级 TypeScript 项目里,把已经合并的真实改动从干净快照重放一遍,用 Claude Code、两个模型都用默认的 medium 档,各跑 52 次,按项目原本自带的测试打分。前两组改动两边打平。第三组只给「症状」的 bug 报告里,按测试算 Opus 过了 27 次,Fable 过了 23 次。
但作者逐个看了 Fable 没通过的那 5 次,结论是这 5 次其实都修对了:Fable 顺手多改了一处工单没要求的地方,测试只认最初那版修复,所以判它失败。而人工团队当初漏掉的正是这一处,四天后又补了一次提交。让两个模型审查 Opus 那份「测试通过」的修复,Fable 4 次都指出了这个漏洞,Opus 只有 1 次。作者的建议是:日常工单用 Opus,修错代价高的改动(涉及钱、路由、对接外部系统)和代码审查用 Fable。
其他几份单人测试方向一致。Octavio Aranda 让两个模型在他的插件里找 bug、复现并给出修复,两边找到同样 6 个;Fable 多看了几个文件,多找到一个面板错误,但用了 6.6 分钟、约 $2.78,Opus 是 2.9 分钟、约 $0.76。交叉跑对方写的测试时,Opus 的修复全部通过,Fable 的有一条没过。他继续用 Opus 当默认,卡住了再请 Fable。Charlie Hills 做了 7 个一次成型的小项目,Fable 几乎每个都赢,每个项目要多花 2 到 3 倍。Peter Yang 拿到了提前体验资格,做了五项非正式对比,包括 3D 卡丁车小游戏和网站改版,Fable 赢了其中四项。
这对实际使用意味着什么:如果你的流程只看测试过没过,Fable 的优势可能被低估,它多做的那一步有时正是测试没覆盖到的。反过来,如果工单写得清楚、测试也全,Opus 用一半的钱就能交出同样的结果。
一个任务多少钱:按 token 贵一倍,按任务贵 1.6 到 3.7 倍
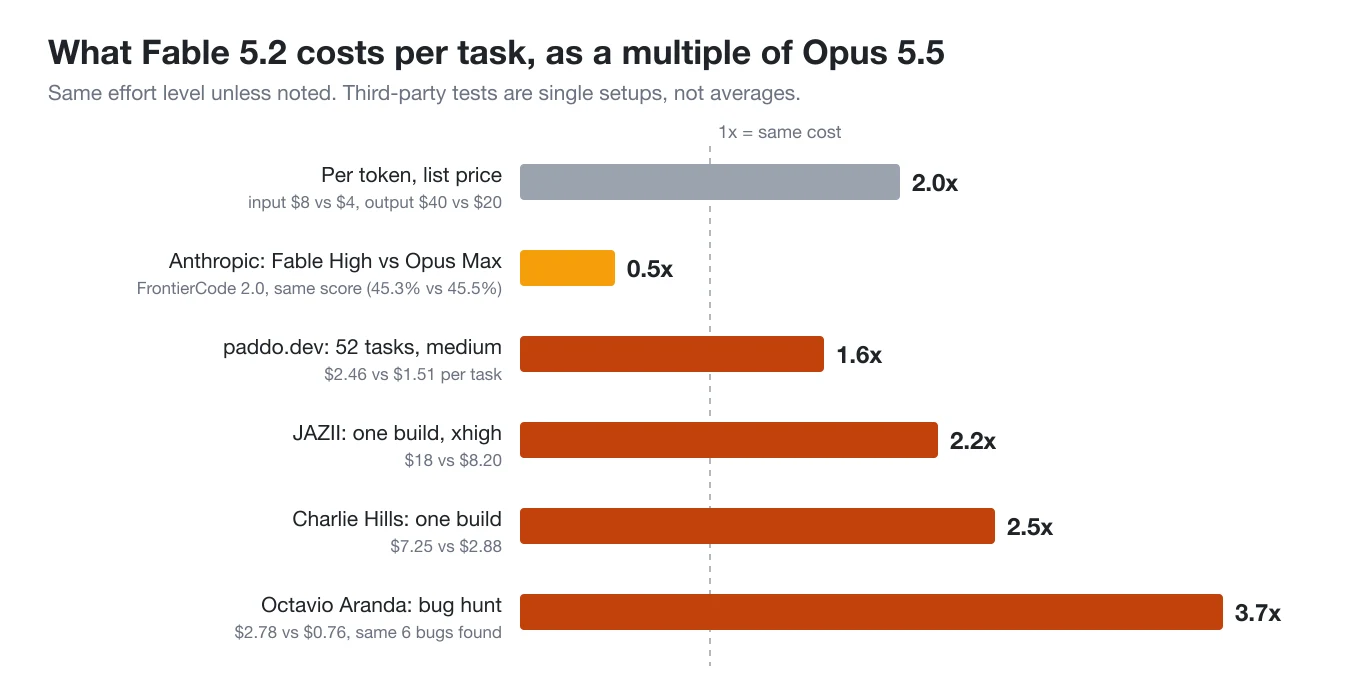
单价上,Fable 的输入和输出都正好是 Opus 的两倍。按任务算差得更多,因为 Fable 想得更久、写得更多,还更爱拆出子任务。公开测试里,同一个任务 Fable 的花费是 Opus 的 1.6 倍(paddo.dev,52 个任务,medium 档)、2.2 倍(JAZII,xhigh 档做一个项目,$18 对 $8.20)、2.5 倍(Charlie Hills 一个项目,$7.25 对 $2.88)、3.7 倍(Octavio Aranda 找 bug,$2.78 对 $0.76)。Anthropic Claude Code 团队的 Addy Osmani 也说,Fable 5.2 很耗 token,虽然单价比 5.1 降了 20%,按任务算和 5.1 差不多贵。
那 Anthropic 说的「成本约一半」是怎么回事?它比的是 Fable 开 high 档和 Opus 开到最高的 max 档:要拿到同样的分数,Opus 得开到最高档、想得非常久,这时 Fable 反而省钱。开发者的测试是两边用同一档位,Fable 自然更贵。所以两个说法都对,区别在于你是想用 Opus 去追 Fable 的上限,还是让两个模型做同一件普通的事。
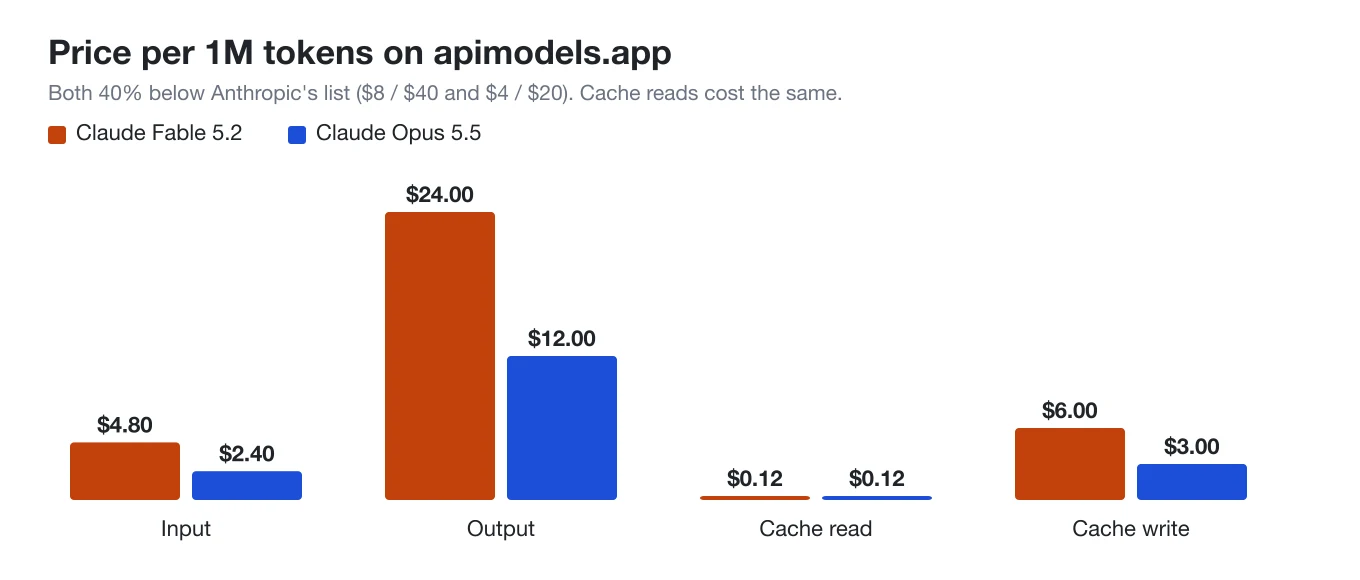
还有一点对 agent 用户有利:在本站,两个模型的缓存读取都是每百万 token $0.12。拿一个常见的 agent 回合算一笔账:8 万 token 的上下文命中缓存,新输入 2,000 token,输出 1,500 token。Opus 5.5 这一回合约 3.2 美分;Fable 5.2 输出一样多时约 5.5 美分,是 1.7 倍,不到两倍,因为大头的缓存部分两边同价;如果 Fable 多写一倍、输出 3,000 token,就是约 9.1 美分,2.8 倍。所以真正拉开差距的是 Fable 写出来的 token 有多少,而不是上下文有多长。
速度:Fable 不是出字慢,是想得多
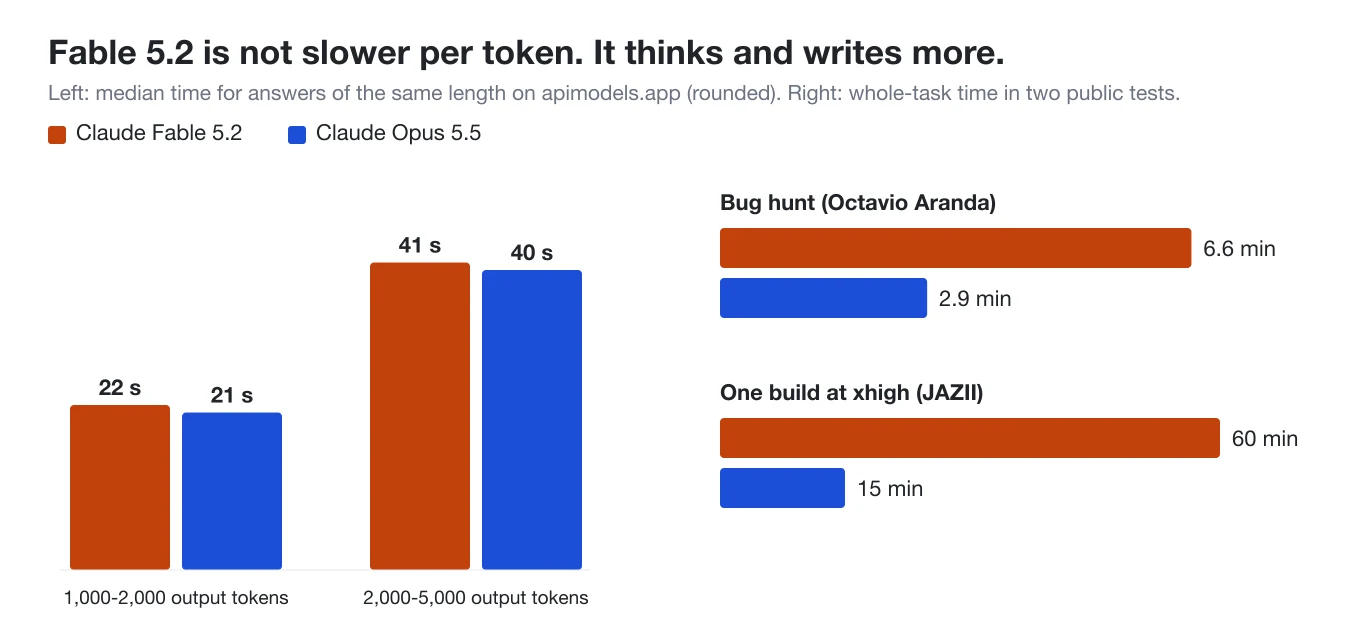
看我们平台上的真实调用,同样长度的回答,两个模型用时几乎一样:输出 1,000 到 2,000 token 的回答,中位数约 22 秒对 21 秒;2,000 到 5,000 token 约 41 秒对 40 秒。Fable 5.2 上线才两天,调用还不多,这个结论先当参考,但方向很清楚:它生成文字的速度并不慢。
慢在它想得多、写得多。Octavio Aranda 的找 bug 任务,Fable 用了 6.6 分钟,Opus 2.9 分钟;JAZII 两边都开到 xhigh 做同一个项目,Opus 约 15 分钟,Fable 约 60 分钟,光开工前就先想了约 20 分钟,最后两边结果差不多,Fable 的细节更多。要快一些,可以给 Fable 把 effort 调到 medium 或 low,并用流式输出,先看到的字会早很多。
写文章:说法不一
写作上的反馈互相矛盾。微软研究员 Dimitris Papailiopoulos 在 X 上直接说,Fable 5.2 写得不如 Opus 5.5。Peter Yang 的五项对比里有一项是写一篇 600 字、不带套话的短文,Fable 总共赢了四项,但他没在帖子里说 Opus 赢的是哪一项,所以写作这一项谁赢并不清楚。Anthropic 的跑分也没有专门测写作。
写文案、改稿这类活,我们的建议是先用 Opus 5.5:费用是一半,目前也没有证据说 Fable 写得更好。真在意文风,就拿自己的三五个真实提示词两边各跑一遍,同一个 API Key 改一下模型名就能比。
两个一起用:Opus 干活,Fable 把关
X 上讨论最多的用法,不是二选一,而是搭配。Anthropic 这次也把它做成了正式用法:Fable 5.2 可以当「顾问」,让 Opus 或更小的模型在难点上请教它;也可以当「编排者」,把简单的子任务分给小模型。Charlie Hills 在同一个提示词上算过账:只用 Opus $2.88,Opus 干活、Fable 当顾问 $3.88,只用 Fable $7.25。多花一美元,换到了大部分 Fable 的好处。
通过 API 也能这样搭:主循环用 claude-opus-5-5,改完代码再把改动交给 claude-fable-5-2 审一遍;或者反过来,先让 Fable 拆任务、写计划,再让 Opus 一条条执行。在 apimodels.app 上两个模型用同一个 API Key,换模型只改 model 字段,Claude Code 里的配置见 Claude Code 接入文档。
到底该选哪个
- 日常编程工单、加功能、改常规 bug:Opus 5.5。公开测试里结果相同,花费约 60%。
- 修错代价高的改动(钱、路由、对接外部系统):Fable 5.2。它更常把工单没写到的那一步也补上。
- 代码审查:Fable 5.2。审 Opus 的修复时 4 次全找到漏洞,Opus 自己审只有 1 次。
- 大任务的规划、拆分,长时间无人值守的 agent:Fable 5.2。Remote Labor Index 和 Terminal-Bench-Science 上差距最大。
- 要求响应快、调用量大:Opus 5.5。同长度回答不慢,但 Fable 每件事想得更久。
- 写文案、改稿:先用 Opus 5.5,费用一半,写作上的评价目前不一。
- 预算固定又想要 Fable 的眼光:Opus 干活,Fable 当顾问或审查。
两个模型在 apimodels.app 的调用名分别是 claude-fable-5-2 和 claude-opus-5-5,原生 /v1/messages 和 OpenAI 兼容接口都能用,失败的调用不扣费。接口和参数见 LLM 文档,价格以模型页为准:Claude Fable 5.2、Claude Opus 5.5。
相关模型
- Claude Fable 5.1:上一代 Fable,本站每百万 token $5 / $25,比 Fable 5.2 还高一点,新项目直接用 5.2。
- Claude Sonnet 5.5:每百万 token $1.20 / $6,比 Opus 5.5 再省一半,适合量大、要求快的编码任务。
- Claude Haiku 5.5:每百万 token $0.09 / $0.45,适合分类、抽取这类高并发的轻任务,也适合给 Fable 当子代理。
- GPT-6 Astra:OpenAI 的旗舰,每百万 token $3.40 / $17,强项是长时间运行的终端和运维类 agent。
想看 OpenAI 这边旗舰和主力模型的同类对比,可以看 GPT-6 Astra 实测:同一批日常任务里,贵 3.4 倍的 Astra 和 GPT-6.1 Sol 打成平手,结论和这篇很像,日常用主力款,难活再换旗舰。
常见问题
Fable 5.2 比 Opus 5.5 强吗?
在 Anthropic 公布的八项跑分上,Fable 5.2 每项都高于 Opus 5.5,差距最大的是 Remote Labor Index(41.3% 对 21.3%),写代码的 FrontierCode 2.0 差距最小(49.1% 对 45.5%)。开发者的公开测试里,日常工单两边结果相同,难修的 bug 和代码审查 Fable 更强。
Fable 5.2 和 Opus 5.5 各多少钱?
Anthropic 官方价是 Fable 5.2 每百万 token $8 / $40,Opus 5.5 $4 / $20。在 apimodels.app 分别是 $4.80 / $24 和 $2.40 / $12,都低 40%,缓存读取两个都是每百万 token $0.12。按单个任务算,公开测试里 Fable 的花费是 Opus 的 1.6 到 3.7 倍。
Fable 5.2 会比 Opus 5.5 更费 token 吗?
会。Fable 想得更久、写得更多,也更爱拆出子任务;直接调 API 时它的 effort 默认是 high,Opus 默认是 medium。想省 token,可以把 Fable 的 effort 调到 medium 或 low,或者只在审查、规划这类步骤用它。
写代码选 Fable 5.2 还是 Opus 5.5?
日常工单选 Opus 5.5:一份 52 次的公开测试里,两边按测试的通过数接近,Opus 每个任务 $1.51,Fable $2.46。难修的 bug、改错代价高的代码和代码审查选 Fable 5.2:同一份测试里它审查时 4 次都找到漏洞,Opus 只有 1 次。
能用一个 API Key 同时调用 Fable 5.2 和 Opus 5.5 吗?
可以。在 apimodels.app 用同一个 API Key,调用名分别是 claude-fable-5-2 和 claude-opus-5-5,支持原生 /v1/messages 和 OpenAI 兼容接口,Claude Code 也能直接切换。失败的调用不扣费。