
博客 · 2026-11-07
GPT-6 Astra API 实测:和 GPT-6.1 Sol 跑同一批任务,贵 3.4 倍买到了什么
模型页:GPT-6 Astra API —— 价格、规格与在线体验
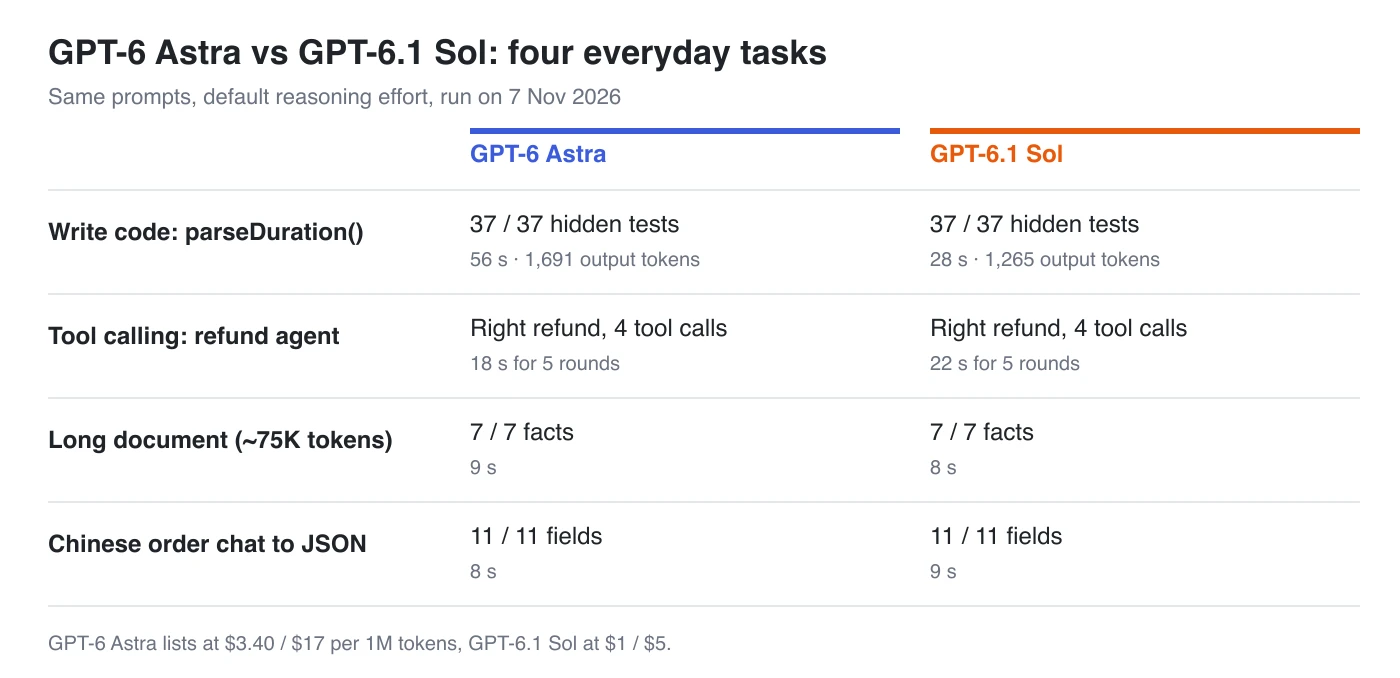
GPT-6 Astra 值不值得用?它是 OpenAI GPT-6 这一代的旗舰,强项是长时间运行的终端和运维类 agent、50 万 token 以上的超长材料和很难的数理题。我们 11 月 7 日让它和 GPT-6.1 Sol 跑同一批日常任务:写代码、调工具、7.5 万 token 长文找信息、中文聊天转 JSON,两个模型全部答对,Astra 还慢了一截。它每百万 token $3.40 / $17,是 6.1 Sol 的 3.4 倍,日常活用 Sol,难活再换 Astra。
GPT-6 Astra 是 OpenAI 在 2026 年 9 月发布的 GPT-6 旗舰模型。同一代还有均衡的 Sol 和走量的 Luna,9 月底又出了升级版 GPT-6.1 Sol。Astra 已经可以通过 API 调用:上下文 105 万 token,单次最多输出 12.8 万 token,输入支持文字和图片。
搜 Astra 的人问得最多的是两件事:多少钱,以及和 GPT-6.1 Sol 比哪个强。Astra 的单价是 6.1 Sol 的 3.4 倍,所以真正要回答的是:多花的钱买到了什么。我们用同样的提示词、默认推理强度,让两个模型各做了四道日常任务,又看了平台上真实用户调用这两个模型要等多久。
先交代一下我们是谁:我们运营 apimodels.app,一个用同一个 API Key 就能调用 GPT-6 Astra、GPT-6.1 Sol 以及其他图像、视频、音频和语言模型的平台。文中的四道题都在这个平台上实际调用,时间是 2026 年 11 月 7 日;耗时分布来自平台近 30 天的生产调用,样本量不公开,已剔除我们自己的账号。
先说结论
四道日常任务,两个模型打平:写代码那题 37 条隐藏用例全过,调工具的退款流程都走对了,7.5 万 token 长日志里的 7 个答案都找对了,中文下单聊天转 JSON 的 11 个字段也都对。差别在时间上:写代码那题 Astra 用了 56 秒,6.1 Sol 用了 28 秒;真实用户的调用里,同样长度的回答,Astra 也要多等三到五成的时间。
Astra 的长处在这四道题够不着的地方。OpenAI 公布的成绩里,它在终端任务(Terminal-Bench 4.0 57.7%)、运维排障(SRE-Bench 88.0%)和 50 万到 100 万 token 的长文检索(MRCR v2 八针 96.3%)上都明显领先上一代。但单论写代码,它在 DeepSWE v1.1 上是 74.1%,反而比 6.1 Sol 的 75.2% 略低。
所以选法很简单:日常写代码、结构化抽取、三五步的工具调用,用 6.1 Sol,一次典型调用的费用约是 Astra 的四分之一;要跑几十步的终端或运维 agent、要一次读几十万 token 的材料,或者要啃很难的数理题,再换 Astra。
能做什么、有哪些限制
- 规格:上下文 1,050,000 token,单次最多输出 128,000 token;输入文字和图片,输出文字。
- 工具:函数调用、内置网页搜索(web_search)和代码解释器(code_interpreter)都能用,我们 9 月 6 日逐项实测过;chat/completions 和 responses 两个接口都支持函数调用。
- 用不了的工具:Computer Use(让模型自己操作电脑或浏览器)和 file_search 在 apimodels.app 的 API 上用不了。宣传里很亮眼的 OSWorld 2.0 72.6% 靠的正是 Computer Use,别把它算进选 Astra 的理由。
- 推理强度可调:写代码那题把推理强度调成 low,耗时从 56 秒降到 28 秒,推理 token 从 696 降到 214,37 条用例照样全过。
- 长上下文加价:单次输入超过 272,000 token 时,整个请求按输入 2 倍、输出 1.5 倍计费,不只是超出的那部分。
- ARC-AGI-3 的 99.9%:这个成绩要靠 OpenAI 自己的有状态适配器,直接调 API 拿不到。
- 长回答要开流式:输出几千 token 的请求可能要等几分钟,非流式请求等太久会超时。
写代码:37 条隐藏用例都过了,Astra 多花了一倍时间
第一道题让模型写一个 JavaScript 函数 parseDuration,把各种写法的时长换算成秒:「1h30m」「90 min」「1.5 hours」,ISO 8601 的「PT1H30M」,时钟写法「1:02:03」。该报错的地方也要报错,比如「P1M」(在 ISO 写法里,M 写在 T 前面是月,写在 T 后面才是分钟,而月份不支持),以及「1:60」这种秒数越界的写法。判分用的是我们自己准备的 37 条用例,模型看不到。
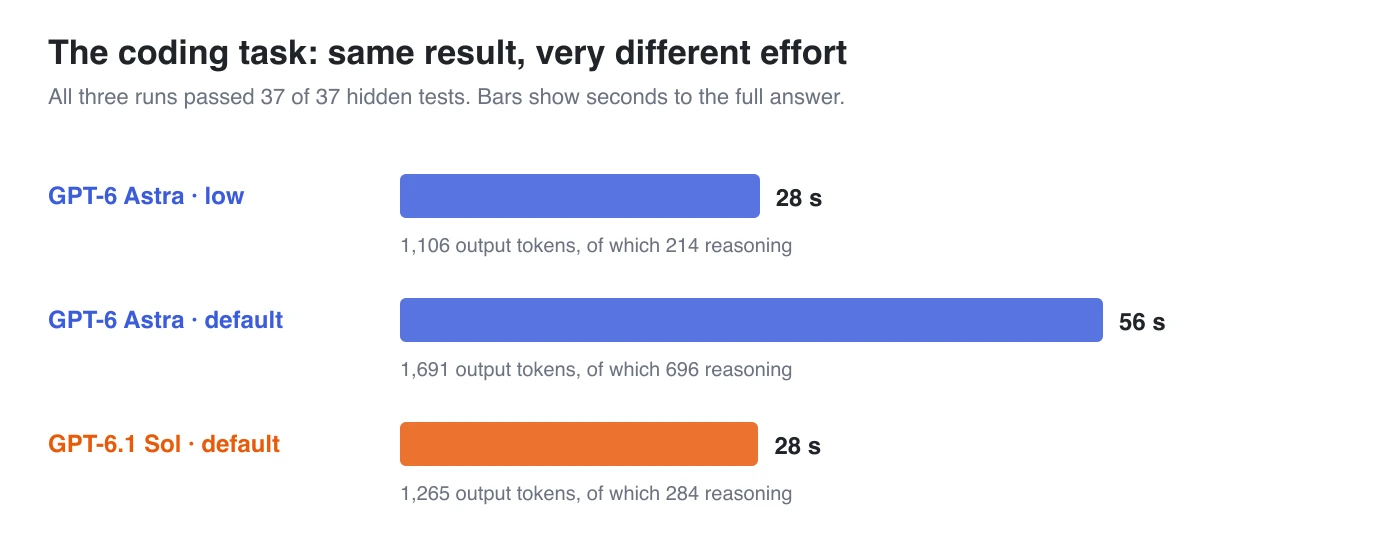
两个模型都一次写对,代码长度也差不多(Astra 152 行,6.1 Sol 134 行)。差别在花了多少力气:默认推理强度下,Astra 想了 696 个推理 token、56 秒交卷,6.1 Sol 想了 284 个、28 秒交卷。把 Astra 的推理强度调成 low,它同样 28 秒交卷、37 条全过。这道题的难度,显然还没到需要 Astra 多想的程度。
同一天早些时候,我们用同一个提示词先跑过一轮。那一轮 6.1 Sol 漏了一条:「1:60」本该报错,它算成了 120 秒;Astra 两轮都全对。边界条件多的代码,Astra 稍微稳一点,但这点差距靠一组单元测试就能补上。10 月我们还做过一轮数据分析测试,让模型写 pandas 脚本并列出预期结果,6.1 Sol 自己列的预期结果表里错了 3 个数,Astra 的 12 个数全对,脚本本身两边都对。
调工具:退款客服四步走对,两个模型一模一样
第二道题是一个客服退款 agent。系统提示里写了规则:只退已签收订单里的商品,单次退款超过 $100 要转人工,运费不退,只退客户说坏了的东西。客户说:「我最近一单昨天(11 月 6 日)到了,陶瓷台灯碎了,蜡烛没事。」我们给了查客户、查订单列表、查订单明细、退款、转人工五个工具,并埋了一个坑:最新的一单 A1050 还在处理中,里面恰好也有一盏陶瓷台灯。
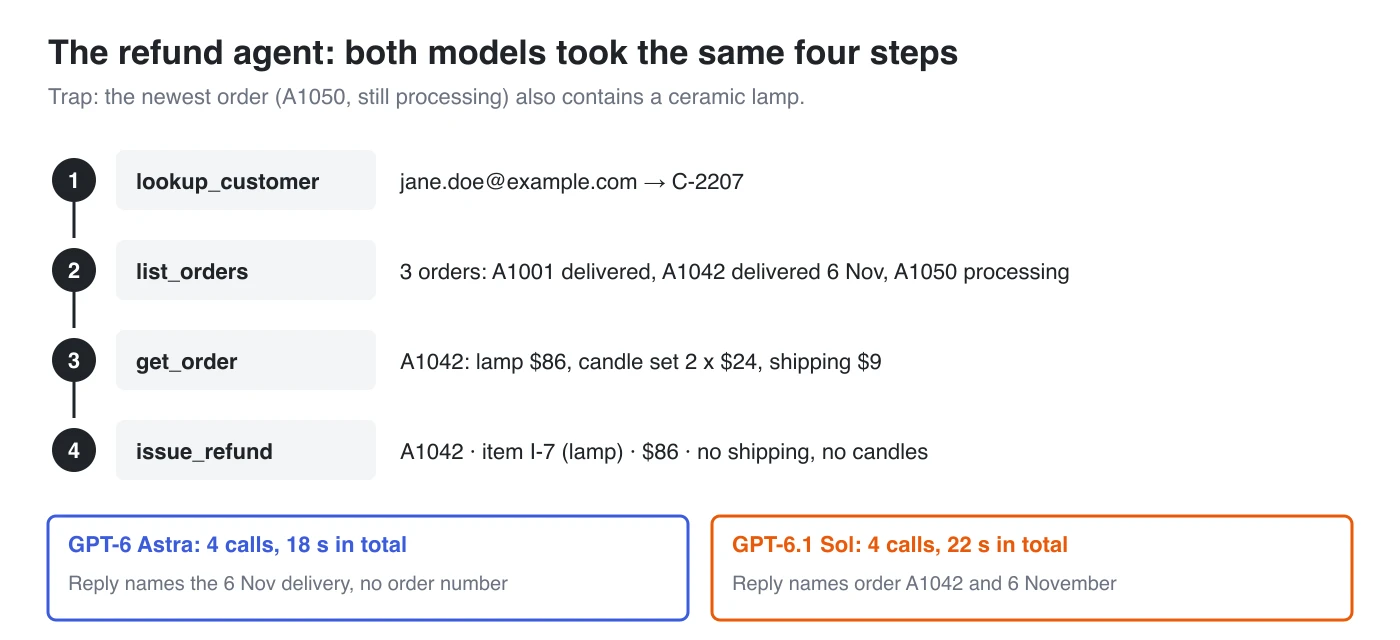
两个模型走的四步完全一样:查到客户编号,列出三笔订单,认出 11 月 6 日签收的是 A1042 而不是更新的 A1050,打开 A1042 的明细,只给台灯退了 $86,没碰蜡烛和 $9 运费,也没多余地转人工。五轮对话 Astra 合计 18 秒,6.1 Sol 22 秒。最后给客户的回复只差一个细节:Sol 写出了订单号,Astra 只提了签收日期。
三五步的工具调用,6.1 Sol 已经够用。Astra 在官方成绩里拉开差距的,是几十步、要在终端里反复执行命令和排查问题的长任务,比如 SRE-Bench 上 88.0% 对上一代的 55.9%。你的 agent 如果是这种长链路,值得用 Astra 跑一批自己的任务对比一下。
7.5 万 token 的长日志:7 个答案两边都找全了
第三道题是一份 120 天的项目运维日志,约 7.5 万 token,大部分是日常流水账。我们在里面埋了几条会被后文改掉的信息:运输合同预算从 €48,000 改成 €52,500,仓库门禁码从 2290 改成 4471,QA 负责人换了人,上线日期从 3 月 14 日推到 4 月 2 日。还要数一数测试服务器(staging)真正重启了几次:真重启 4 次,另有一次「提议重启但推迟了」、一次「计划重启后取消」。
两个模型 7 个答案全对,都用的是改动后的新值,重启次数都数成 4 次并给出了正确的 4 个日期,没有被推迟和取消的那两条带偏。Astra 9 秒,6.1 Sol 8 秒。
7.5 万 token 对这两个模型都太轻松。Astra 在长文上的优势,按官方成绩要到 50 万到 100 万 token 才拉开:MRCR v2 八针测试里 Astra 96.3%,上一代 GPT-5.6 Sol 73.8%。要把整个代码库或几百页合同一次塞进去找东西,Astra 才值这个价;注意超过 27.2 万 token 后整个请求按 2 倍输入价计费。
中文下单聊天转 JSON:11 个字段全对
第四道题是一段很乱的微信下单聊天:客户先要 3 箱洗发水和 2 箱护发素,接着改成 5 箱洗发水、护发素不要了、换 1 箱沐浴露;又顺手帮同事下了一单护手霜;发票只开在自己那单上;最后问能不能周五前到。我们要求按固定的 JSON 结构输出,两个人各一张订单。
两个模型 11 个字段全对:洗发水按改过的 5 箱算,护发素删掉,沐浴露加上,手机号去掉了空格,发票只挂在第一单上,第二单只有 10 支护手霜,「周五前」也记到了交付要求里。Astra 8 秒,6.1 Sol 9 秒。这类结构化抽取,用 Astra 只是多付钱。
真实用户怎么用、要等多久
上面是我们自己出的题。再看平台上真实用户的调用:两个模型的请求大多是带着大段上下文的 agent 和写代码会话,每次请求的输入中位数约 9 万 token,其中约 85% 按缓存价计费,九成以上用流式输出。
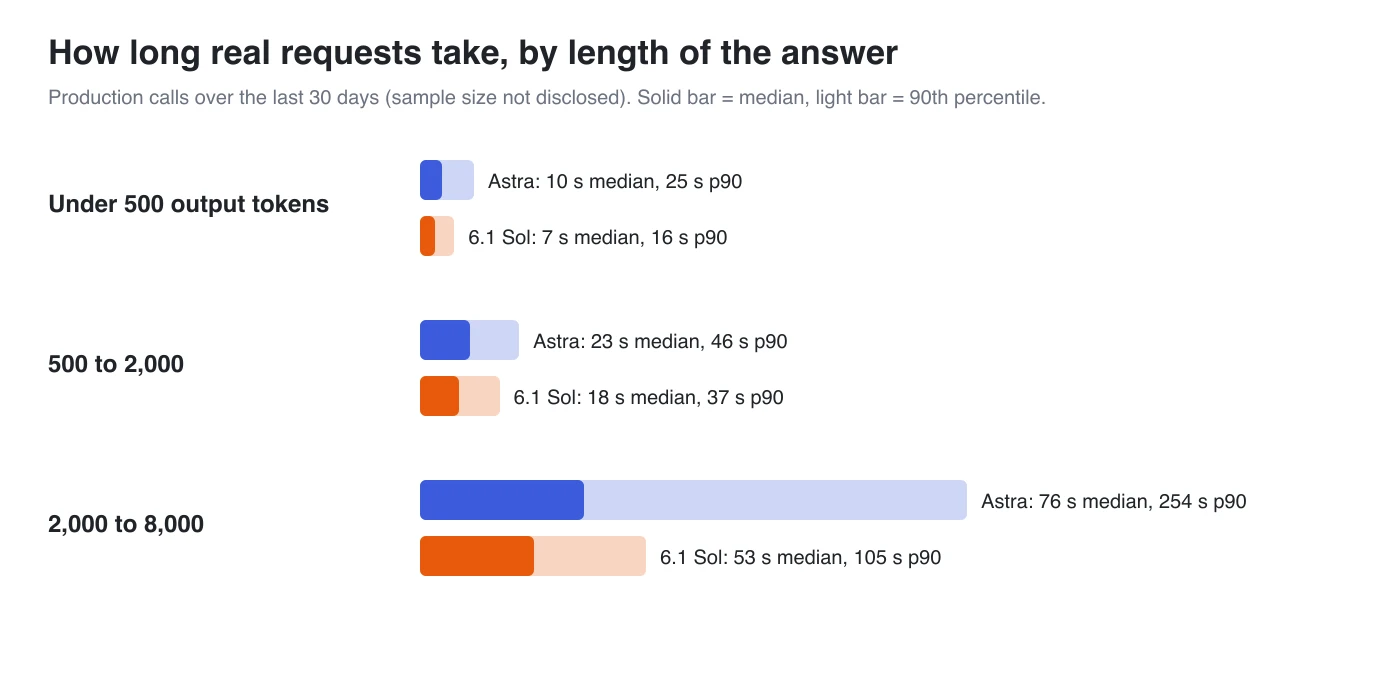
整体看,Astra 的耗时中位数 12 秒、90 分位 42 秒,6.1 Sol 分别是 9 秒和 33 秒。按回答长度分开看:500 token 以内的回答,Astra 中位 10 秒、Sol 7 秒;2,000 到 8,000 token 的长回答,Astra 中位 76 秒、Sol 53 秒,而 Astra 的 90 分位拉长到 254 秒,Sol 是 105 秒。要给用户实时回话的场景,Astra 的等待时间会明显更长。
和同类怎么选
- 对 GPT-6.1 Sol:日常任务结果一样,单价是 Astra 的约三分之一,速度更快;写代码的 DeepSWE v1.1 成绩 75.2% 还略高于 Astra 的 74.1%。默认先用它。
- **对 GPT-5.6 Sol**:上一代,Astra 的官方对比成绩都是跟它比的。新项目没有理由再留在 5.6。
- **对 GPT-6 Luna**:每百万 token $0.09 / $0.45,适合分类、摘要这种量大、简单的活,和 Astra 不是一个用途。
- **对 Claude Fable 5.1**:写代码的 FrontierCode 1.1 两者几乎一样(53.5% 对 53.3%),带工具的 Humanity's Last Exam 上 Fable 5.1 65.0%、Astra 57.2%,需要广博知识的深度推理 Claude 更强。
同一家的三档怎么分工,可以看我们之前写的 GPT-5.6 Sol、Terra、Luna 对比,思路在 GPT-6 这一代同样适用。
一次调用多少钱
GPT-6 Astra 按 token 计费:输入每百万 token $3.40、输出 $17.00,命中缓存的输入 $0.34,是 OpenAI 官方 $10 / $50(缓存 $1.00)的 34%。GPT-6.1 Sol 是输入 $1.00、输出 $5.00、缓存 $0.05。推理 token 按输出计费。以上是 2026 年 11 月 7 日的价格。
按真实用户的典型请求算(输入 9 万 token,其中 85% 命中缓存,回答 220 token):Astra 一次约 1.35 万 × $3.40 / 百万 + 7.65 万 × $0.34 / 百万 + 220 × $17 / 百万 ≈ $0.076;6.1 Sol 同样的请求约 $0.018,差不多是四分之一。跑 1,000 次这样的 agent 调用,Astra 约 $76,6.1 Sol 约 $18。
超长输入要单独算:一次输入 60 万 token 的请求超过了 27.2 万这条线,Astra 的输入价按 2 倍算成每百万 $6.80,光输入就是约 $4.08。失败的请求不扣费。
什么情况下别用它
- 日常写代码、结构化抽取、三五步的工具调用:我们的四道题两边打平,6.1 Sol 一次调用的费用约四分之一,还等得更短。
- 需要模型自己操作电脑、浏览器,或者要用 file_search 检索文件:这两个工具在我们的 API 上用不了。
- 对延迟敏感的实时对话:回答一长,Astra 的 90 分位能到 4 分钟以上。
- 需要广博知识的深度推理:带工具的 Humanity's Last Exam 上 Astra 落后 Claude Fable 5.1 将近 8 个百分点。
怎么调用
调用名是 gpt-6-astra。它走 OpenAI 兼容接口,/v1/chat/completions 和 /v1/responses 都可以用,现有的 OpenAI SDK 把 base URL 换成 apimodels.app 的地址、换上 API Key 就能跑,不需要 OpenAI 账号。同一个 Key 也能调 GPT-6.1 Sol、Claude 和 Gemini,换模型只改 model 这一个字段。回答较长的请求请开流式。参数、端点和价目表见语言模型 API 文档。
相关模型
- GPT-6.1 Sol:日常默认,写代码和工具调用够用,每百万 token $1 / $5。
- GPT-6.1 Terra:6.1 这一代的中间档,每百万 token $0.50 / $2.50。
- GPT-6 Luna:量大、简单的活,每百万 token $0.09 / $0.45。
- Claude Fable 5.1:长时间 agent 和深度推理,每百万 token $5 / $25。
- Claude Opus 5.5:Claude 的 Opus 档,通用任务,每百万 token $2.40 / $12。
想用一个 Key 同时调 GPT、Claude 和 Gemini,可以看一个 API Key 调用 Claude、GPT、Gemini。
常见问题
GPT-6 Astra 发布了吗?现在能用 API 调用吗?
已经发布。OpenAI 在 2026 年 9 月推出 GPT-6 Astra,apimodels.app 从 9 月 5 日起提供 API 调用。调用名是 gpt-6-astra,走 OpenAI 兼容的 chat/completions 和 responses 接口,不需要 OpenAI 账号,一个 API Key 就能用。
GPT-6 Astra 的 API 多少钱?
每百万 token 输入 $3.40、输出 $17.00,命中缓存的输入 $0.34,是 OpenAI 官方 $10 / $50 的 34%;推理 token 按输出计费。单次输入超过 27.2 万 token 时整个请求按输入 2 倍、输出 1.5 倍计费。按真实用户的典型 agent 请求(输入 9 万 token、85% 命中缓存)算,一次约 $0.076。失败的请求不扣费。
GPT-6 Astra 和 GPT-6.1 Sol 哪个强?
日常任务打平,难任务 Astra 强。我们让两者跑写代码、调工具、7.5 万 token 长文和中文转 JSON 四道题,全部答对,6.1 Sol 更快、一次调用费用约四分之一。Astra 的优势在几十步的终端和运维 agent、50 万 token 以上的长文检索和很难的数理题;单论写代码,6.1 Sol 的 DeepSWE v1.1 成绩还略高。
通过 API 能用 GPT-6 Astra 操作电脑吗?
在 apimodels.app 上不能。Computer Use 和 file_search 这两个工具在我们的 API 上用不了;函数调用、内置网页搜索和代码解释器可以用。宣传里 OSWorld 2.0 的 72.6% 靠的就是 Computer Use,通过 API 你需要自己用函数调用搭 agent 循环。
怎么让 GPT-6 Astra 快一点、省一点?
三个办法。一是把推理强度调成 low:我们写代码那题耗时从 56 秒降到 28 秒,推理 token 从 696 降到 214,结果一样全对。二是让系统提示和固定资料放在最前面、每轮保持一致,命中缓存的输入只按 $0.34 每百万计费。三是回答较长时开流式,边生成边收,也避免等太久超时。