gpt-image-2API GPT Image 2 de OpenAI: texto a imagen y edición con hasta 16 imágenes de referencia por petición, con salida nativa en 1K / 2K / 4K a $0.025 / $0.03 / $0.05 por imagen y calidad Medium o High. Una sola API key, mucho más barato que el acceso directo, sin verificación de organización de OpenAI y accesible desde cualquier lugar.
Auto follows your reference image when editing. With text-to-image there is nothing to follow, so it renders square (1:1) — pick a ratio here if you want a shape. Widest available is 21:9; asking for a ratio in the prompt has no effect.
Generated image will appear here
Enter a prompt and click Generate
En los últimos 30 días, el 0.93% de las peticiones de este canal fue rechazado por el sistema de seguridad del proveedor, frente al 8.0% de gpt-image-2-all: mismo modelo de base, solo que aquí el criterio de revisión es más flexible. Si allí tus prompts chocan una y otra vez con un rechazo, prueba por aquí. Lo que se rechaza no se cobra
Llama a GPT Image 2 con una sola API key: sin verificación de organización ni de identidad en OpenAI, sin lista de espera y accesible desde cualquier país, China continental incluida
El modelo de imagen más reciente de OpenAI, con una fidelidad al prompt de primer nivel
Hasta 16 imágenes de referencia por petición
1:1, 2:3, 3:2, 4:5, 5:4, 4:3, 3:4, 16:9, 9:16, 21:9 (5:4 y 4:5 solo en 1K)
$0.025 / $0.03 / $0.05 en 1K / 2K / 4K (calidad medium); también hay escalones low y high
Conmutación automática entre varios canales upstream para que el servicio no se caiga
Consulta el endpoint de tarea hasta obtener el resultado: normalmente 40-90 s
GPT Image 2 es una API de generación de imágenes de OpenAI. API GPT Image 2 de OpenAI: texto a imagen y edición con hasta 16 imágenes de referencia por petición, con salida nativa en 1K / 2K / 4K a $0.025 / $0.03 / $0.05 por imagen y calidad Medium o High. Una sola API key, mucho más barato que el acceso directo, sin verificación de organización de OpenAI y accesible desde cualquier lugar. A través de la plataforma APIMODELS puedes acceder a este modelo mediante una API unificada con precios de pago por uso transparentes. Precio actual: 1K: $0.025, 2K: $0.03, 4K: $0.05.
Modelo relacionado: gpt-image-2-all — same model, but you pick the quality tier — low / medium / high × 1K/2K/4K, and OpenAI-SDK compatible (images.generate / images.edit) so Codex and Cursor can call it directly
Carteles, creatividades publicitarias, portadas y packaging donde las palabras forman parte de la obra: es el renderizador de texto en imagen más fiable de nuestro catálogo, así que los titulares salen compuestos, no emborronados.
Pasa hasta 16 imágenes de referencia para mantener firme un personaje, un producto o un estilo en un lote entero, en vez de repetir tiradas hasta que dos tomas coincidan por casualidad.
Cambia un fondo, recolorea, sustituye un elemento: el resto del encuadre se queda donde estaba. Aquí la edición es una vía de primera clase, no un truco de prompt.
1K, 2K y 4K salen del modelo a esa resolución; nada se amplía después, así que el detalle fino y la tipografía pequeña sobreviven, a $0.05 el 4K.
El precio depende solo de la resolución ($0.025 / $0.03 / $0.05); la calidad nunca lo altera. Multiplica imágenes por nivel y tienes el gasto exacto antes de la primera llamada.
GPT Image 2 está disponible a través de APIMODELS a: 1K: $0.025, 2K: $0.03, 4K: $0.05. La facturación es de pago por uso: solo pagas por lo que generas.
Regístrate en APIMODELS, obtén tu clave API y llama a nuestro endpoint unificado. Ofrecemos documentación detallada con ejemplos en cURL, Python y Node.js.
APIMODELS ofrece el mismo modelo GPT Image 2 a través de nuestra plataforma de agregación. Proporcionamos una interfaz de API unificada, así que no necesitas cuentas separadas por proveedor: una sola clave para acceder a todos los modelos.
El modelo de imagen de nueva generación de OpenAI, con una tipografía dentro de la imagen más nítida, ediciones a nivel de píxel más estables, mayor conocimiento del mundo, generación rápida y alta fidelidad al prompt.
Sí. Regístrate en apimodels.app, consigue una API Key y llama a gpt-image-2 de inmediato: desde $0.025 por imagen, con niveles 1K/2K/4K a $0.025/$0.03/$0.05 y hasta 16 imágenes de referencia por petición.
Ambos, mediante un único endpoint que enruta automáticamente según haya o no una imagen de referencia. El aspect ratio define la composición de salida y se pueden fusionar hasta 16 imágenes de referencia en una sola petición.
Edición de productos de e-commerce, visuales de marketing por lotes, SaaS de generación/edición de imágenes con IA, capas de producción para sistemas de diseño, visuales localizados en varios idiomas, ilustraciones educativas y cualquier flujo que convierta texto más imágenes en salida visual.
Sí. El renderizado de texto multilingüe es un foco clave y, junto con un mejor seguimiento de instrucciones en prompts con varios sujetos y escenas por capas, las composiciones complejas y el texto dentro de la imagen salen notablemente más limpios.
Sí. gpt-image-2 admite hasta 16 imágenes de referencia por petición, lo que encaja con lookbooks, prueba virtual sobre modelo, fusión de packaging y otros escenarios con varias referencias.
Una sola key para todos los modelos, documentación API completa con ejemplos en cURL / Python / Node.js, las tareas fallidas no se cobran, los resultados se alojan en nuestro R2 y hay conmutación automática entre varios canales upstream para mayor fiabilidad.
En apimodels.app, gpt-image-2 tiene precios por nivel: $0.025 / $0.03 / $0.05 en 1K / 2K / 4K, sin gasto mínimo ni cuota mensual, y las tareas fallidas no se cobran. Es una de las formas más económicas de usar la API de GPT Image 2.
Haz un POST a https://api.apimodels.app/v1/images/generations con la cabecera Authorization: Bearer <tu API key>. En el cuerpo JSON pon model como "gpt-image-2" y un prompt; para editar, añade image_url (una) o image_urls (hasta 10). En la documentación del modelo hay ejemplos en curl y Python (requests / compatible con el SDK de OpenAI) listos para copiar.
Es el mismo modelo gpt-image-2 de OpenAI, así que la calidad es idéntica. La diferencia es el acceso: con apimodels.app usas una sola API key desde $0.025/imagen (precios por nivel), sin verificación de organización de OpenAI y accesible desde cualquier lugar, más barato y sencillo que conectar OpenAI directamente.
Sí. Regístrate en apimodels.app para obtener una API key, sin necesidad de cuenta de OpenAI ni verificación de organización, y el endpoint es accesible desde China y cualquier otro lugar. Las imágenes generadas se alojan en nuestro R2 para descarga directa.
No: siempre funciona en el nivel medium y enviar un campo quality no tiene ningún efecto. Es deliberado: un único nombre de modelo, un único parámetro de resolución, una decisión menos que tomar y un precio que depende solo de la resolución ($0.025 / $0.03 / $0.05 en 1K / 2K / 4K). Si quieres elegir tú la calidad, usa gpt-image-2-all: el mismo modelo por debajo, pero con la matriz completa de resolución × calidad a la vista (1K/2K/4K × low/medium/high, además de auto). Low en 1K cuesta $0.01 y el nivel high está ahí cuando buscas el máximo detalle. Además es el canal síncrono compatible con el SDK de OpenAI, así que Codex y Cursor pueden llamarlo cambiando solo el base_url. Tienes el enlace al final de esta página, entre los modelos relacionados.
gpt-image-2 acepta hasta 16 imágenes de referencia por petición para fusión y edición multi-imagen, genera en 1K / 2K / 4K con calidad low / medium / high (medium por defecto) y te deja encuadrar con el aspect ratio (1:1, 2:3, 3:2, 4:5, 16:9, 9:16 y más; 5:4 y 4:5 solo existen en 1K, no en 2K/4K). El precio sale de resolución × calidad: el nivel medium cuesta $0.025 / $0.03 / $0.05 en 1K / 2K / 4K.
En los últimos 30 días de tráfico de producción externo —24.208 llamadas— la **tasa de éxito de infraestructura es del 98.9%**. Ahí solo contamos los fallos que nos toca arreglar a nosotros: 119 timeouts, 66 por saturación del upstream y 15 en los que el upstream no devolvió imagen, 200 en total. Quedan fuera los rechazos por política de contenido de OpenAI y las peticiones mal formadas, porque ambos se resuelven ajustando el prompt o los parámetros y ninguno se cobra. Dicho de otro modo: si tu prompt pasa la política de contenido de OpenAI, la entrega es fiable. Conviene decirlo en voz alta: **casi nadie en este sector publica una tasa de éxito.** Otras páginas de API ofrecen «estable» y «alta disponibilidad», adjetivos que no puedes verificar. Nosotros publicamos las cifras reales de 30 días junto con la forma de calcularlas, y puedes hacerle la misma pregunta a cualquier proveedor.
Medido en producción durante 30 días: mediana de 60 segundos y p95 de 157 segundos. La mitad de las peticiones vuelve en menos de un minuto y el 95% en menos de dos minutos y medio. La vía síncrona (pasas `size` y omites `callback_url`) mantiene la conexión abierta hasta que la imagen está lista; si prefieres no sostener una conexión, usa la vía de tarea con polling o con `callback_url`. Pon los timeouts de cliente por encima de 180 segundos.
Los fallos no se cobran nunca: timeouts, saturación del upstream y rechazos por política de contenido salen a cero, y solo pagas por las imágenes realmente entregadas. gpt-image-2 y gpt-image-2-all pasan por adaptadores upstream distintos, así que un problema en uno no tumba al otro y puedes reintentar cambiando el nombre del modelo. El saldo se reserva por adelantado y se libera automáticamente cuando una tarea falla.
Sin suscripción, sin cuota mensual y sin gasto mínimo: pagas por imagen. La recarga más pequeña es de $10 y una sola API key cubre todos los modelos de la plataforma (imagen, vídeo, audio y LLM comparten el mismo saldo en dólares), así que no tienes que abrir cuenta con cada proveedor de modelos. Las cuentas nuevas con dominios de correo personales reciben $0.10 de crédito gratis, suficiente para cuatro imágenes 1K con la calidad por defecto, de modo que puedes comprobar la calidad del resultado antes de pagar nada. No hace falta cuenta de OpenAI ni verificación de organización, y la API es accesible desde China continental.
Stripe (tarjeta), PayPal y Alipay. **Pagando por Stripe puedes introducir el identificador fiscal de tu empresa (VAT de la UE y equivalentes) en el checkout; tras el pago se genera automáticamente una factura PDF formal con los datos fiscales de ambas partes y te llega por correo**, y el identificador queda guardado para que lo lleven todas las facturas siguientes. PayPal no recoge identificadores fiscales, así que allí las facturas se emiten a mano: escribe a support@apimodels.app con el nombre de la empresa, la dirección y el identificador fiscal. La entidad vendedora está en Reino Unido, de modo que las ventas a empresas de la UE van por inversión del sujeto pasivo (reverse charge).
La cuenta funciona con saldo prepago: cuando se agota, las llamadas devuelven 402 en lugar de seguir generando cargos, así que el techo es duro y gastar de más no es posible. También puedes configurar un webhook de saldo bajo (tu servicio recibe aviso al bajar de un umbral) y la recarga automática (con recuento de fallos y bloqueo para que los reintentos no se disparen). En la consola tienes desglosado el cargo real, los parámetros de entrada y el resultado de cada llamada, así que no hay nada que cuadrar a fin de mes.
Hay tres puertas realistas: la API oficial de OpenAI (y Azure OpenAI al mismo precio de lista), pasarelas independientes como APIMODELS y agregadores generalistas. Júzgalas por cuatro cosas, no por el precio de portada: (1) **la tasa de éxito real y cómo se calcula** — pregunta si los rechazos por política de contenido están en el denominador, porque las dos definiciones no son comparables; (2) si se cobran los fallos; (3) si el precio es previsible — la API oficial factura las imágenes como tokens de salida, así que el coste por imagen es un rango, no un número; (4) si vas a poder acceder siquiera, porque OpenAI deja sus modelos de imagen detrás de la verificación de organización. Nuestras cifras, incluidas las que no nos favorecen, están en esta página; hazle las mismas cuatro preguntas a cualquier proveedor.
En este modelo sí, porque el precio bajo no sale de recortar nada. La imagen la produce el pipeline de imagen real de OpenAI; nosotros simplemente la cobramos a tanto fijo por imagen ($0.025 / $0.03 / $0.05 en 1K / 2K / 4K) donde la API oficial factura tokens de salida y sale en torno a $0.053 por un 1024x1024 con la calidad por defecto. La tasa de éxito de infraestructura es del 98.9% y los fallos nunca se cobran. La verdadera compensación está en otro sitio: ve a la oficial si tu pipeline necesita una garantía exacta de dimensiones en píxeles, o si necesitas papeleo de cumplimiento como DPA y cadenas SOC 2, que solo da una relación directa.
El rechazo viene de la política de contenido de OpenAI, no de nosotros, y en la práctica es habitual: 6.007 de 24.208 llamadas en los últimos 30 días dieron con ella, **aproximadamente una petición de cada cuatro**. Los disparadores típicos son personas reales por nombre o parecido, marcas y personajes con copyright, contenido violento o adulto y maquetaciones que se leen como documentos falsificados. El arreglo suele consistir en sustituir el nombre de la persona por una descripción de su aspecto, cambiar la marca por una categoría de producto y evitar palabras como pasaporte, DNI o carné. Las peticiones rechazadas no se cobran.
No se cobra. Queda registrado como fallo CONTENT_MODERATION en tu registro de llamadas y el crédito reservado se libera automáticamente. Tampoco lo metemos en la «tasa de éxito de infraestructura»: ese 98.9% solo cuenta timeouts, saturación del upstream y respuestas sin imagen, porque son los fallos que no se habrían arreglado con otro prompt.
Según nuestros términos conservas tus derechos sobre lo que envías y sobre lo que generas, y el uso comercial está permitido. Dos matices que conviene conocer: el uso final sigue sujeto a la política de contenido de OpenAI (de ahí la pregunta anterior sobre rechazos) y las jurisdicciones no se ponen de acuerdo sobre si las imágenes generadas por IA tienen derechos de autor siquiera; consulta con tu asesoría legal antes de construir activos de marca sobre ellas o de reclamar derechos en exclusiva.
Los archivos de resultado permanecen **7 días** en nuestro almacenamiento de objetos y luego se borran, así que descarga o re-aloja lo que necesites. Los prompts y los registros de llamadas sí se conservan a largo plazo en la consola, de modo que siempre puedes consultar los parámetros. Una distinción que conviene tener clara: la URL prefirmada de subida vale 10 minutos — eso es para subir material de origen y no tiene nada que ver con los 7 días de retención de los resultados.
En APIMODELS, GPT Image 2 convive con más de 60 modelos bajo una sola clave API y un solo saldo, así que elegir es cuestión de ajuste, no de dependencia. Admite Text to Image, Image Editing, Multi-Image, 1K/2K/4K, Async y puedes valorarlo en precio y capacidad frente a otros modelos de generación de imágenes, y cambiar modificando una sola cadena con el nombre del modelo: sin nueva cuenta ni integración. Explora todas las opciones de generación de imágenes con precios en vivo en apimodels.app/models.
GPT Image 2 admite: Text to Image, Image Editing, Multi-Image, 1K/2K/4K, Async. Consulta la documentación de APIMODELS para ver todos los parámetros y ejemplos de llamada.
Sí. APIMODELS expone GPT Image 2 mediante una única API unificada y una sola clave, sin cuentas separadas por proveedor ni necesidad de gestionar tú mismo el acceso de red regional de cada proveedor.
Aceptamos Stripe (Visa, Mastercard y otras tarjetas internacionales) y Alipay. El saldo está disponible al instante tras el pago.
Sustituir texto es lo que más se le pide a este modelo y, a la vez, lo más difícil de conseguir con un prompt: el texto nuevo tiene que caer en la tipografía, el tamaño y el fondo originales. Si prefieres no montar ese flujo por tu cuenta, EditTextImage es nuestro propio front-end para esto: funciona sobre este mismo modelo y solo pide la imagen, lo que pone ahora y lo que debería poner. Tiene una guía para editar el texto de una captura y otra para mantener la misma fuente del original, que es justo donde fallan casi todos los prompts escritos a mano.
APIMODELS facilita el acceso a la GPT Image 2 API para la generación de imágenes, la edición de imágenes, los visuales con mucho texto y los flujos de trabajo de imágenes comerciales de mayor calidad.
La GPT Image-2 API convierte los prompts de texto en resultados visuales pulidos para creatividades de marketing, conceptos de producto, visuales para redes sociales, imágenes publicitarias, ilustraciones y recursos de diseño de marca. El flujo basado en prompts brinda a los desarrolladores una forma flexible de construir experiencias de AI Image Generator para una ideación visual rápida y resultados refinados.
La GPT-Image-2 API también trabaja a partir de imágenes existentes, ideal para cambios de estilo, reemplazo de fondos, recoloreado de productos, mejora del sujeto y limpieza de composición: ediciones controladas que conservan las partes importantes de la imagen original. Para productos de AI Image Editor, ofrece transformaciones más limpias con mayor control visual.
Frases largas, etiquetas de varias palabras, puntuación más clara y consistencia de mayúsculas y minúsculas: valioso para mockups de escaparates, pósteres, conceptos de UI, infografías, packaging y recursos de marketing de marca. La tipografía deja de ser el punto débil de la imagen.
Cambia una parte de la imagen sin alterar el resto: recoloreado de productos, reemplazo de objetos, actualizaciones de fondo, refinamientos locales de la escena. La iluminación, las sombras, las texturas y el estilo del entorno originales se mantienen coherentes, más limpio que regenerar la imagen completa.
Mejor para tareas donde importa la credibilidad visual: mapas, diagramas de anatomía, reconstrucciones históricas, escenas arquitectónicas, visuales educativos. Las escenas complejas y las relaciones entre objetos se interpretan con mayor fidelidad, haciendo los resultados más creíbles.
Resultados de alta calidad a un ritmo de generación de ~3s (10-40s de extremo a extremo en modo asíncrono). Mejor seguimiento de instrucciones para prompts con varios sujetos, escenas con múltiples capas de detalle y mayor control del diseño: práctico para la creación visual compleja a escala.
Anuncios localizados, packaging internacional, mockups de interfaz, gráficos educativos, recursos de campañas de marca: el texto dentro de las imágenes es parte del diseño, no un marcador de posición. Precisión lingüística y pulido visual entregados juntos.
Crea una cuenta o inicia sesión en APIMODELS y genera tu API Key en la consola. Esta key autentica todas las solicitudes y conecta la GPT Image 2 API con tu aplicación o flujo de trabajo interno.
Usa el Playground para evaluar antes de integrar. Prueba el comportamiento del prompt, compara texto a imagen frente a imagen a imagen, revisa la calidad de salida y valida que encaja antes de pasar al código.
Conecta tu servicio backend con solicitudes autenticadas. Define los parámetros de la solicitud, el manejo de prompts, valida las imágenes de entrada y analiza las salidas devueltas para que el modelo funcione de forma fiable en tu aplicación.
Procesa los recursos generados, almacena los archivos de salida, gestiona las URLs devueltas o el almacenamiento de objetos, y define cómo los resultados llegan a los usuarios o servicios posteriores. Un pipeline limpio convierte la API en un componente listo para producción.
Prepara una operación estable en producción: planificación de concurrencia, lógica de reintentos, manejo de timeouts, flujo de moderación, registros, control de costes y las reglas propias de tu producto. Con todo esto en su lugar, la API puede impulsar de forma fiable productos de AI Image Generator y AI Image Editor.
Para equipos que necesitan volúmenes constantes de visuales de campaña pulidos en todos los canales: imágenes publicitarias, creatividades de social de pago, banners promocionales, gráficos de lanzamiento, recursos estacionales. Más rápido del concepto a un resultado utilizable, más cerca de creatividades listas para campaña desde el inicio.
Encaja en el e-commerce y el merchandising, donde las actualizaciones son controladas (no arte conceptual puntual): cambiar fondos, recolorear, refinar imágenes de ficha, probar packaging, cambiar visuales hero, sin reconstruir la escena cada vez. Afecta directamente a la conversión y la velocidad de contenido.
Funciona como una capa de producción dentro de un pipeline de contenido más amplio, no como una función aislada: gráficos de presentación, visuales editoriales, mockups de UI, recursos de blog, infografías, frames conceptuales, imágenes de apoyo de marca, alineados con un sistema de comunicación más grande.
Muy relevante en distintas regiones, idiomas y segmentos de audiencia: campañas localizadas, packaging multilingüe, promociones regionales, gráficos educativos, recursos de interfaz. La adaptación visual, la precisión lingüística y la consistencia creativa avanzan juntas.
Precios asequibles para equipos que quieren construir con un modelo de imagen de OpenAI más potente sin disparar los costes demasiado pronto. La generación frecuente, las pruebas de prompts, la producción visual por lotes y los flujos de edición a gran escala dependen del precio, ahora bajo mayor control.
La documentación completa cubre configuración, pruebas e implementación. Estructura de la solicitud, manejo de entradas, entrega de salidas, autenticación y lógica de integración: todo detallado tanto para la primera implementación como para la iteración a largo plazo.
GPT Image 2, Gemini, Claude, Kling, SparkPix y más se pueden llamar a través de una API unificada y una sola key, sin necesidad de registrarte en plataformas separadas. Precios transparentes de pago por uso, ideal para desarrolladores independientes y startups.
Las tareas con state=failed no se facturan, así que reintentar es seguro. Los resultados exitosos se alojan en nuestro R2 y las URLs se pueden consumir directamente; aun así, se recomienda persistirlos en tu propio almacenamiento en 24h como defensa adicional.
Prompts shared by their authors — copy and adapt them. Each one credits its author and links back to the original post.
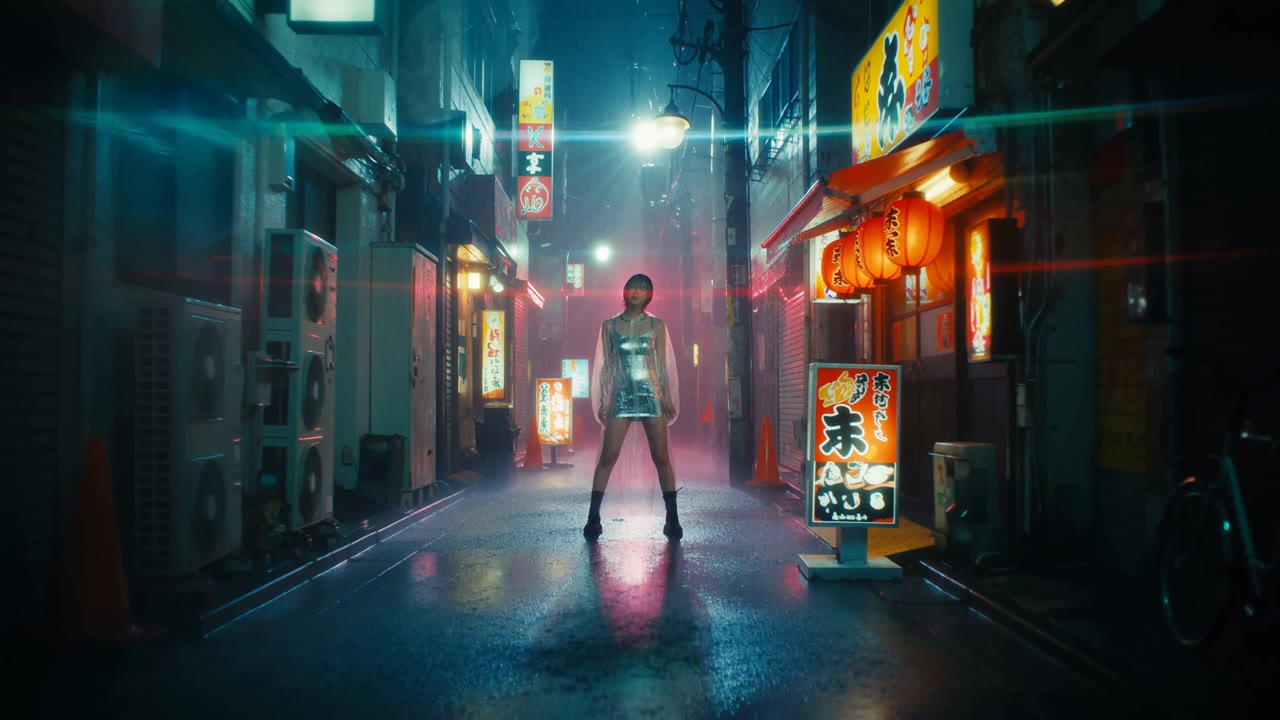
Neon Tokyo Music Video (native stereo audio)
Music video. The soundtrack is a high-energy city-pop / synthwave track with a driving bassline, punchy live drums and a bright analog synth hook, playing continuously from the first frame. Neon-lit Tokyo backstreet at night in the rain. A young female singer in an oversized translucent raincoat performs straight to camera under a red izakaya lantern, singing the hook in sync with the music. Fast cuts landing on the beat: wide shot down the alley with neon reflected in puddles; tight close-up of her face with magenta rim light and rain on her cheek; low-angle push as she walks toward camera when the bass drops; quick insert of rain hitting a buzzing neon sign; back to a wide performance shot as the hook repeats. Anamorphic lens flares, shallow depth of field, 35mm film grain, teal and magenta palette, cinematic colour grade. No on-screen text.
by APIMODELS
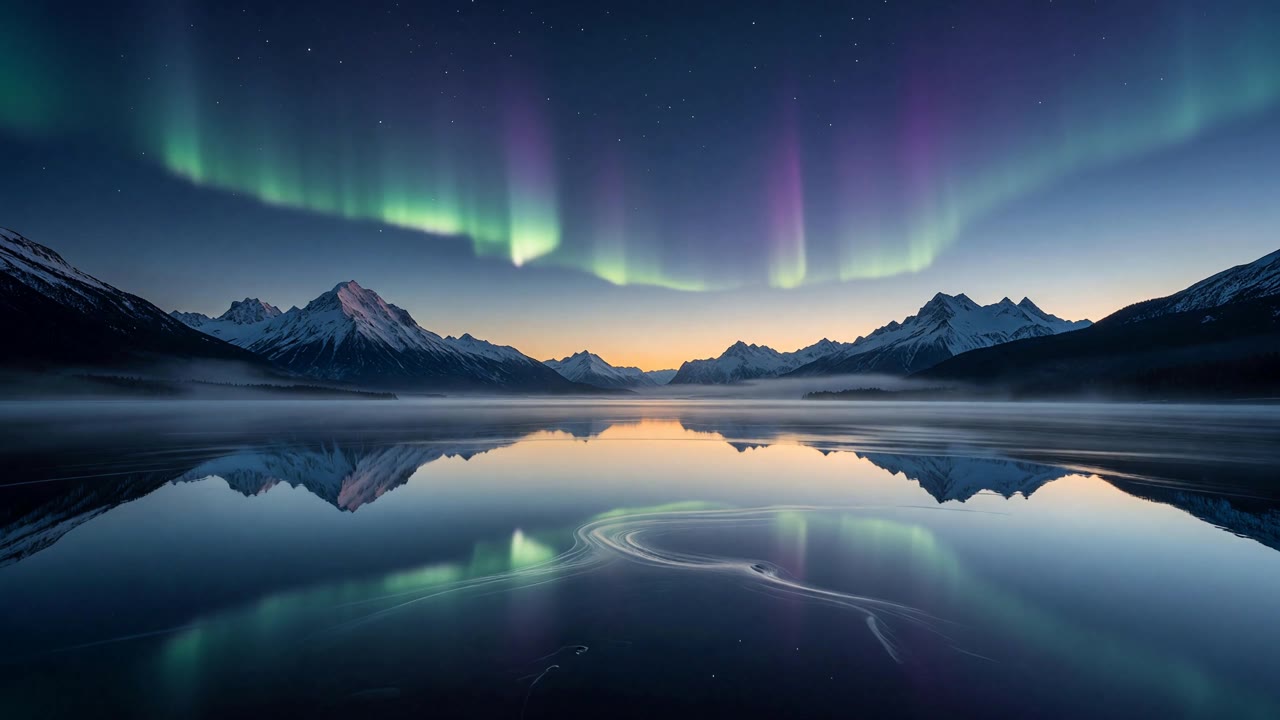
Living Wallpaper: Aurora Lake (locked camera)
Locked-off static camera. No zoom, no pan, no dolly, no parallax. Only ambient atmosphere moves: the aurora ribbons drift and undulate slowly across the night sky, thin low mist creeps gently across the lake, the water surface breathes with extremely subtle ripples while keeping the mirror reflection intact, faint stars shimmer. Calm, continuous, seamless ambient loop. Nothing enters or leaves the frame, no new objects, no people, no text.
by APIMODELS

Condor Heroes characters teach English word dream
神雕侠侣主角趣味讲单词 dream 教程
by @nicekate8888
We curate copy-ready prompt libraries — every entry shows its full text and a sample result, ready to adapt.
How to get access, regional availability, and how this model compares with its alternatives.
