
muse-videoMuse Video — видеомодель Meta Superintelligence Labs. На APIMODELS это одна модель muse-video на едином видеоэндпоинте: отправьте только промпт — получите видео из текста; добавьте одно изображение первого кадра — и ролик начнётся с этой картинки; добавьте до четырёх референсных изображений — и модель сохранит того же человека или объект, но не начнёт ролик ни с одного из них. Запрос остаётся компактным. prompt обязателен (до 4000 символов, на любом языке). duration задаёт длину в целых секундах от 4 до 30 (поле seconds в стиле OpenAI тоже работает); если его не указать, ролик будет 5 секунд. aspect_ratio выбирает горизонтальный 16:9 (по умолчанию, 1280×720) или вертикальный 9:16 (720×1280); size 1280x720 или 720x1280 делает то же самое. Выход всегда 720p: 1080p и квадратного формата нет, и такой запрос получает 400 ещё до создания задачи. Для видео из изображения передайте первый кадр в image_url (подойдут и first_frame_url, image и input_reference), лучше в той же ориентации, что и ролик; референсные изображения, до четырёх, передаются в images (подойдут и image_urls, reference_image_urls). Каждое изображение — публичный URL или base64 data URI в формате PNG, JPEG или WebP. Выбирайте что-то одно: первый кадр вместе с референсами, больше четырёх референсов, последний кадр, референсное видео или аудио, negative_prompt, seed и отключение звука отклоняются с ошибкой 400. Длина ролика идёт шагами. Запросы на 5, 6, 8, 10, 15, 20, 25 или 30 секунд возвращаются ровно такой длины; любое другое целое число округляется вверх до следующего шага (4 → 5 с, 7 → 8 с, 11 → 15 с), поэтому ролик никогда не бывает короче оплаченного. Видео — H.264 MP4 с частотой 24 fps, и, по описанию Meta, Muse Video генерирует звук вместе с картинкой. В нашем тесте с референсами четыре снимка одной девушки дали 5-секундный ролик на пляже, где у неё сохранились лицо и причёска; ни с одного из снимков модель ролик не начинала. Генерация идёт как асинхронная задача: создайте её, затем опрашивайте статус или получите callback. Ролики до 10 секунд обычно занимают одну-две минуты, от 15 до 30 секунд — от трёх до семи. Не каждый запрос завершается успешно: модель может отказаться генерировать контент, генерация может столкнуться с временной ошибкой, а ролик с неверной ориентацией или длиной отбраковывается; неудачная задача не оплачивается. Цена — $0.037 за запрошенную секунду: 5 с — $0.185, 10 с — $0.37, 30 с — $1.11.
The API also takes any other whole number from 4 to 30; it rounds up to the next length here (7 s comes out as 8 s) and is billed on the seconds you request.
Generated video will appear here
Provide URLs and click Generate
Одна модель: только промпт, один первый кадр, чтобы ролик начался с вашей картинки, или до четырёх референсных изображений, чтобы один и тот же человек переходил из ролика в ролик
Целые секунды; 5, 6, 8, 10, 15, 20, 25 и 30 с выходят точно, остальные длины округляются вверх, так что ролик никогда не короче оплаченного
1280×720 (16:9, по умолчанию) или 720×1280 (9:16), H.264 MP4 с частотой 24 fps; без 1080p, без квадрата и других соотношений
По описанию Meta, Muse Video генерирует звук одновременно с видео
Не каждый запрос завершается успешно, и неудачная задача не оплачивается; неподдерживаемые длины, размеры и входные данные отклоняются с ошибкой 400 до создания задачи
Оплата по запрошенным секундам: 5 с — $0.185, 10 с — $0.37, 30 с — $1.11
Muse Video — видеомодель Meta. Отправьте только промпт, добавьте одно изображение первого кадра, чтобы ролик начинался с него, или до четырёх референсных изображений, чтобы сохранить того же человека или объект, и получите MP4 в 720p длиной от 4 до 30 секунд, горизонтальный 16:9 или вертикальный 9:16.
На APIMODELS это одна модель muse-video на POST /v1/video/generations, оплата — $0.037 за запрошенную секунду. Прежде чем строить на ней продукт, посмотрите ограничения ниже: только 720p, только горизонтальный или вертикальный формат, либо один первый кадр, либо до четырёх референсов (не вместе), и не каждый запрос завершается успешно.
muse-videoВидео по тексту, без первого кадра, 9:16, 10 секунд. Одна генерация, показана как есть.
Один запрос с промптом ниже, duration 10 и aspect_ratio 9:16. Muse Video примерно за 75 секунд вернул клип длиной 10,0 секунды в 720×1280 с музыкой и одним непрерывным планом отыграл список действий по порядку: глаза закрыты на подушке, глаза открываются и смотрят в камеру, смущённая улыбка, одеяло натянуто на пол-лица, «викторию» подносят почти вплотную к объективу, рука прикрывает рот, пока она смеётся в подушку, и телефон заваливается к потолку.
Именно такие клипы у Muse Video получаются хорошо: один человек, вертикальный кадр селфи с рук, короткая цепочка мелких жестов и настроение, которое создают тёплый приглушённый свет и музыка. Повторная генерация того же промпта даст другой результат. По тексту нельзя сохранить одно и то же лицо от клипа к клипу; для постоянного персонажа передайте до четырёх его референсных изображений (images): модель сохранит лицо, но ролик не будет начинаться с картинки.
主体:人物是明月(我的固定角色),穿奶白低领细肩吊带;头发被枕头压乱,多缕发丝横过脸部。从闭眼侧躺开始,再睁眼互动。全程同一张脸、同一套衣服。

场景:夜间卧室床上,白被子白枕头,暖色床头灯。她自己拿手机前置超近距自拍,头到上胸几乎占满竖屏,腰腹和下半身不入画。手腕轻轻晃,构图略歪;一镜到底,不切镜。

音乐:轻甜 bedroom pop 器乐,约 90 BPM。无台词、无说话口型。配乐里不要人声和笑声。

动作:侧脸贴枕闭眼浅笑 → 慢慢睁眼锁定镜头 → 下巴抵肩害羞抿嘴笑 → 拉起白被子挡住半张脸再拉开 → 空着手从上胸前伸向镜头,V 手势几乎贴住镜头再收成夹捏/小爱心 → 握拳挡嘴害羞偷笑,把脸埋进枕头 → 手机一歪甩向天花板。实时速度。

画质:故意拍糊,手持动态模糊和局部失焦,暖色低照度,10 秒竖屏。18 роликов, каждый — один запрос на 10 секунд с двумя референсами. Показаны как есть; в карточке — точный текст промпта.
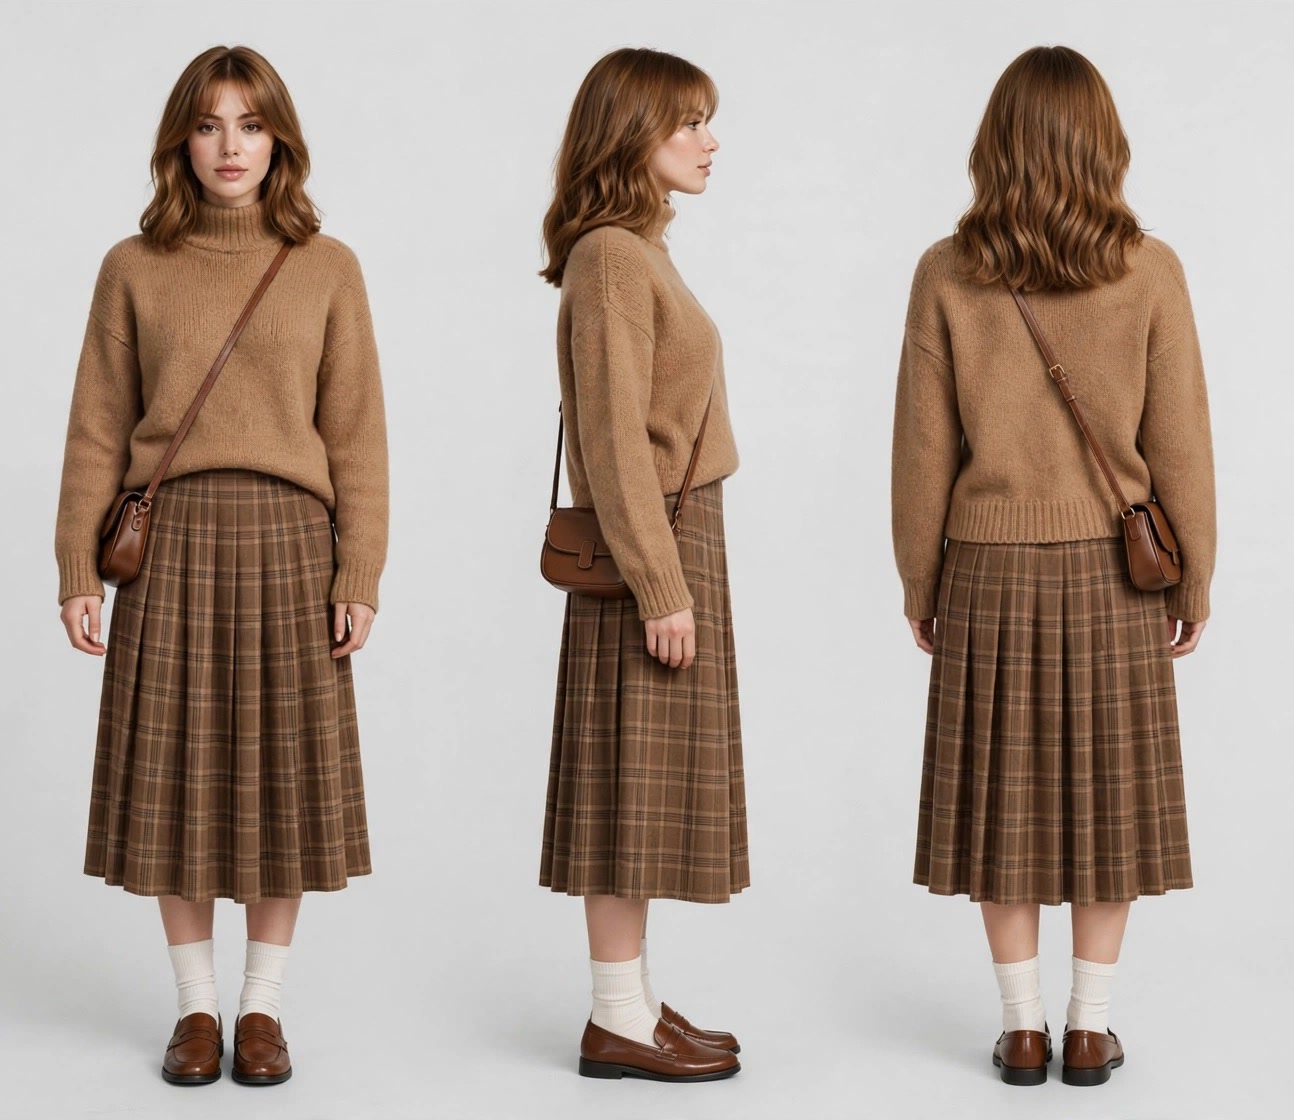
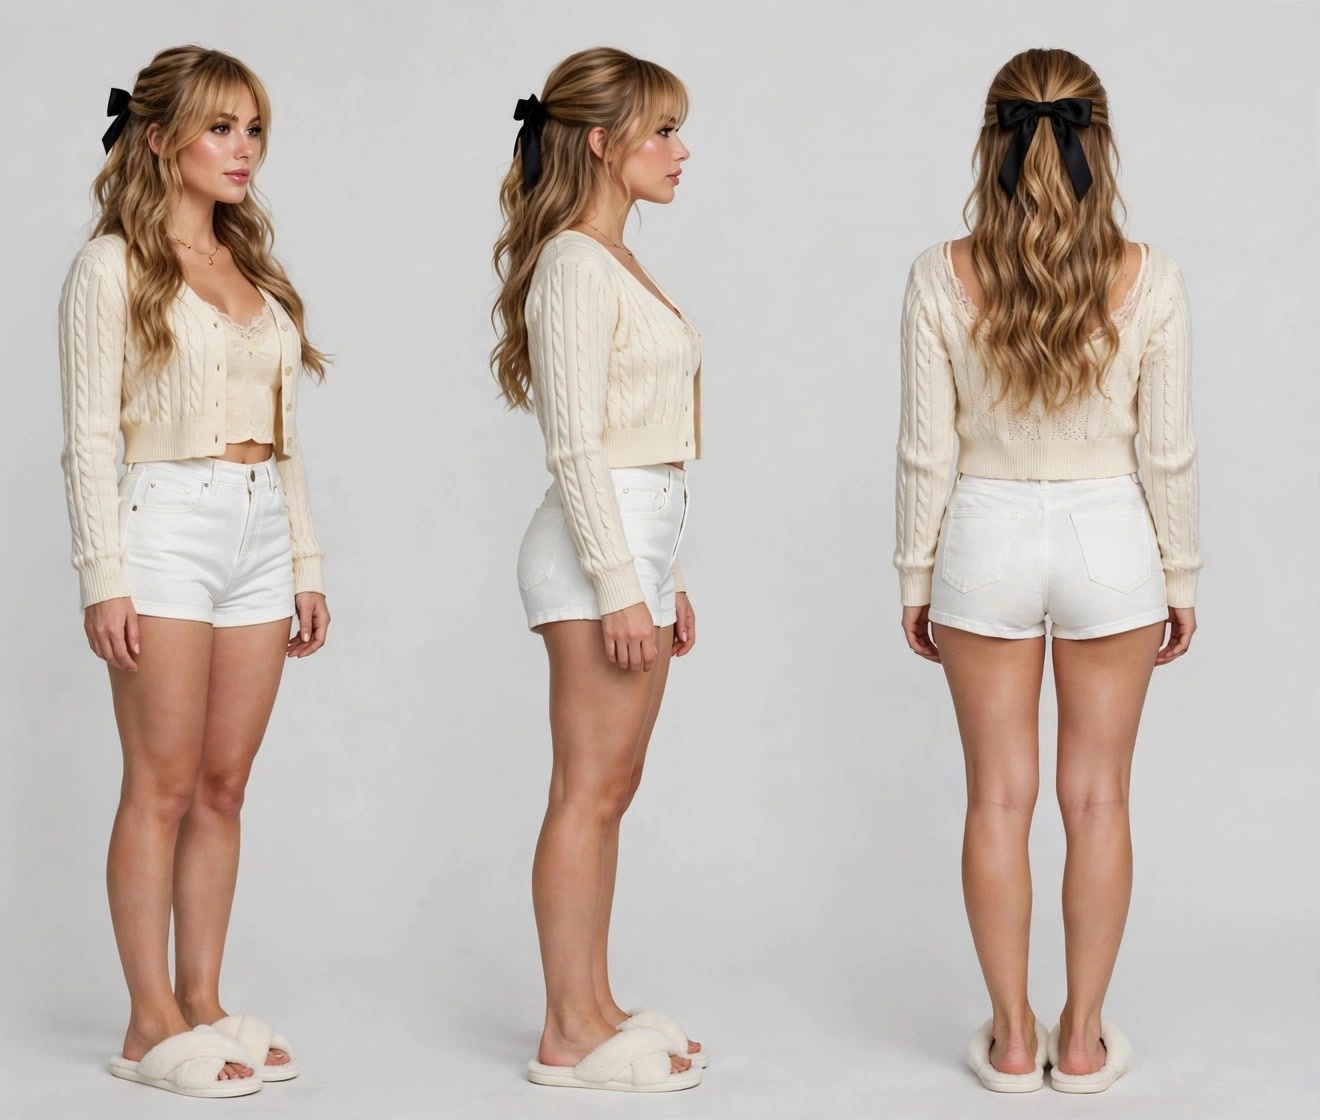
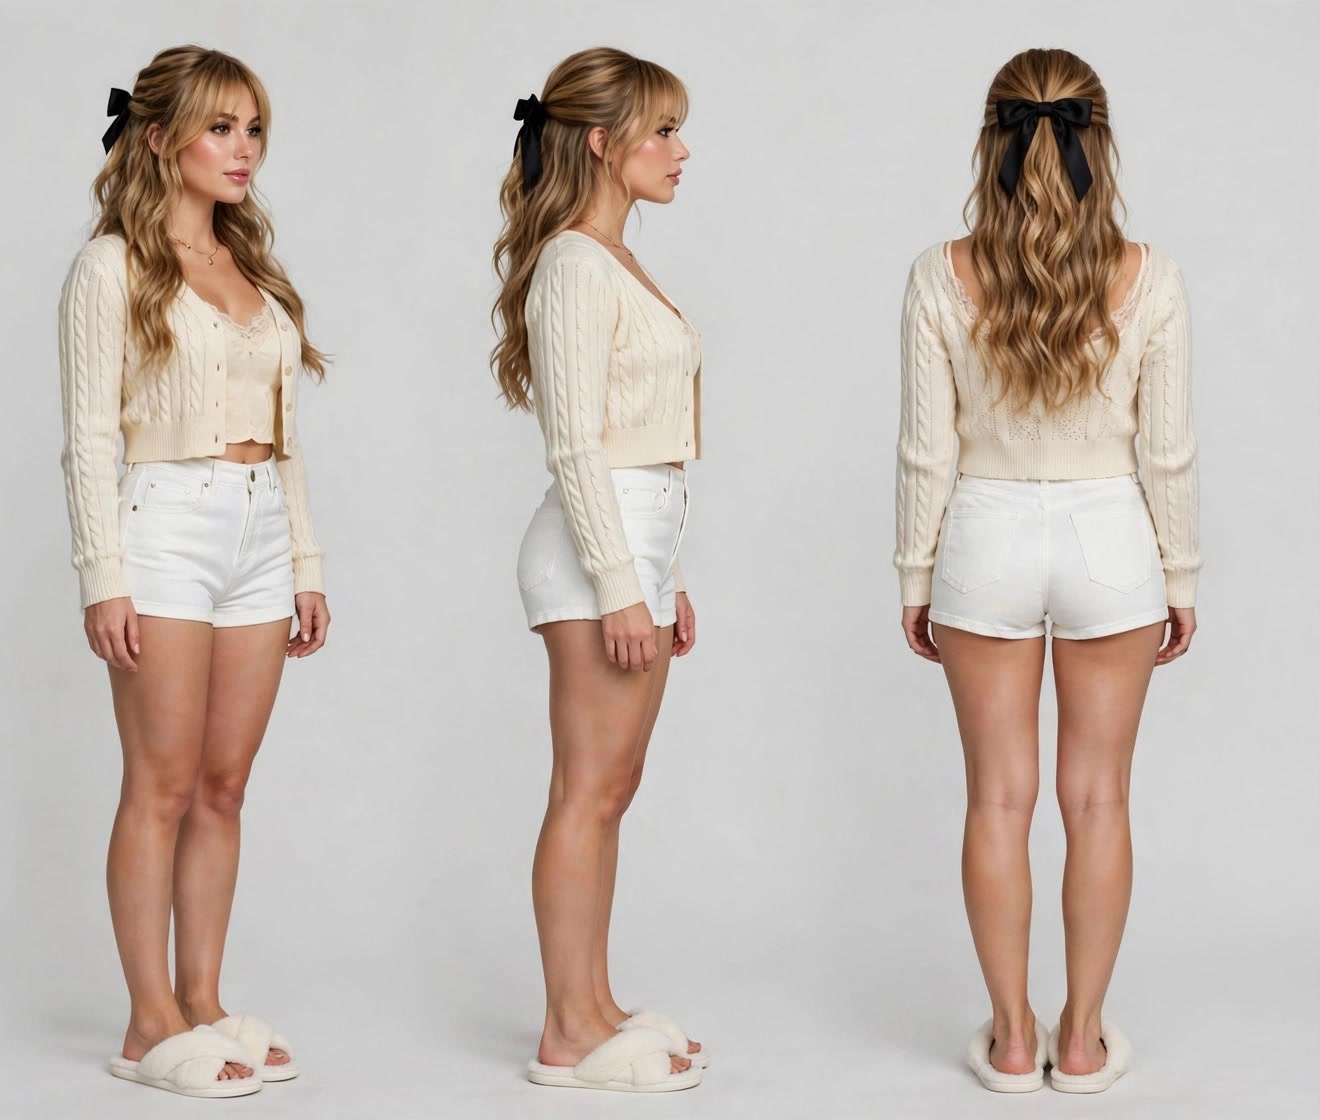
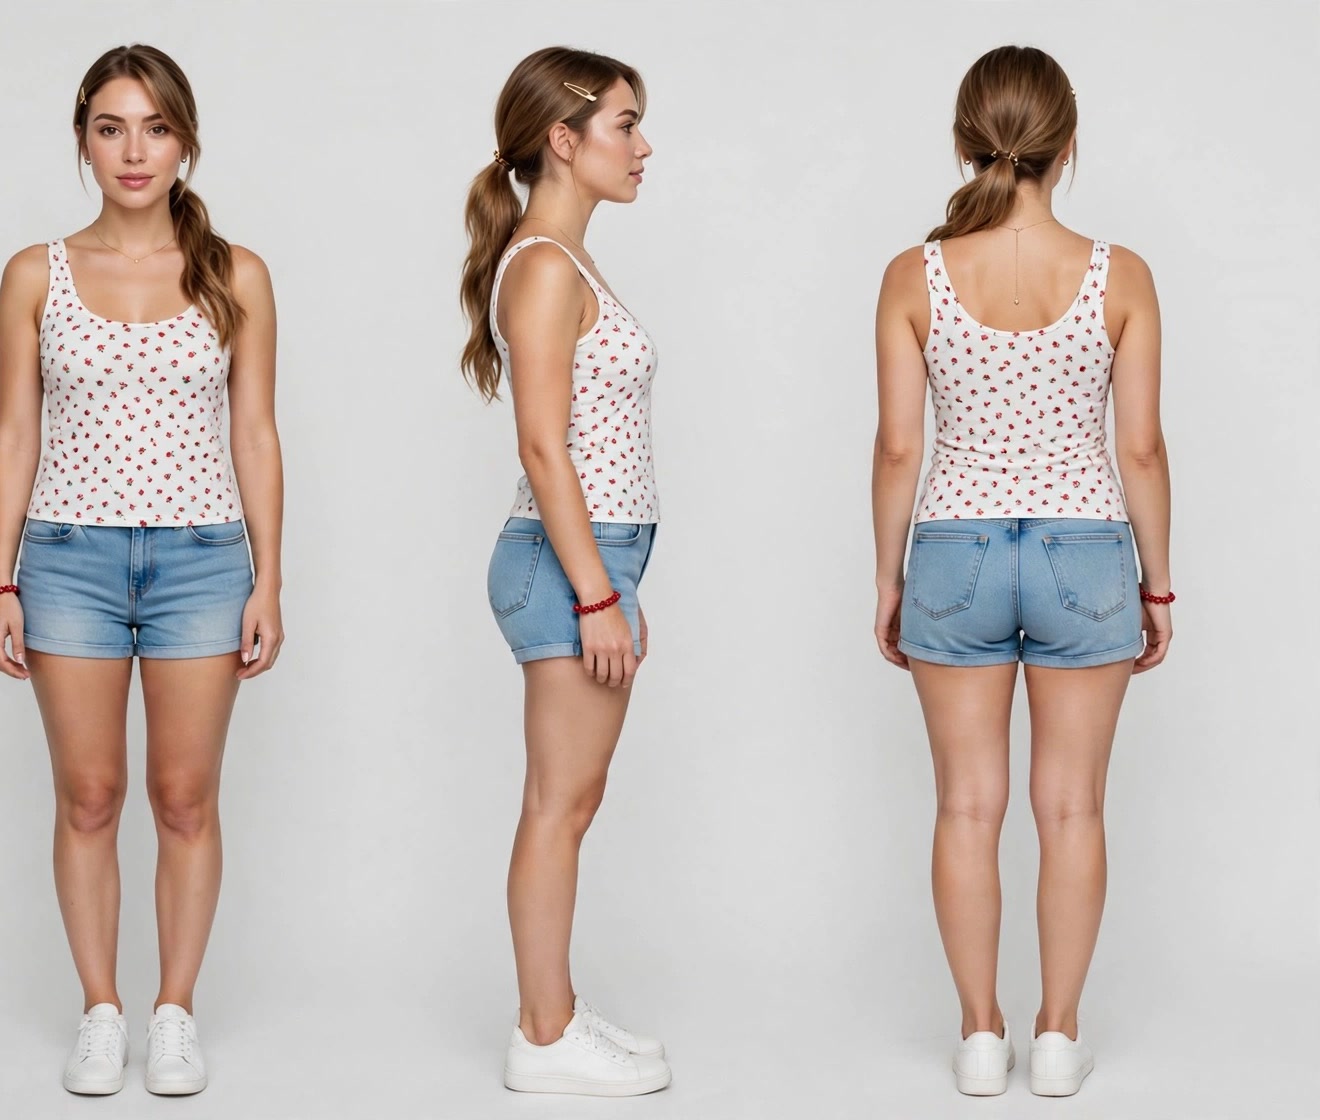
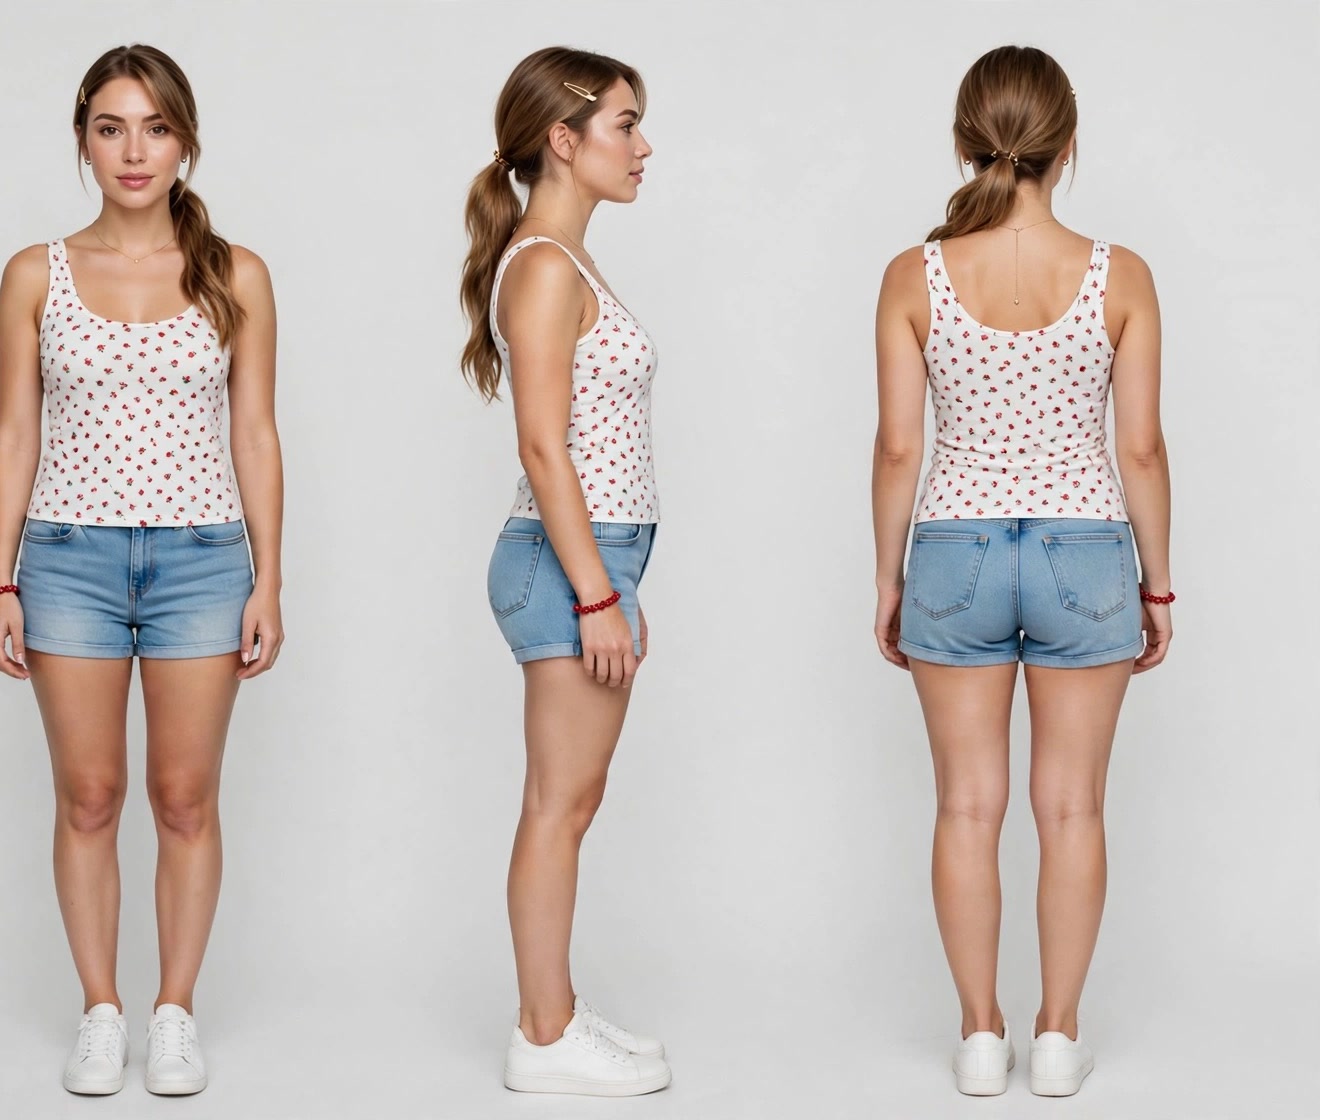
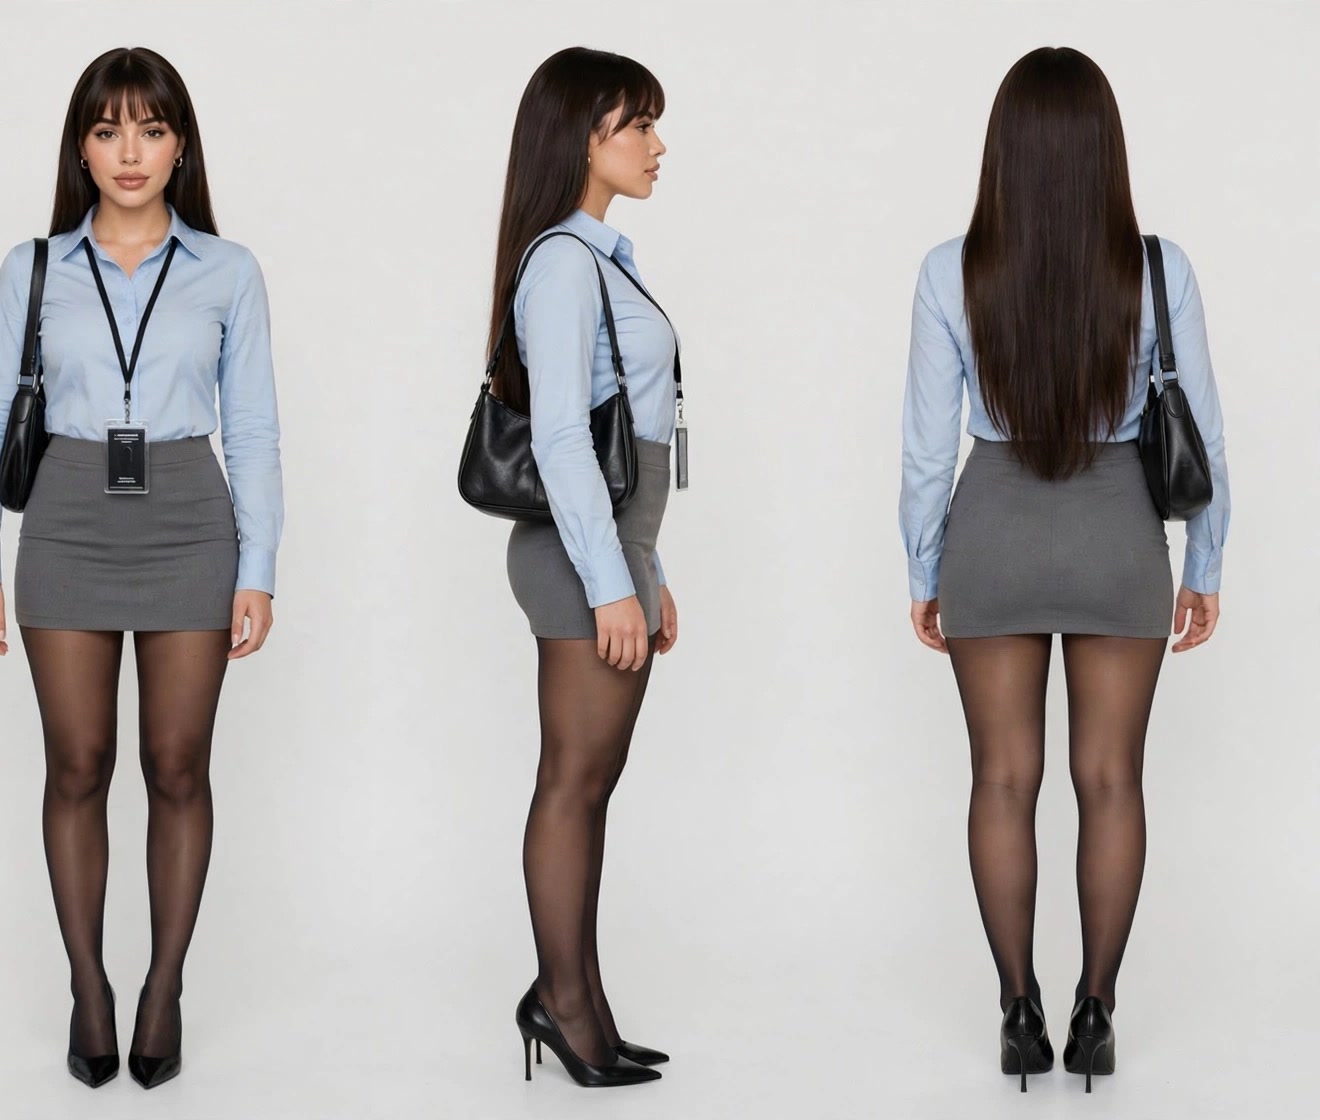
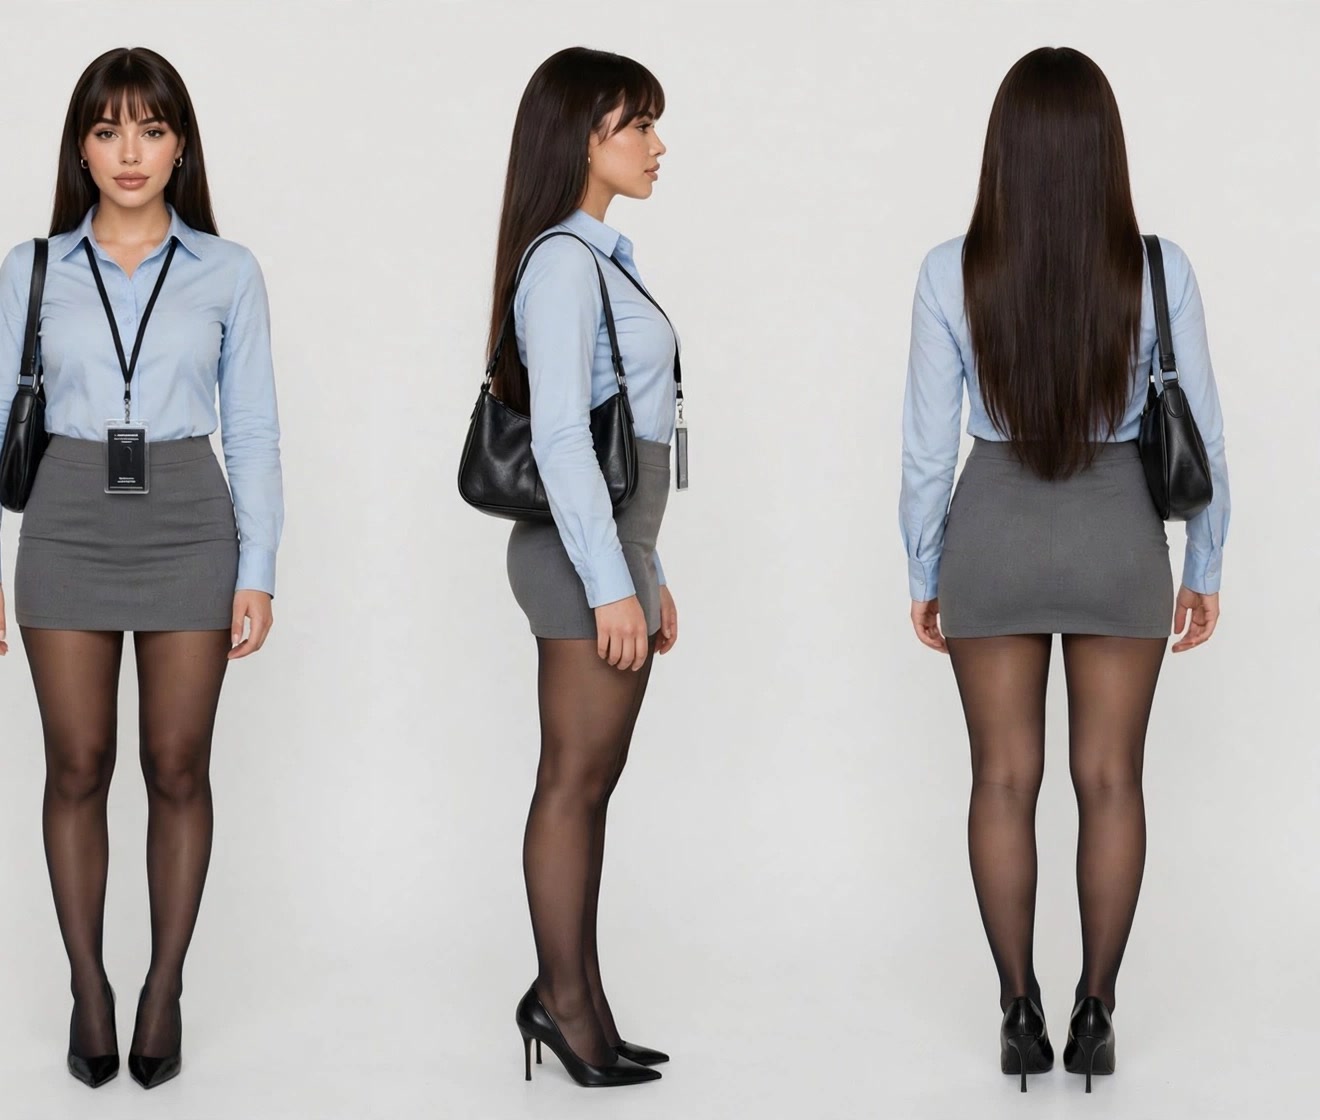
Как сделано: для каждого персонажа мы сгенерировали в Muse Image лист персонажа (портрет рядом с видами спереди, сбоку и сзади), разрезали его на две картинки и отправили обе как референсы (images) вместе с промптом на 10 секунд в 9:16; кухонный влог — 16:9. Промпты расписывают действие по секундам, одежда закрытая, у героини одна короткая реплика на английском. Лицо и одежда сохраняются от плана к плану, а второй дубль того же промпта (пары A / B) показывает, насколько меняется каждая генерация. Три промпта адаптированы из опубликованных в X, источник указан в карточке.
Took you long enough. I already ordered yours.Референсы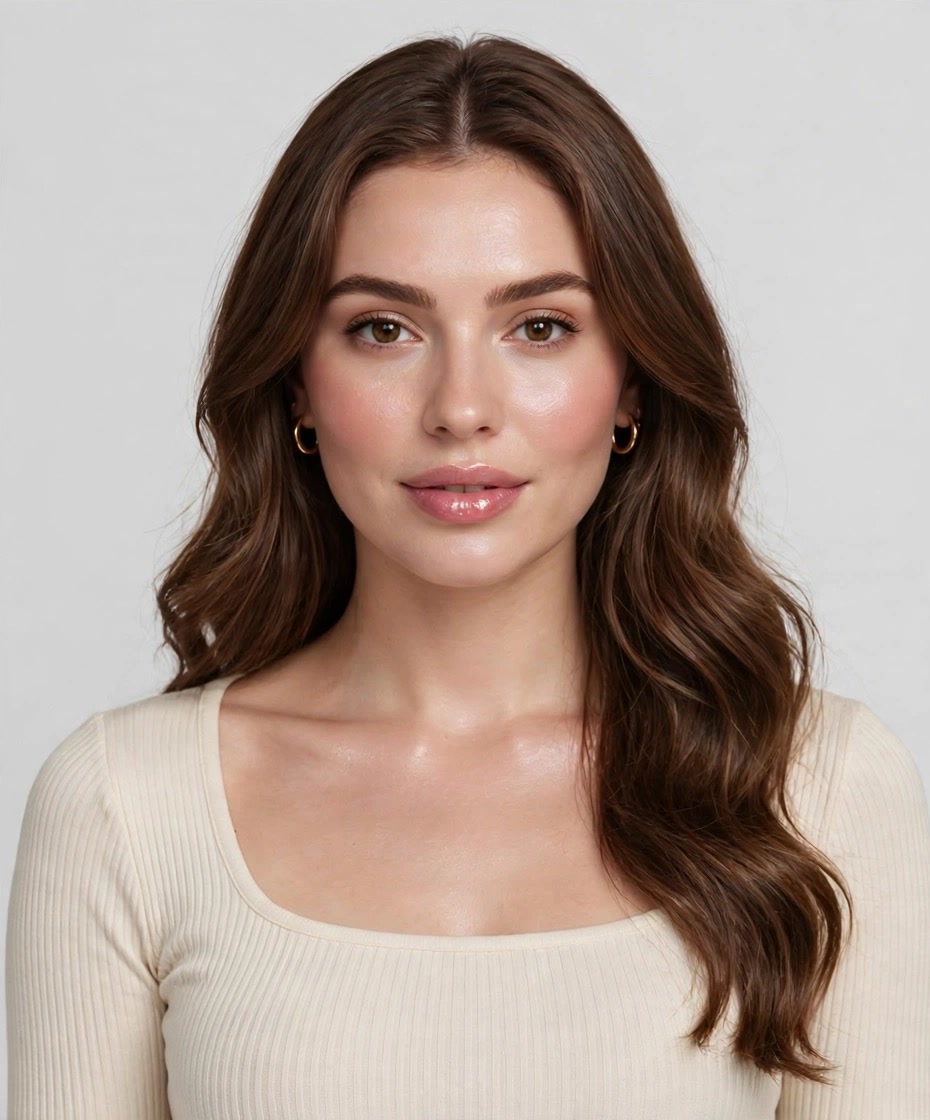
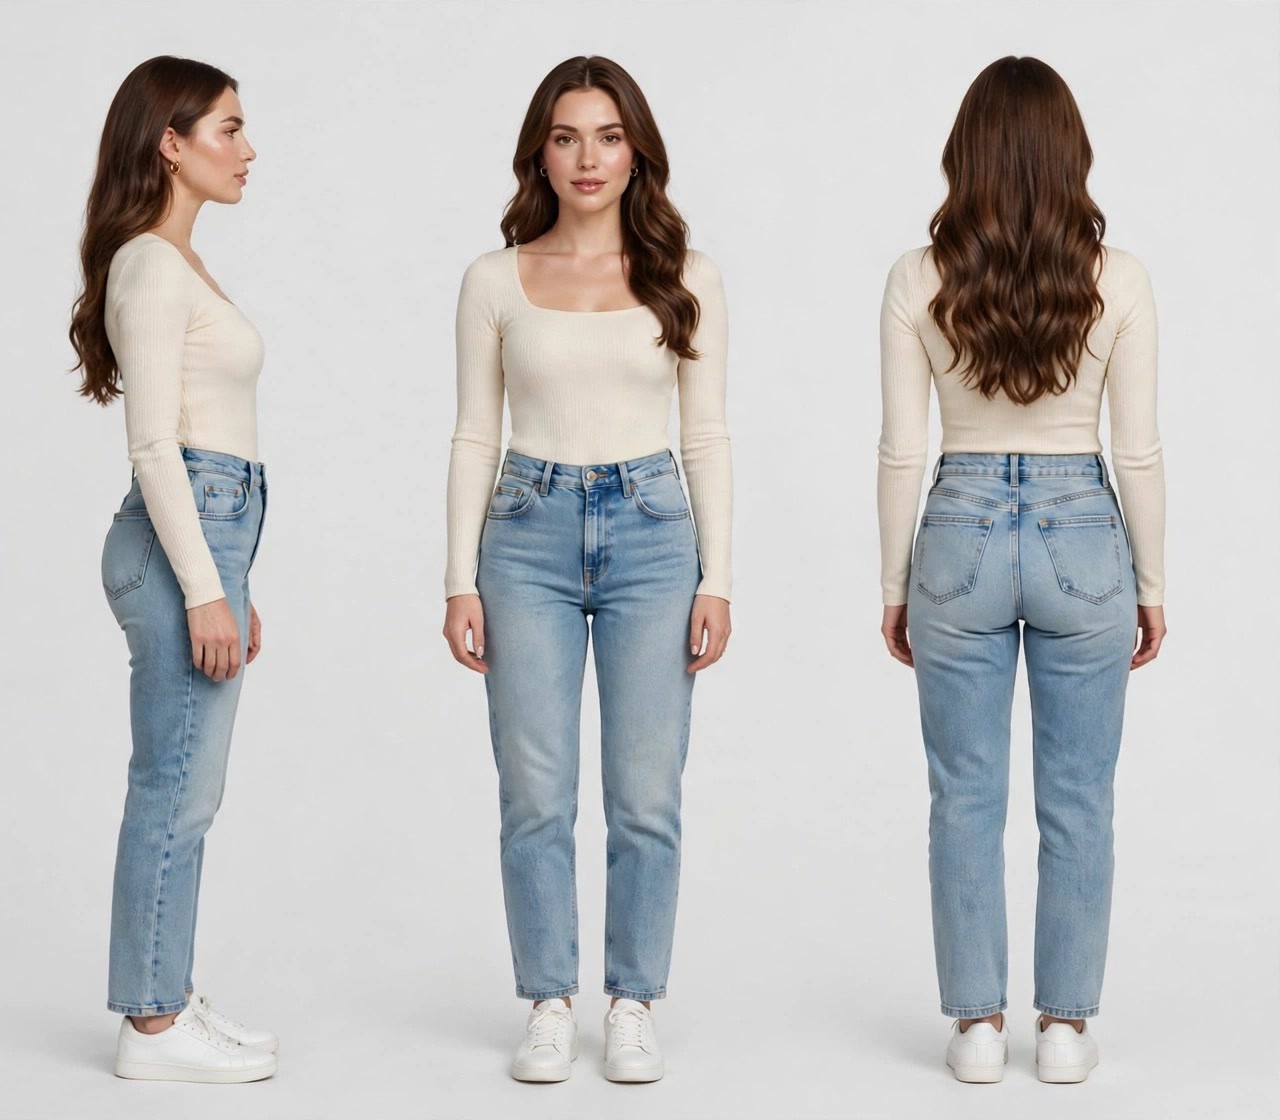
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Coffee date. Scene: a sunny corner café, window seat, a small wooden table with two iced oat lattes, soft morning light through the window, the street blurred outside, a few customers far in the background.
Camera: the viewer's point of view, sitting across the table from her, eye level, one continuous take, no cuts.
0.0–1.5 s: she rests her chin on one hand and stirs her latte with the straw, looking down with a small smile.
1.5–3.0 s: she looks up into the lens, raises one eyebrow and her smile widens.
3.0–5.0 s: she says, warm and teasing: "Took you long enough. I already ordered yours." and slides the second latte toward the camera with two fingers.
5.0–7.0 s: she tucks a strand of hair behind her ear and leans forward a little on her elbows, holding eye contact, with a soft laugh.
7.0–8.5 s: she taps the table twice and tilts her head toward the empty chair, inviting the viewer to sit.
8.5–10.0 s: she sips her latte and keeps looking into the lens over the straw, eyes smiling, until the end.
Mood: warm, playful, confident, friendly; natural eye contact, nothing exaggerated.
Lighting: soft warm daylight, gentle highlights in her hair, realistic skin texture.

Audio: soft acoustic café music and light café ambience; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, natural colors, crisp focus on her face, gentle handheld motion.
Avoid: changing her face or outfit, revealing or low-cut clothing, see-through fabric, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Come on, the sun's going down!Референсы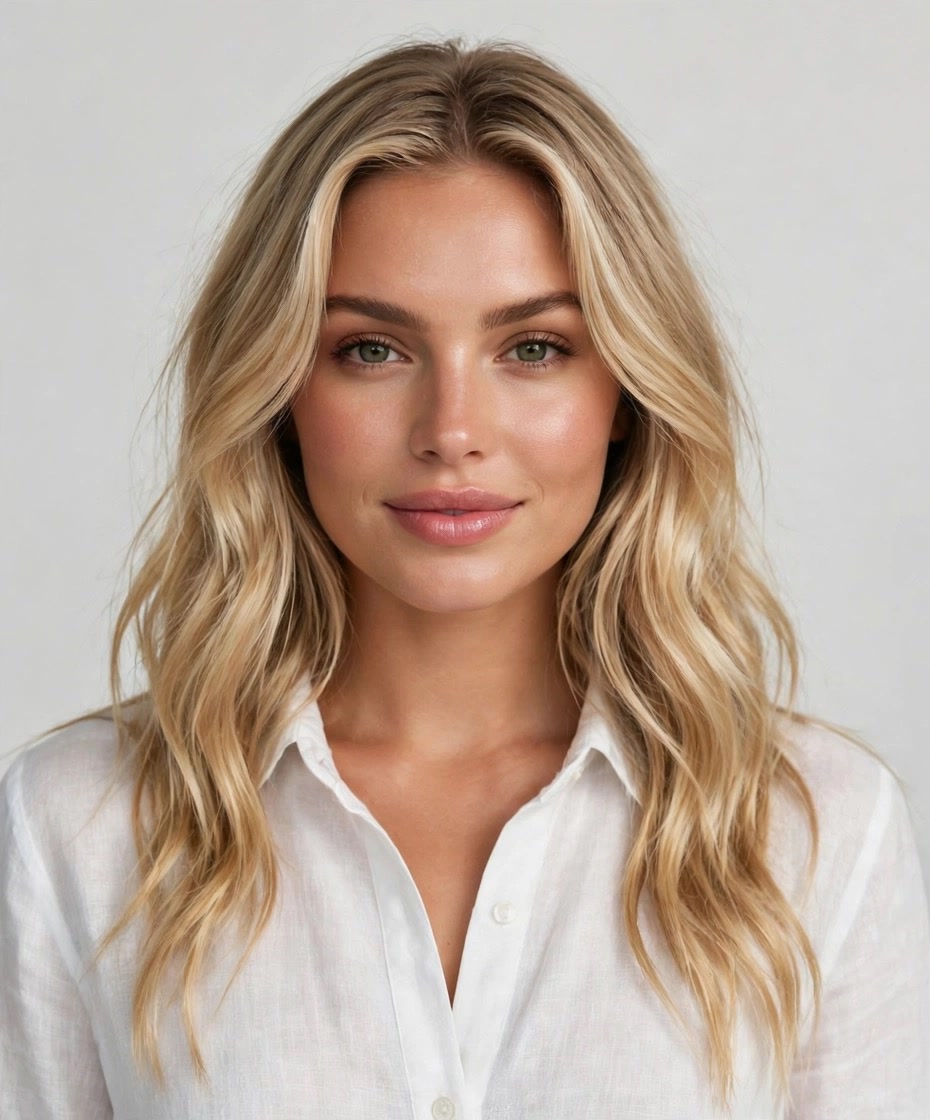
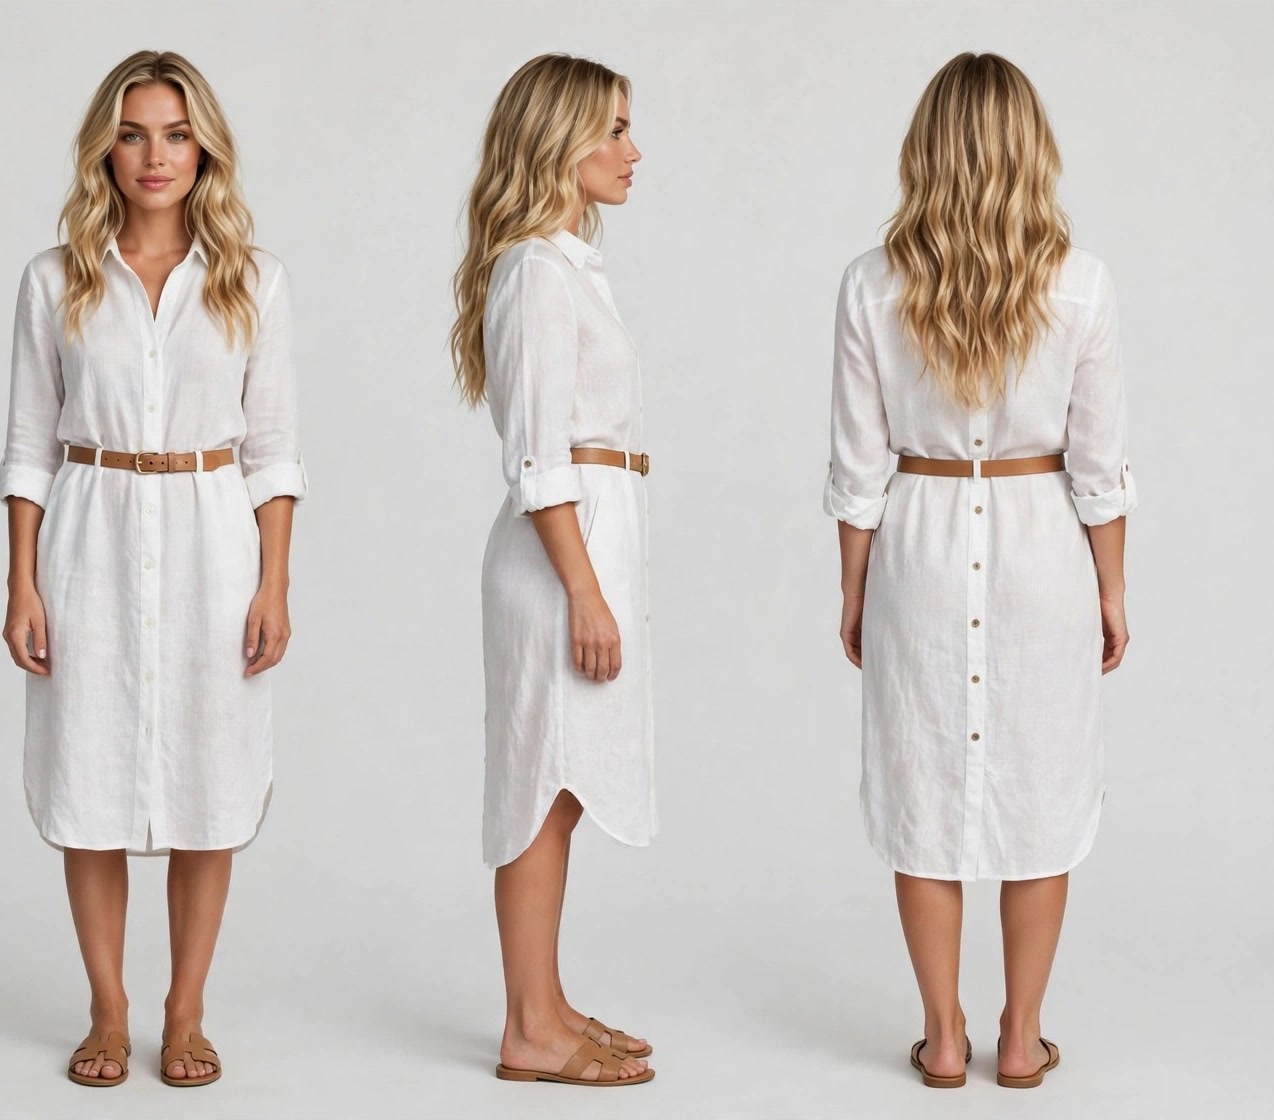
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Golden hour beach. Scene: a wide sandy beach at sunset, gentle waves, the sun low over the ocean, footprints in wet sand, a light sea breeze.
Camera: the viewer walking a few steps behind her, one continuous take, smooth natural movement.
0.0–2.0 s: she walks barefoot along the waterline away from the camera, sandals hanging from one hand, the breeze moving her hair and the hem of her shirt dress.
2.0–3.5 s: she slows down and looks back over her shoulder at the lens with a bright smile.
3.5–5.5 s: she turns around, walks backwards for a few steps and reaches one hand toward the camera, palm up, saying: "Come on, the sun's going down!"
5.5–7.5 s: the camera moves closer; she laughs and pushes her windblown hair off her face, eyes on the lens.
7.5–9.0 s: she takes a little splash step in the shallow water and glances back with a playful grin.
9.0–10.0 s: she stops and faces the camera with the sunset behind her, tilts her head and smiles softly, holding eye contact.
Mood: carefree, warm, inviting, romantic but natural.
Lighting: golden backlight, soft lens flare, warm skin tones, rim light on her hair.

Audio: dreamy indie pop music with soft waves and wind; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, natural colors, crisp focus on her face, gentle handheld motion.
Avoid: changing her face or outfit, revealing or low-cut clothing, see-through fabric, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Have you read this one?Референсы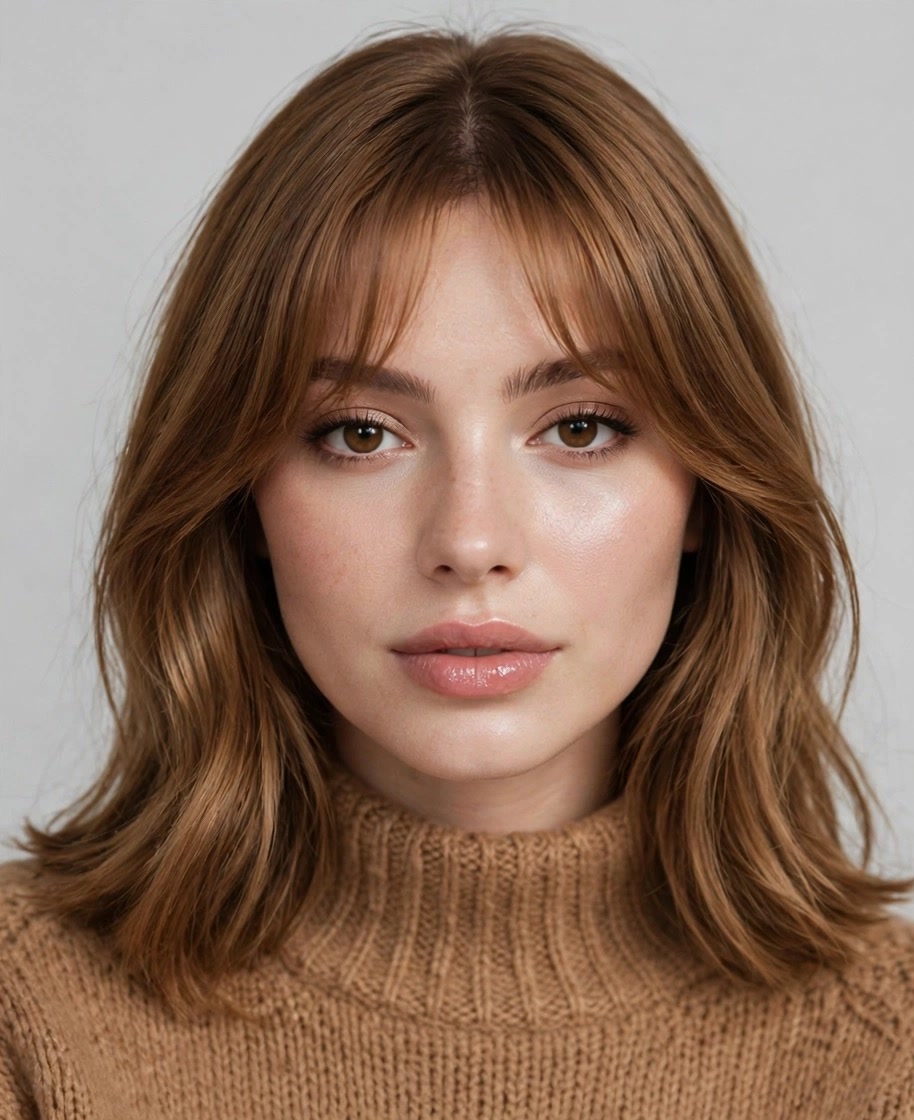
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Bookstore. Scene: a cozy independent bookstore, tall wooden shelves, warm reading lamps, a rolling ladder, soft afternoon light, a few customers far in the background.
Camera: the viewer standing in the aisle facing her, one continuous take, a slow push-in.
0.0–1.5 s: she peeks out from behind the end of a bookshelf, only half her face visible, eyes on the lens.
1.5–3.0 s: she steps out holding a book up so it covers her nose and mouth, her eyes smiling above it.
3.0–4.5 s: she slowly lowers the book to reveal a playful smile.
4.5–6.5 s: she taps the cover and whispers: "Have you read this one?"
6.5–8.0 s: she leans her shoulder against the shelf, hugging the book to her chest, and tilts her head.
8.0–10.0 s: she bites back a smile, glances down, then looks up again through her lashes and holds eye contact.
Mood: sweet, curious, playful, intimate but wholesome.
Lighting: warm tungsten lamps, soft window light, cozy amber tones.
Book covers stay plain, with no readable text.

Audio: soft piano and acoustic guitar music with a quiet bookstore ambience; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, natural colors, crisp focus on her face, gentle handheld motion.
Avoid: changing her face or outfit, revealing or low-cut clothing, see-through fabric, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Mine's better.Референсы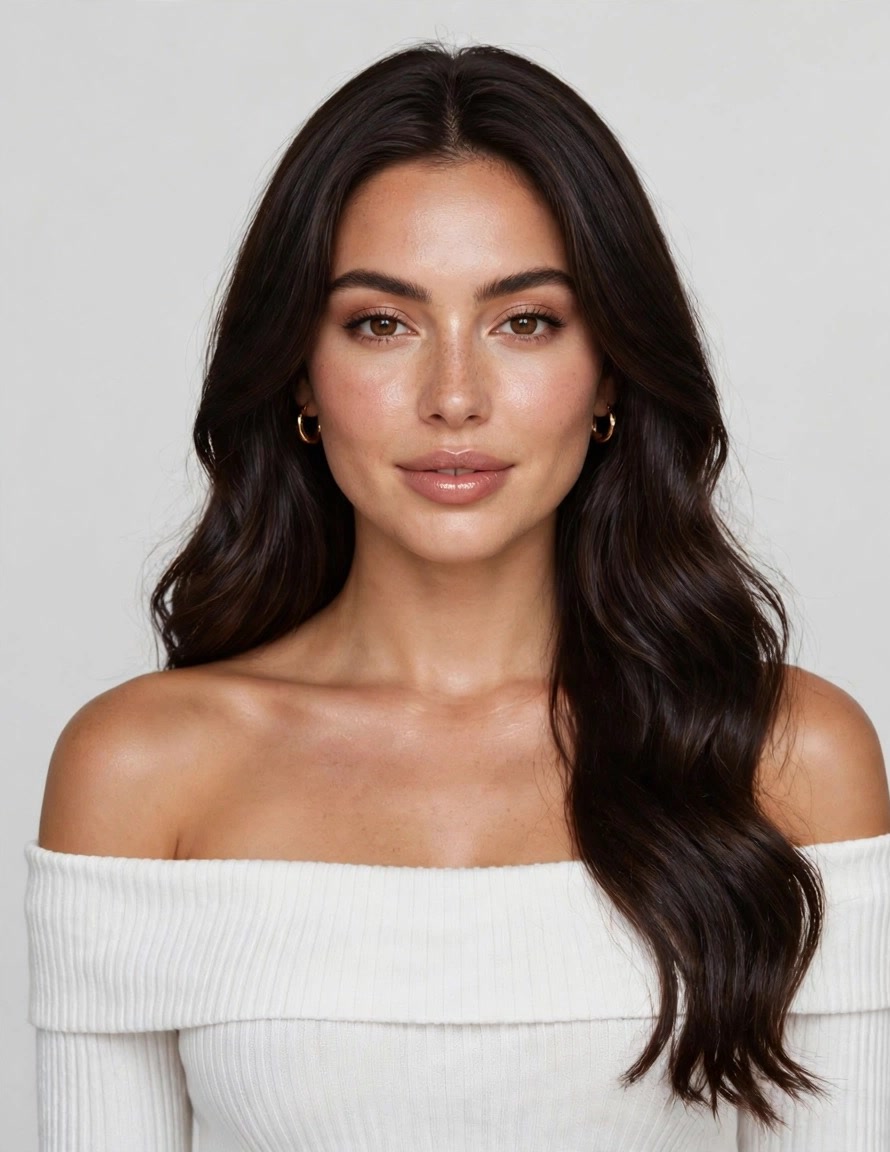
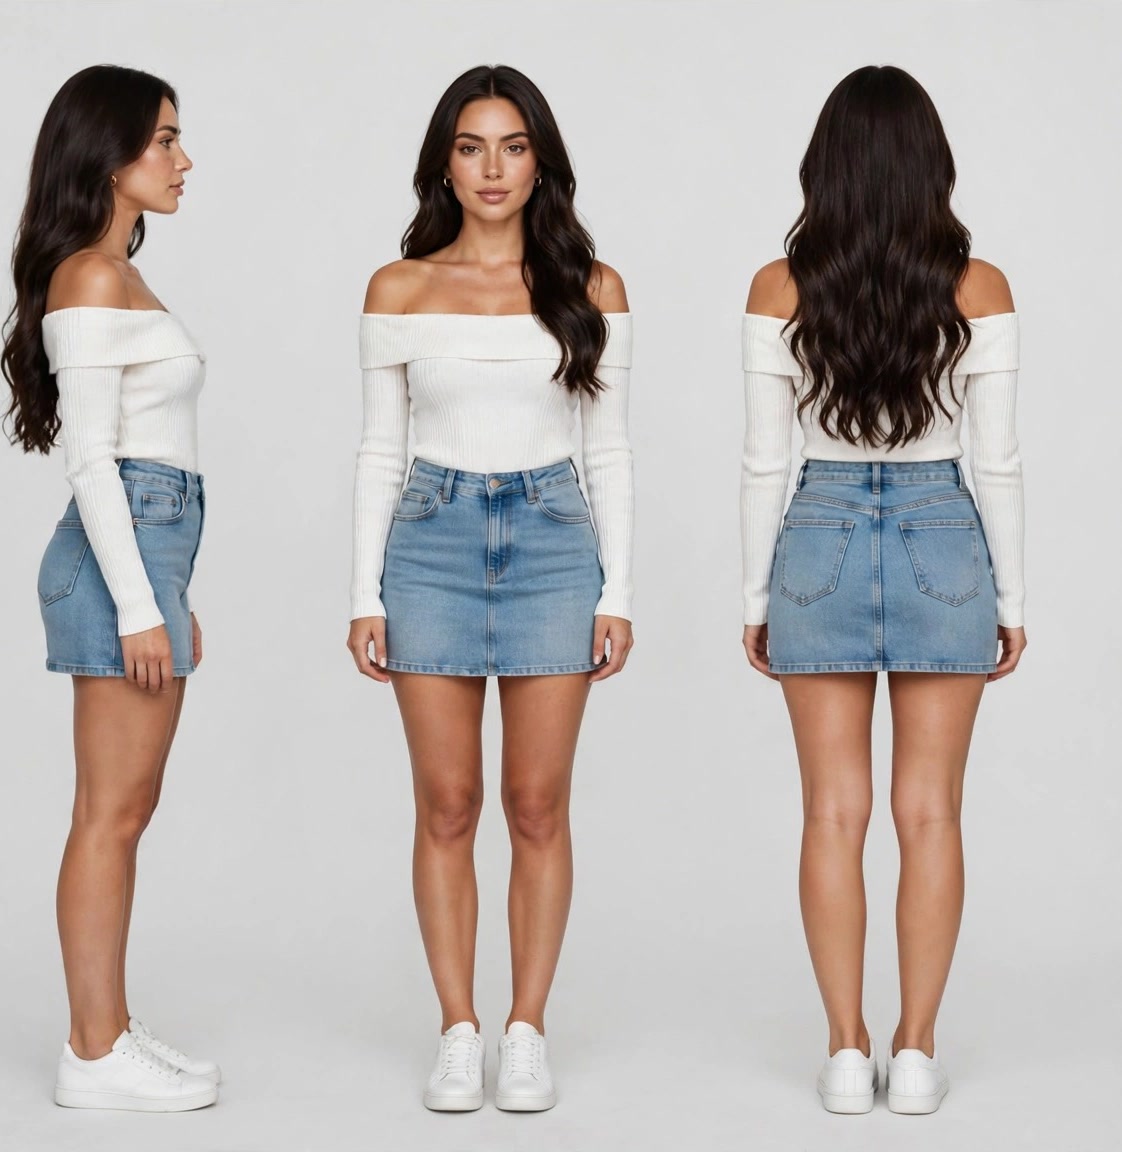
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman in a light summer outfit (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Outdoor café date. Scene: a sunny café terrace on a quiet European-style street, a small round marble table with two cappuccinos and a croissant, a striped awning, potted flowers, soft morning sun.
Camera: the viewer's point of view sitting across the small table, very close to her, eye level.
0.0–1.5 s: she rests her chin on her interlaced fingers, watching the lens with a slow half-smile.
1.5–3.0 s: she reaches across, takes the viewer's cappuccino instead of her own and sips it, eyes on the lens over the cup.
3.0–4.5 s: she wipes a little milk foam from her lip with her thumb and laughs.
4.5–6.0 s: she says, teasing: "Mine's better." and slides her own cup toward the camera.
6.0–8.0 s: she leans in close to the lens on her elbows, her bare shoulders catching the sun, lightly bites her lower lip and holds eye contact.
8.0–10.0 s: she leans back, tucks her hair behind her ear and gives one playful wink.
Lighting: soft warm morning sun, gentle highlights on her hair and shoulders.
Flirt cues (natural and playful, never explicit): long lingering eye contact with the lens, a slow half-smile, lightly biting her lower lip once, glancing down and then back up through her lashes, leaning in close to the lens as if sharing a secret, at most one playful wink. She is clearly enjoying the viewer's company.

Audio: light French café jazz and soft street ambience; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, warm natural colors, crisp focus on her face, gentle handheld motion, one continuous take.
Avoid: changing her face or outfit, cleavage, lingerie, swimwear, see-through fabric, kissing, touching her own body suggestively, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Sit with me.Референсы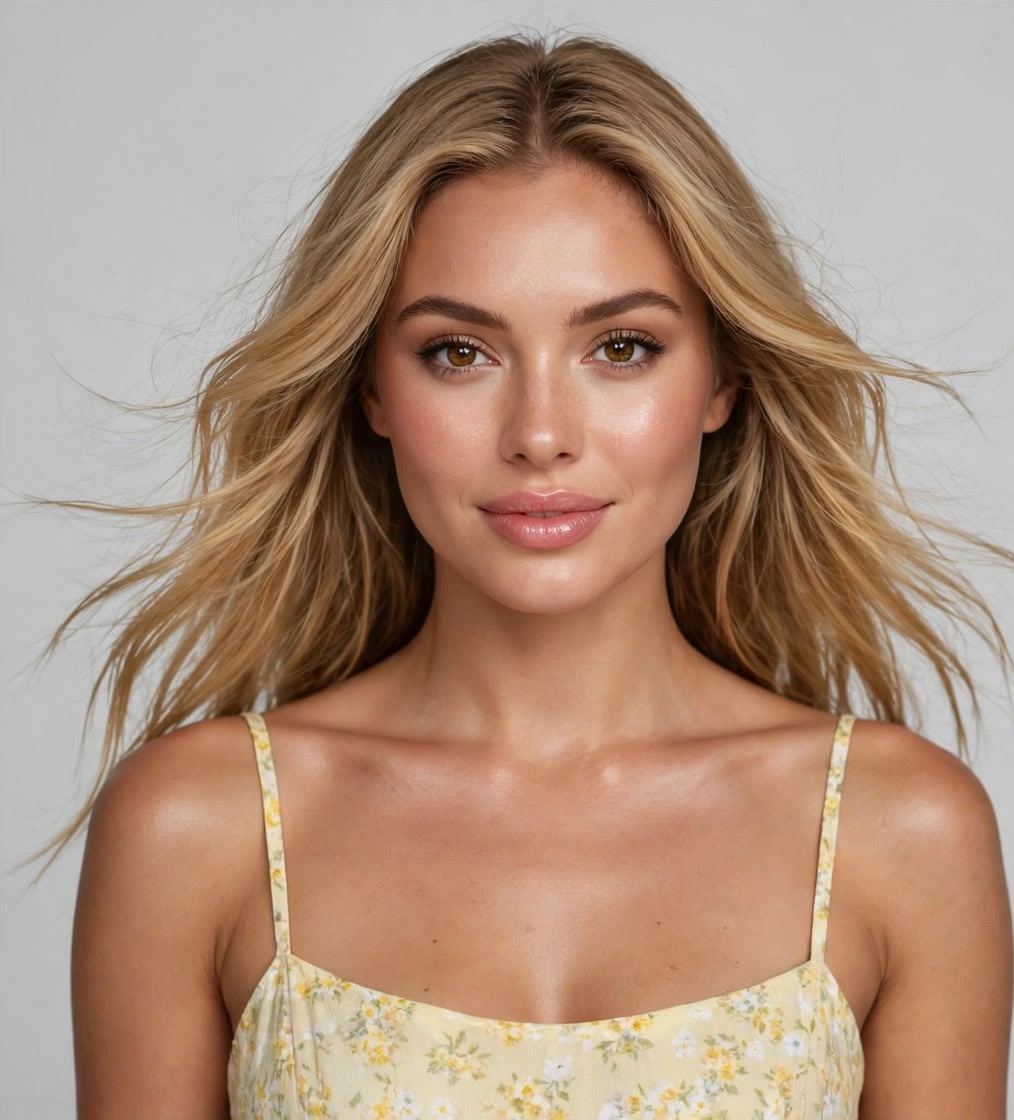
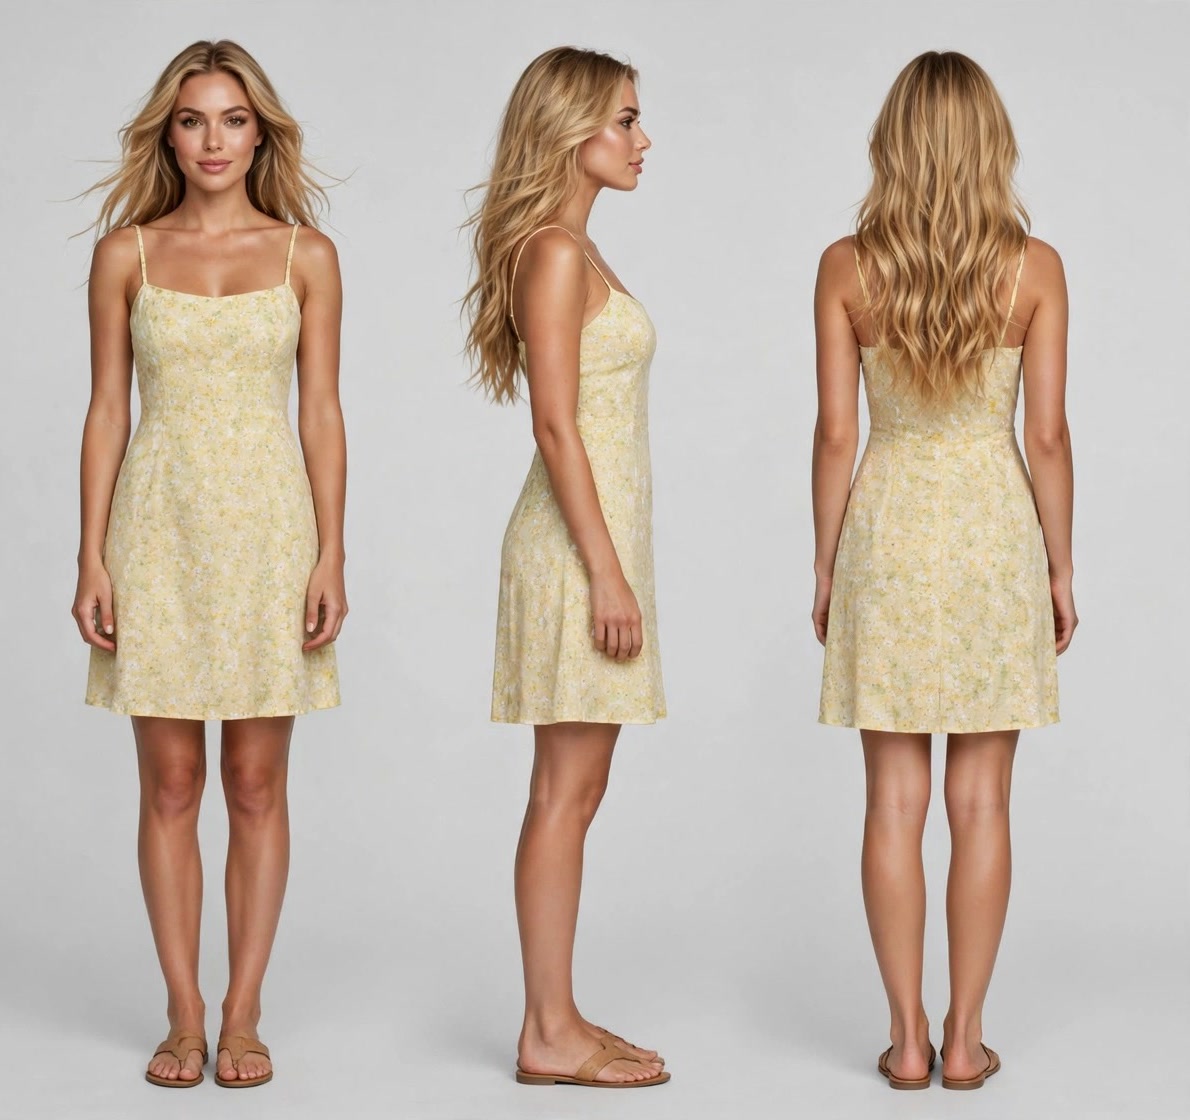
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman in a light summer outfit (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Sunset pier. Scene: a wooden pier over calm water at sunset, golden light, a pink and orange sky, a gentle breeze.
Camera: the viewer walking up to her and then sitting down right beside her.
0.0–2.0 s: she sits on the edge of the pier, legs dangling over the water, sandals beside her, the breeze lifting her hair and the hem of her sundress.
2.0–3.5 s: she hears the viewer, looks back over her shoulder and her face breaks into a soft smile.
3.5–5.0 s: she pats the boards right next to her and says: "Sit with me."
5.0–7.0 s: the camera lowers to sit beside her, very close; she turns her face to the lens, sunset light on her skin, and lets her gaze linger.
7.0–8.5 s: she leans her shoulder lightly toward the camera, looks down at the water, then back up through her lashes.
8.5–10.0 s: she rests her chin on her hand and smiles at the lens as the sun dips behind her.
Lighting: golden backlight, soft lens flare, warm glowing skin.
Flirt cues (natural and playful, never explicit): long lingering eye contact with the lens, a slow half-smile, lightly biting her lower lip once, glancing down and then back up through her lashes, leaning in close to the lens as if sharing a secret, at most one playful wink. She is clearly enjoying the viewer's company.

Audio: dreamy acoustic indie music with soft water and wind; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, warm natural colors, crisp focus on her face, gentle handheld motion, one continuous take.
Avoid: changing her face or outfit, cleavage, lingerie, swimwear, see-through fabric, kissing, touching her own body suggestively, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.This part reminds me of you.Референсы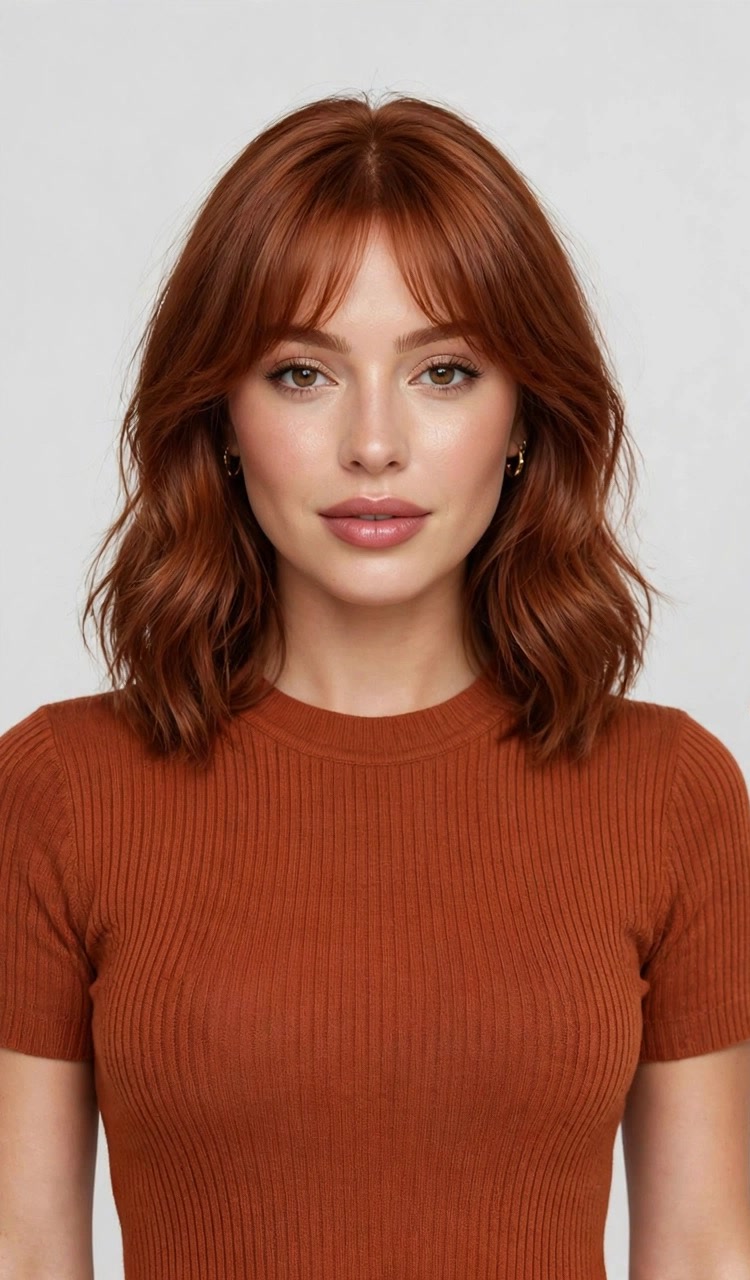
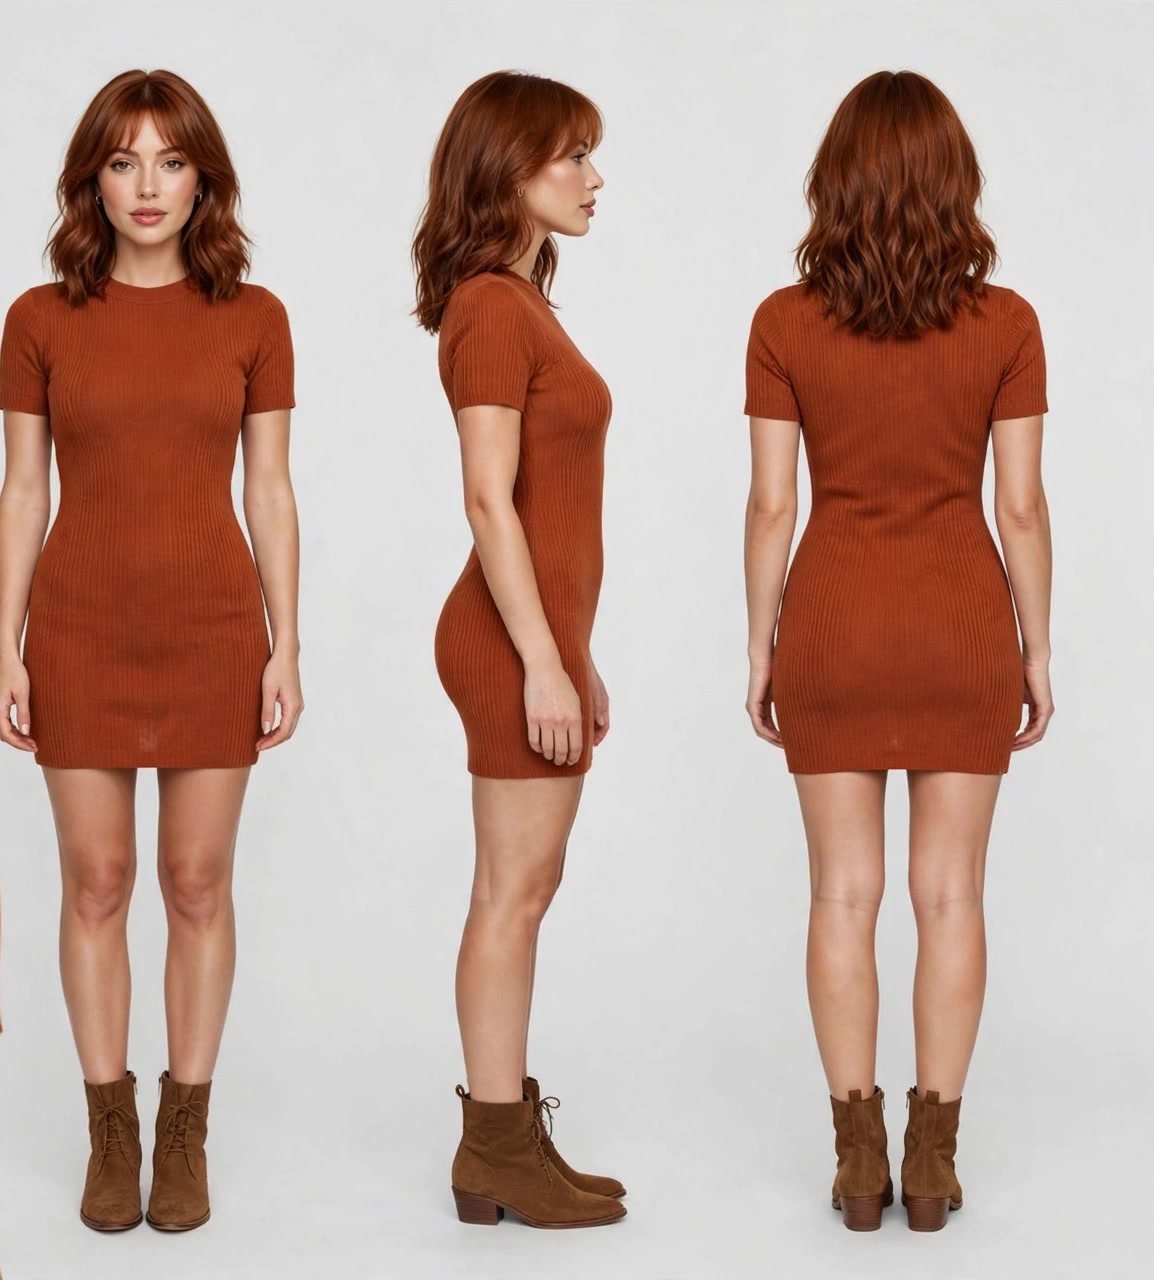
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman in a light summer outfit (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Bookstore reading nook. Scene: a cozy window seat in an independent bookstore, cushions, stacks of books, warm lamp light mixed with late-afternoon sun.
Camera: the viewer sitting down next to her on the window seat, close.
0.0–1.5 s: she sits curled up on the window seat reading an open book, a strand of hair falling across her face.
1.5–3.0 s: she glances up over the top of the book at the lens, then back down, hiding a smile.
3.0–5.0 s: she lowers the book and says softly: "This part reminds me of you."
5.0–7.0 s: she shifts closer and holds the open book toward the camera, her face close to the lens.
7.0–8.5 s: she watches the viewer's reaction, lightly bites her lower lip and laughs quietly.
8.5–10.0 s: she closes the book against her chest, tilts her head and holds eye contact with a soft smile.
Book pages and covers stay plain, with no readable text.
Lighting: warm amber lamps, soft window light on her face.
Flirt cues (natural and playful, never explicit): long lingering eye contact with the lens, a slow half-smile, lightly biting her lower lip once, glancing down and then back up through her lashes, leaning in close to the lens as if sharing a secret, at most one playful wink. She is clearly enjoying the viewer's company.

Audio: soft piano and acoustic guitar music with a quiet bookstore ambience; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, warm natural colors, crisp focus on her face, gentle handheld motion, one continuous take.
Avoid: changing her face or outfit, cleavage, lingerie, swimwear, see-through fabric, kissing, touching her own body suggestively, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Just one bite.Референсы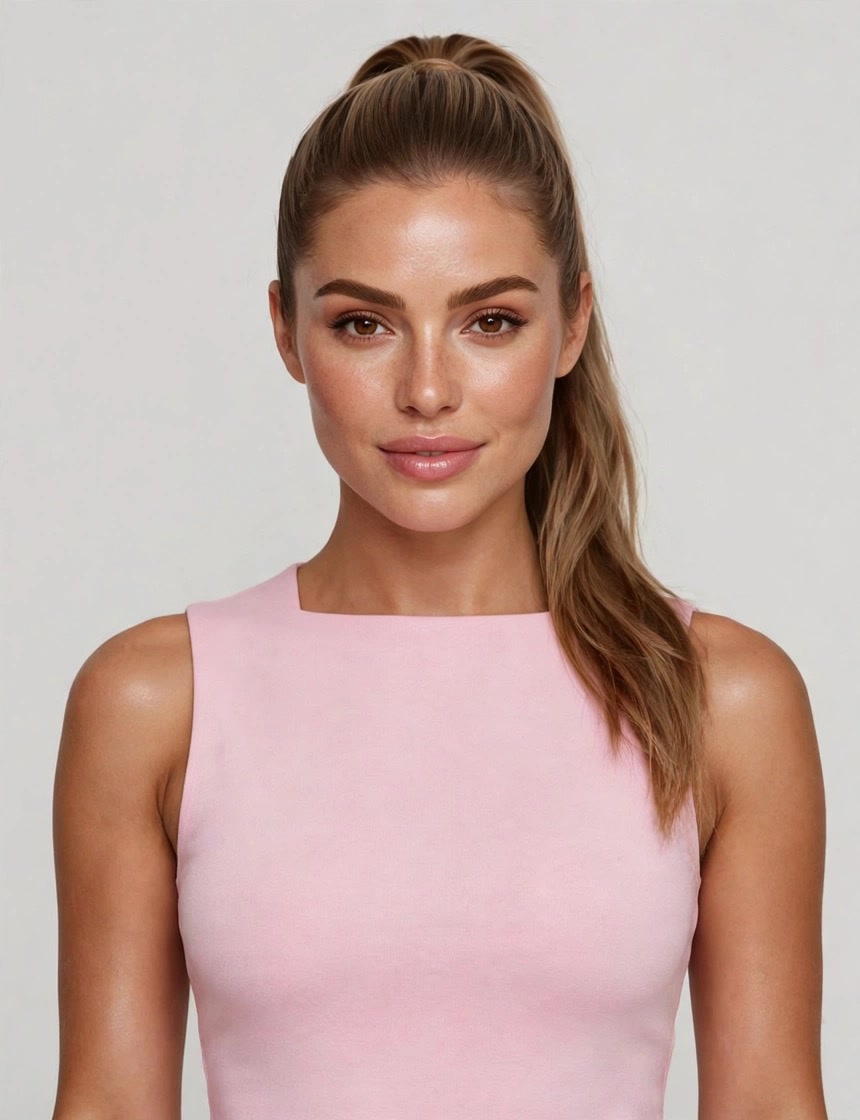
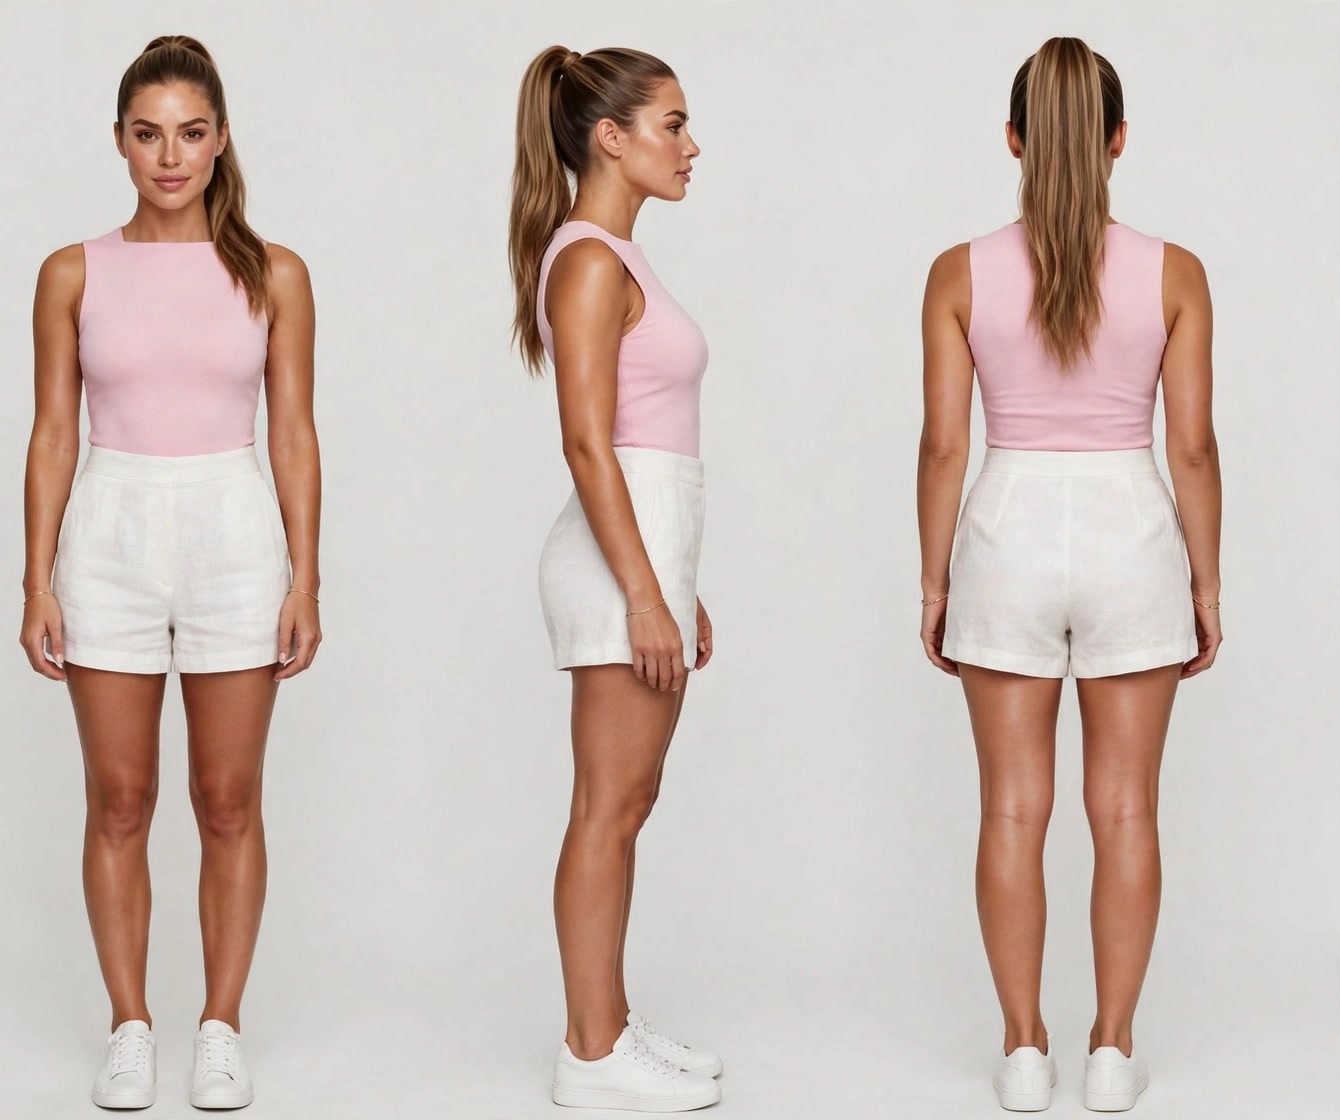
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman in a light summer outfit (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Ice cream on the promenade. Scene: a sunny seaside promenade in summer, pastel shopfronts, palm trees, people strolling far in the background.
Camera: the viewer walking beside her, then facing her.
0.0–1.5 s: she walks along holding a strawberry ice-cream cone and takes a small bite.
1.5–3.0 s: she notices the viewer watching and holds the cone out toward the camera, eyebrows raised.
3.0–4.5 s: as the camera leans in, she pulls it back with a playful laugh and says: "Just one bite."
4.5–6.5 s: she holds it out again, closer this time, watching the lens with a teasing half-smile.
6.5–8.5 s: she gets a tiny dot of ice cream on the tip of her nose, laughs and wipes it off.
8.5–10.0 s: she swings her ponytail, turns to keep walking and glances back at the lens with a wink.
Lighting: bright summer sun, warm tones, soft shadows.
Flirt cues (natural and playful, never explicit): long lingering eye contact with the lens, a slow half-smile, lightly biting her lower lip once, glancing down and then back up through her lashes, leaning in close to the lens as if sharing a secret, at most one playful wink. She is clearly enjoying the viewer's company.

Audio: upbeat summer pop music and light seaside ambience; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, warm natural colors, crisp focus on her face, gentle handheld motion, one continuous take.
Avoid: changing her face or outfit, cleavage, lingerie, swimwear, see-through fabric, kissing, touching her own body suggestively, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Open up.Референсы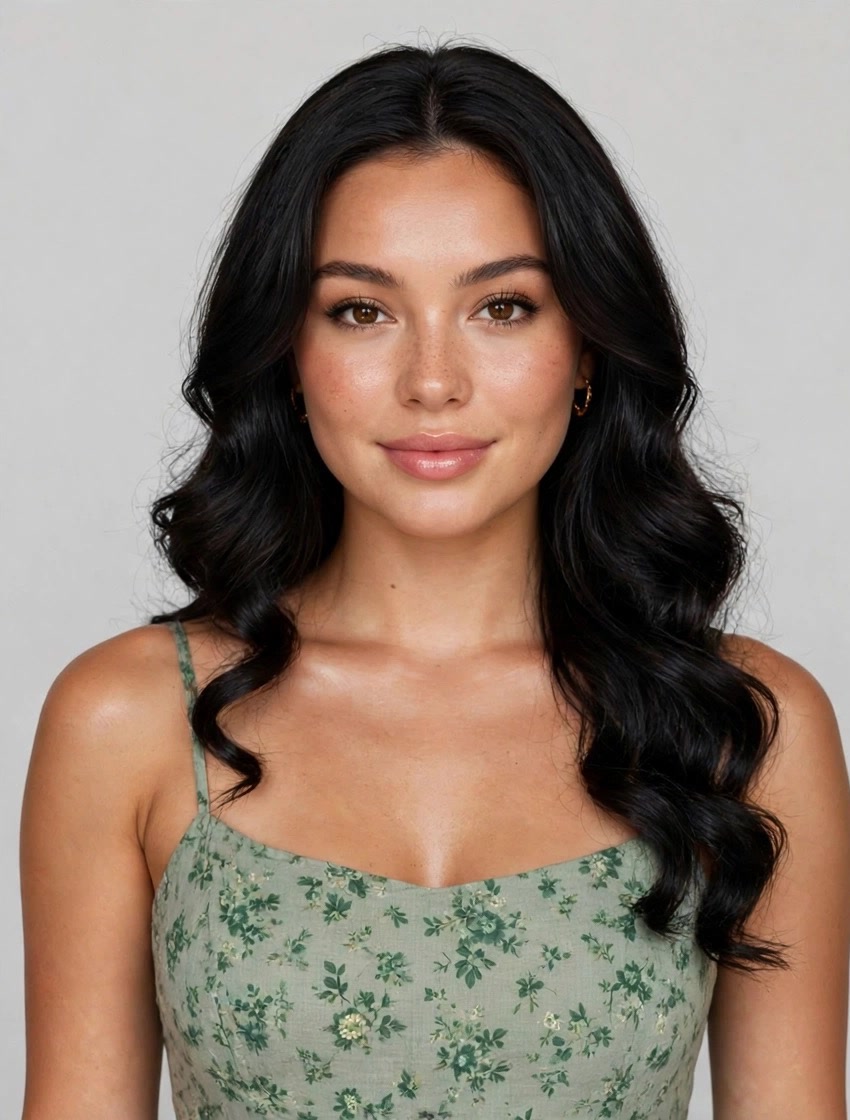
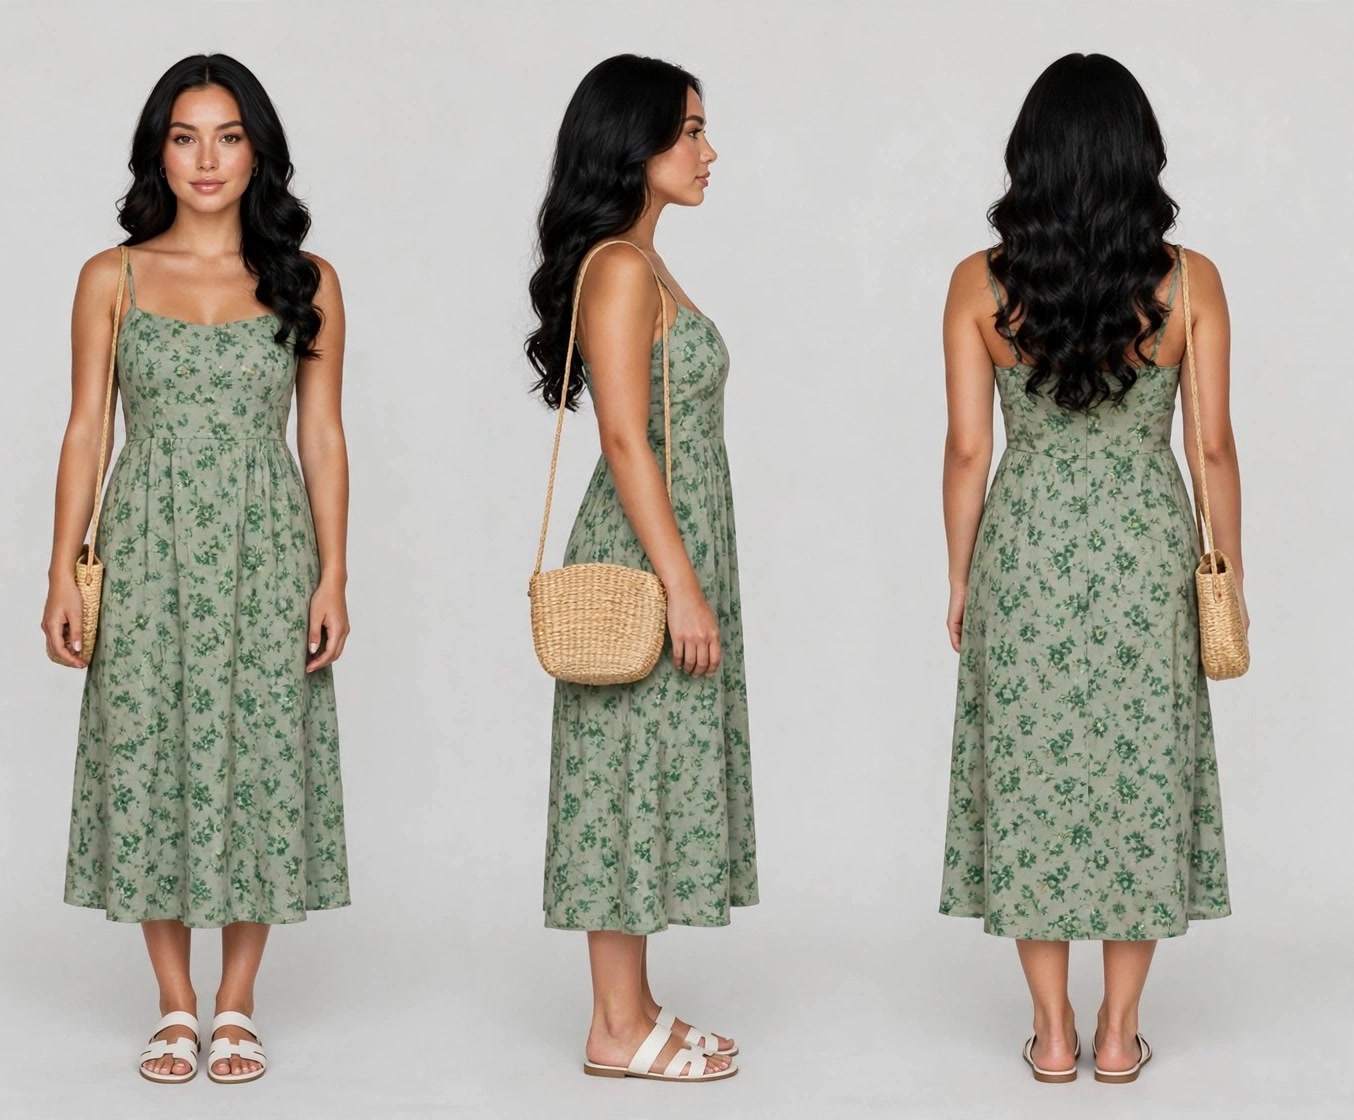
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman in a light summer outfit (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Park picnic. Scene: a summer picnic in a park, a checkered blanket on the grass under a big tree, a wicker basket, a bowl of strawberries, dappled golden sunlight.
Camera: the viewer lying on the blanket facing her, low angle.
0.0–2.0 s: she lies on her side propped on one elbow, her sundress spread over the blanket, twirling a daisy and smiling at the lens.
2.0–3.5 s: she picks a strawberry from the bowl and holds it toward the camera.
3.5–5.0 s: she says, playful: "Open up." and brings it close to the lens.
5.0–6.5 s: she pulls it back at the last second, laughs and takes a bite herself.
6.5–8.5 s: she tucks the daisy behind her ear, rests her cheek on her hand and holds eye contact with a slow smile.
8.5–10.0 s: she offers the other half of the strawberry to the camera again, eyes sparkling.
Lighting: dappled warm sunlight through leaves, soft golden glow.
Flirt cues (natural and playful, never explicit): long lingering eye contact with the lens, a slow half-smile, lightly biting her lower lip once, glancing down and then back up through her lashes, leaning in close to the lens as if sharing a secret, at most one playful wink. She is clearly enjoying the viewer's company.

Audio: gentle ukulele and acoustic music with birdsong; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, warm natural colors, crisp focus on her face, gentle handheld motion, one continuous take.
Avoid: changing her face or outfit, cleavage, lingerie, swimwear, see-through fabric, kissing, touching her own body suggestively, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Listen to this part.Референсы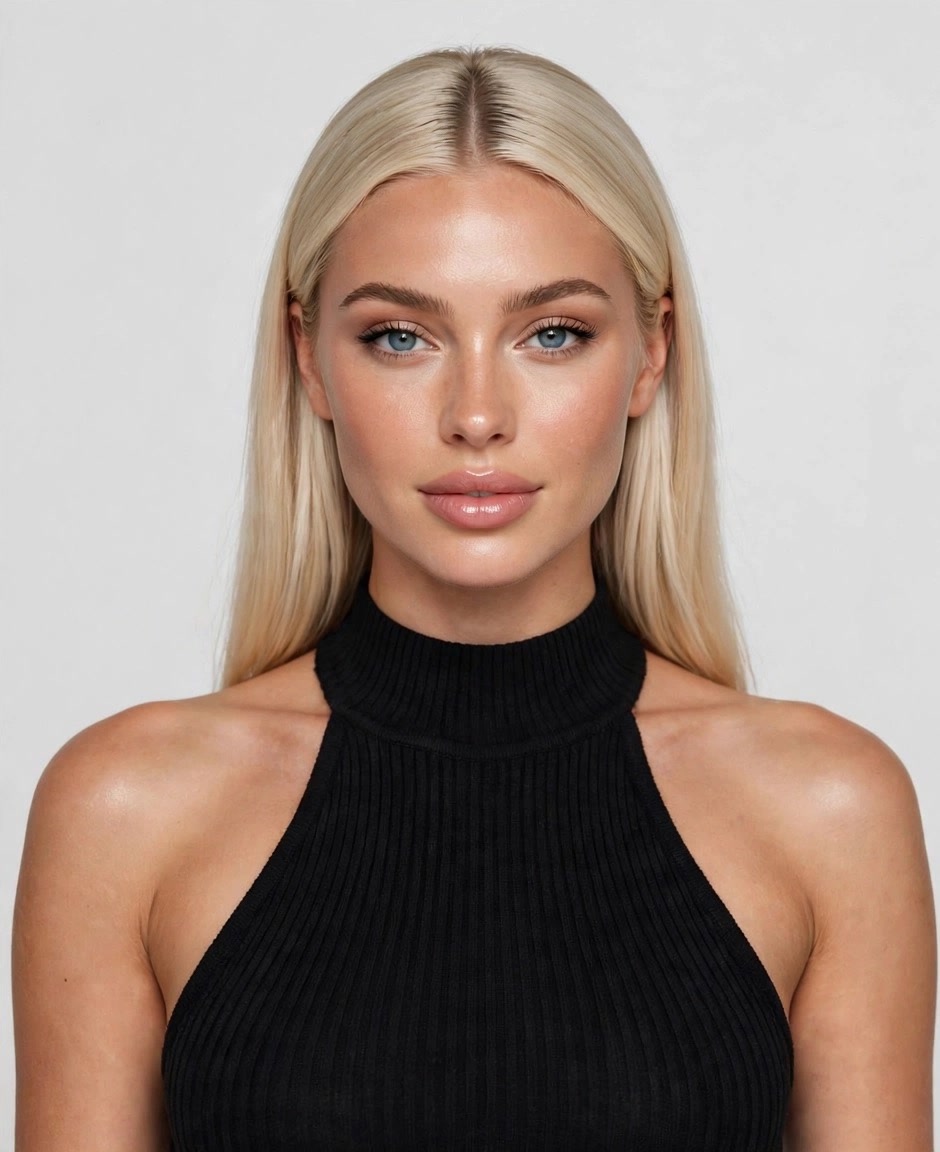
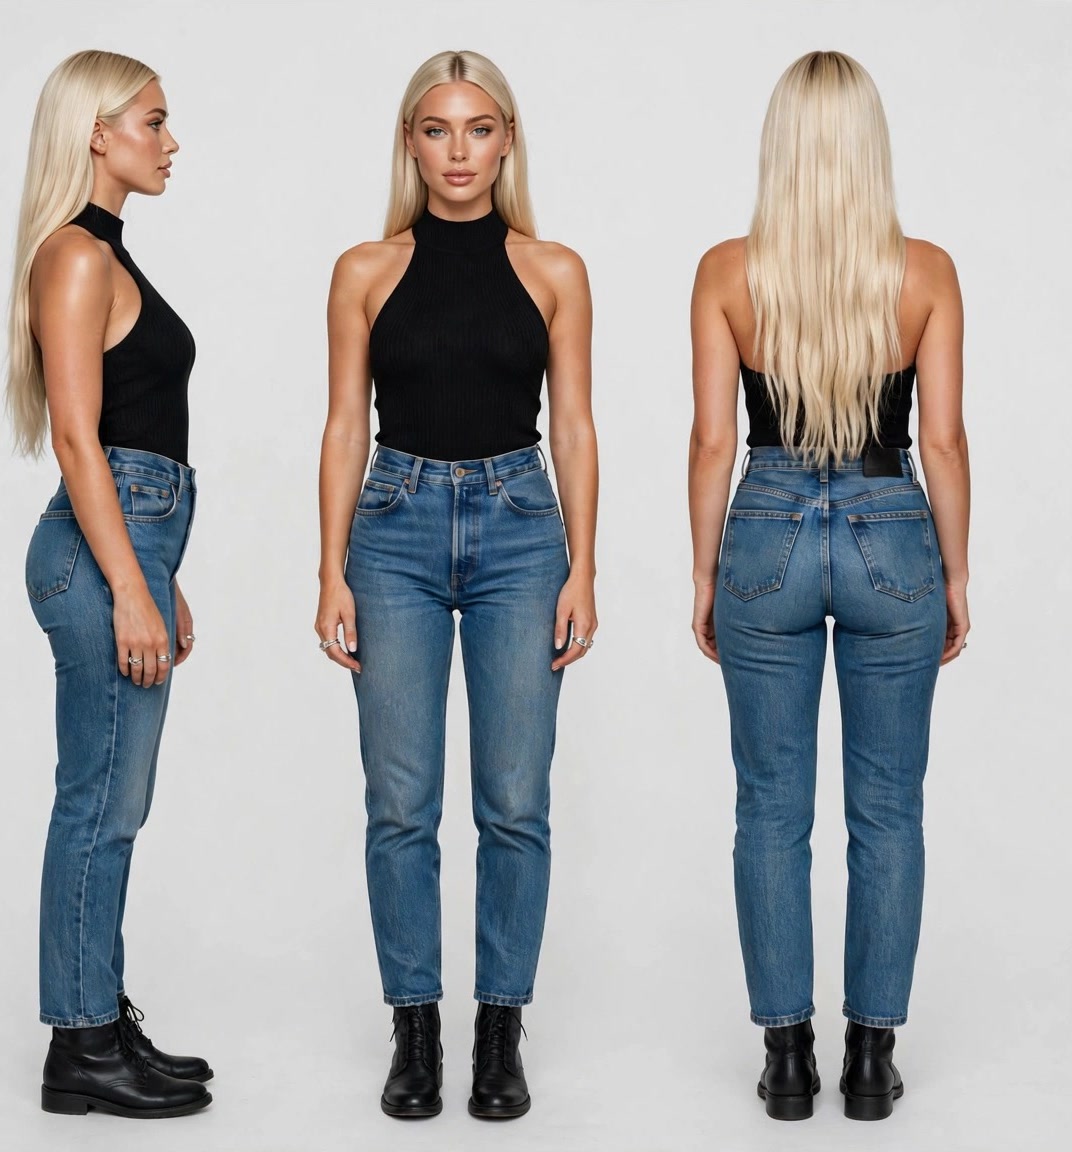
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman in a light summer outfit (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Record store listening booth. Scene: a vintage record store with a small wooden listening booth, shelves and crates of vinyl, a warm amber glow.
Camera: the viewer standing inside the small booth with her, very close.
0.0–1.5 s: she flips through records in a crate, pulls one out and smiles at it.
1.5–3.0 s: she puts on over-ear headphones, closes her eyes and sways slightly to the music.
3.0–4.5 s: she slides one ear cup off and holds it out toward the camera, saying: "Listen to this part."
4.5–6.5 s: she leans in very close to the lens as if sharing the headphones, her eyes looking up into the lens.
6.5–8.5 s: she mouths along to the chorus with a slow smile and lightly bites her lower lip.
8.5–10.0 s: she pulls back a little, laughs and gives the viewer a playful look over her shoulder.
Record sleeves stay plain, with no readable text.
Lighting: warm amber light, soft shadows, cozy vintage tones.
Flirt cues (natural and playful, never explicit): long lingering eye contact with the lens, a slow half-smile, lightly biting her lower lip once, glancing down and then back up through her lashes, leaning in close to the lens as if sharing a secret, at most one playful wink. She is clearly enjoying the viewer's company.

Audio: a warm retro soul song playing in the booth; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, warm natural colors, crisp focus on her face, gentle handheld motion, one continuous take.
Avoid: changing her face or outfit, cleavage, lingerie, swimwear, see-through fabric, kissing, touching her own body suggestively, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.You actually came!Референсы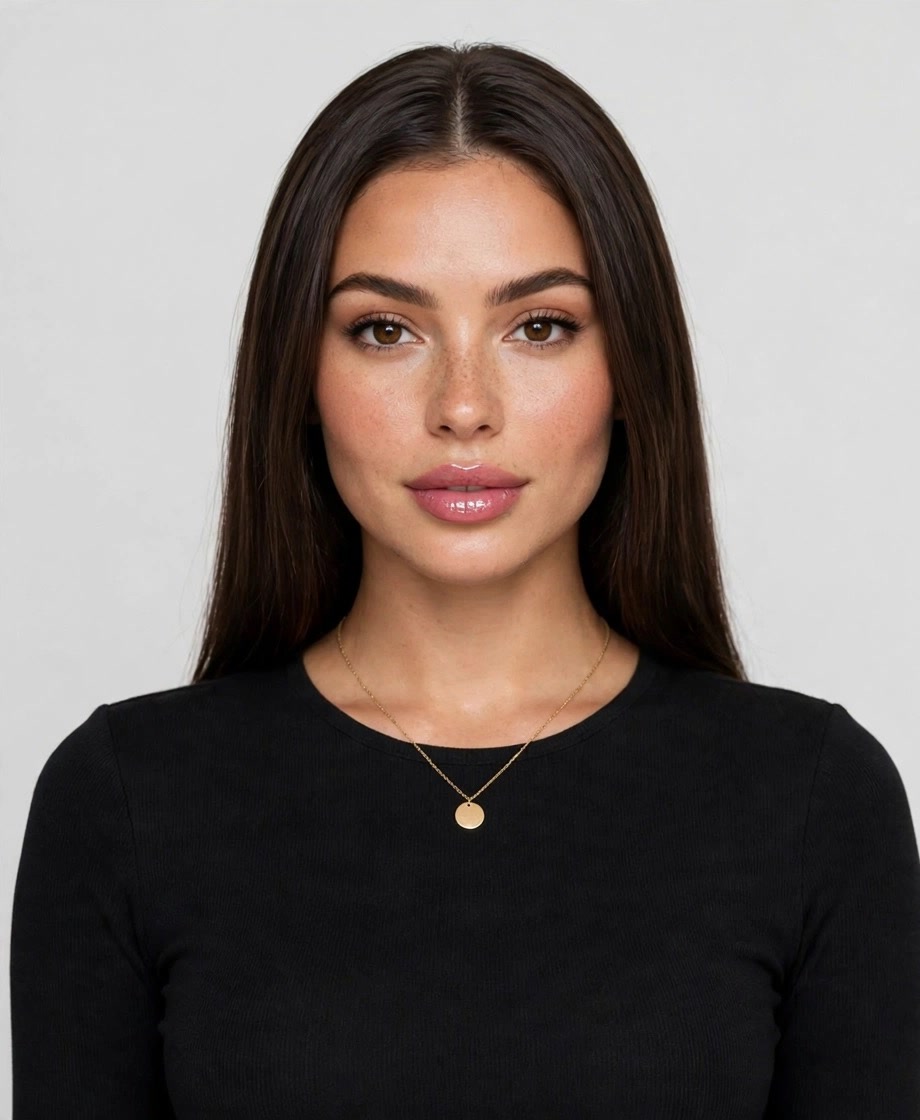
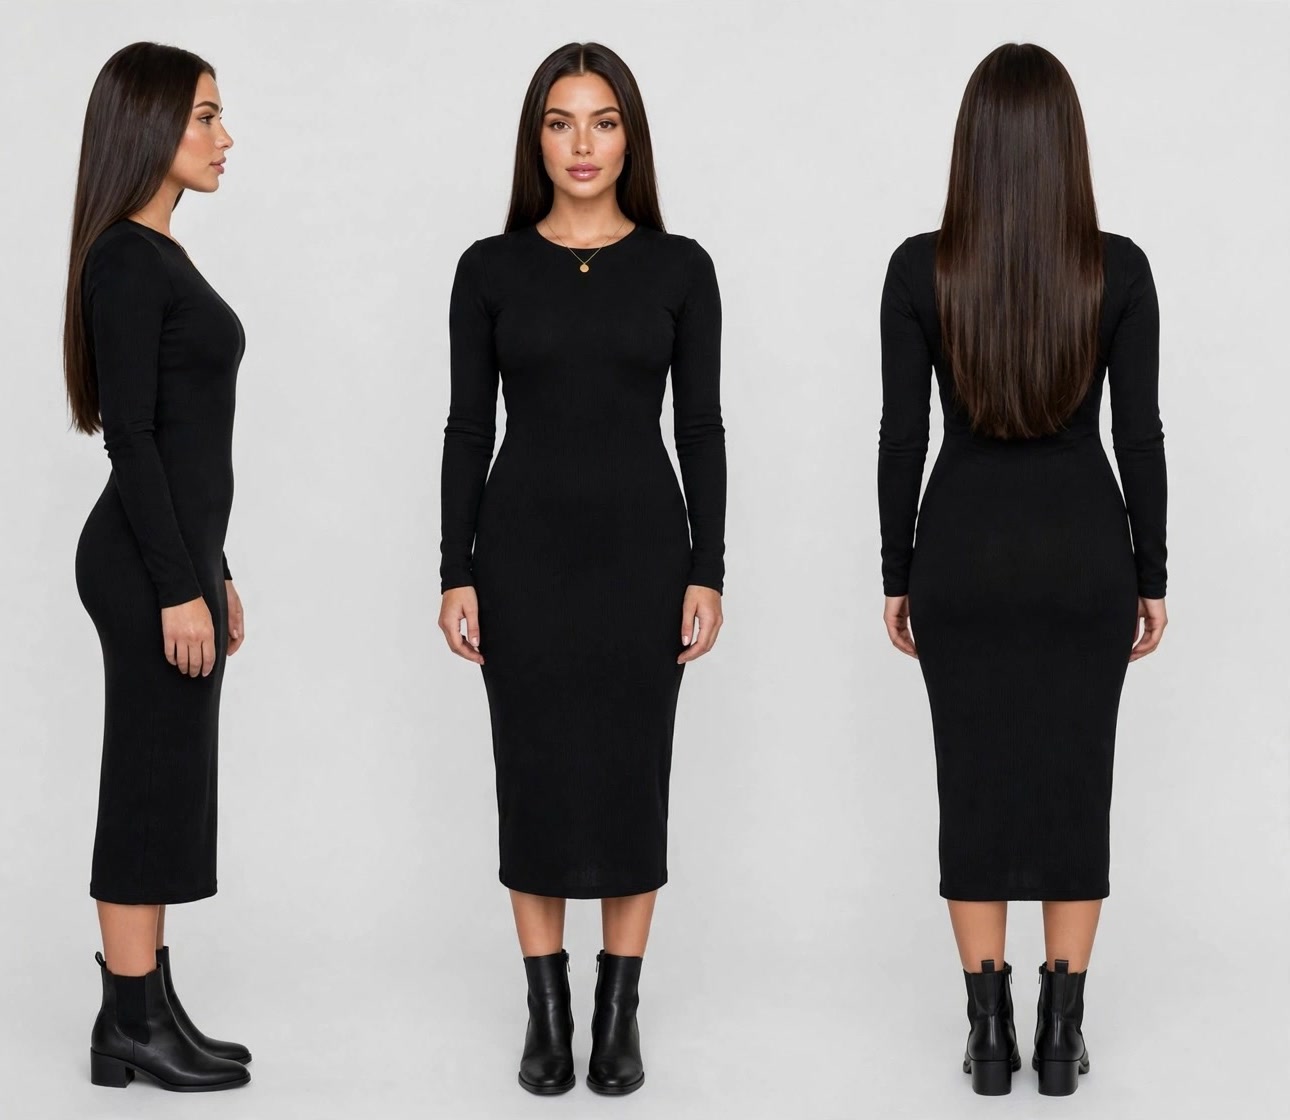
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Rooftop at night. Scene: a rooftop bar above a city at night, warm string lights, the glowing skyline as soft bokeh behind her, a glass railing, small candles on a high table.
Camera: the viewer walking up to her at the railing, one continuous take.
0.0–1.5 s: she leans on the railing half turned away, looking out at the city lights, holding a glass of sparkling water with lime.
1.5–3.0 s: she turns her head toward the lens and her face lights up with a surprised smile.
3.0–5.0 s: she says: "You actually came!" and raises her glass toward the camera as if to clink.
5.0–7.0 s: she sweeps her hair over one shoulder, laughs softly and gives a small playful shrug.
7.0–8.5 s: she makes a small "come here" gesture with two fingers and tilts her head toward the view beside her.
8.5–10.0 s: she turns back toward the skyline but keeps looking at the lens over her shoulder, smiling.
Mood: elegant, playful, warm, confident.
Lighting: warm string lights on her face, cool city bokeh behind, a soft natural night look, no harsh flash.

Audio: chill lo-fi house music and soft city ambience; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, natural colors, crisp focus on her face, gentle handheld motion.
Avoid: changing her face or outfit, revealing or low-cut clothing, see-through fabric, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Okay, your turn to pick the song.Референсы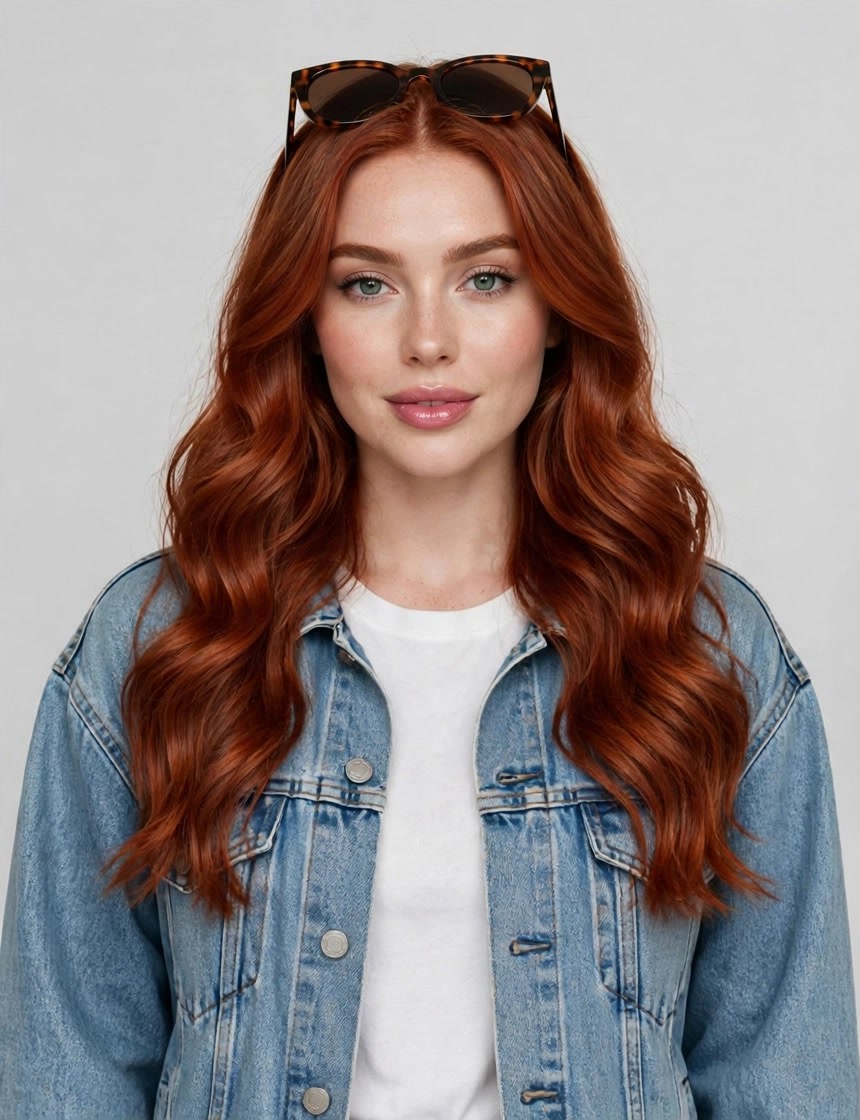
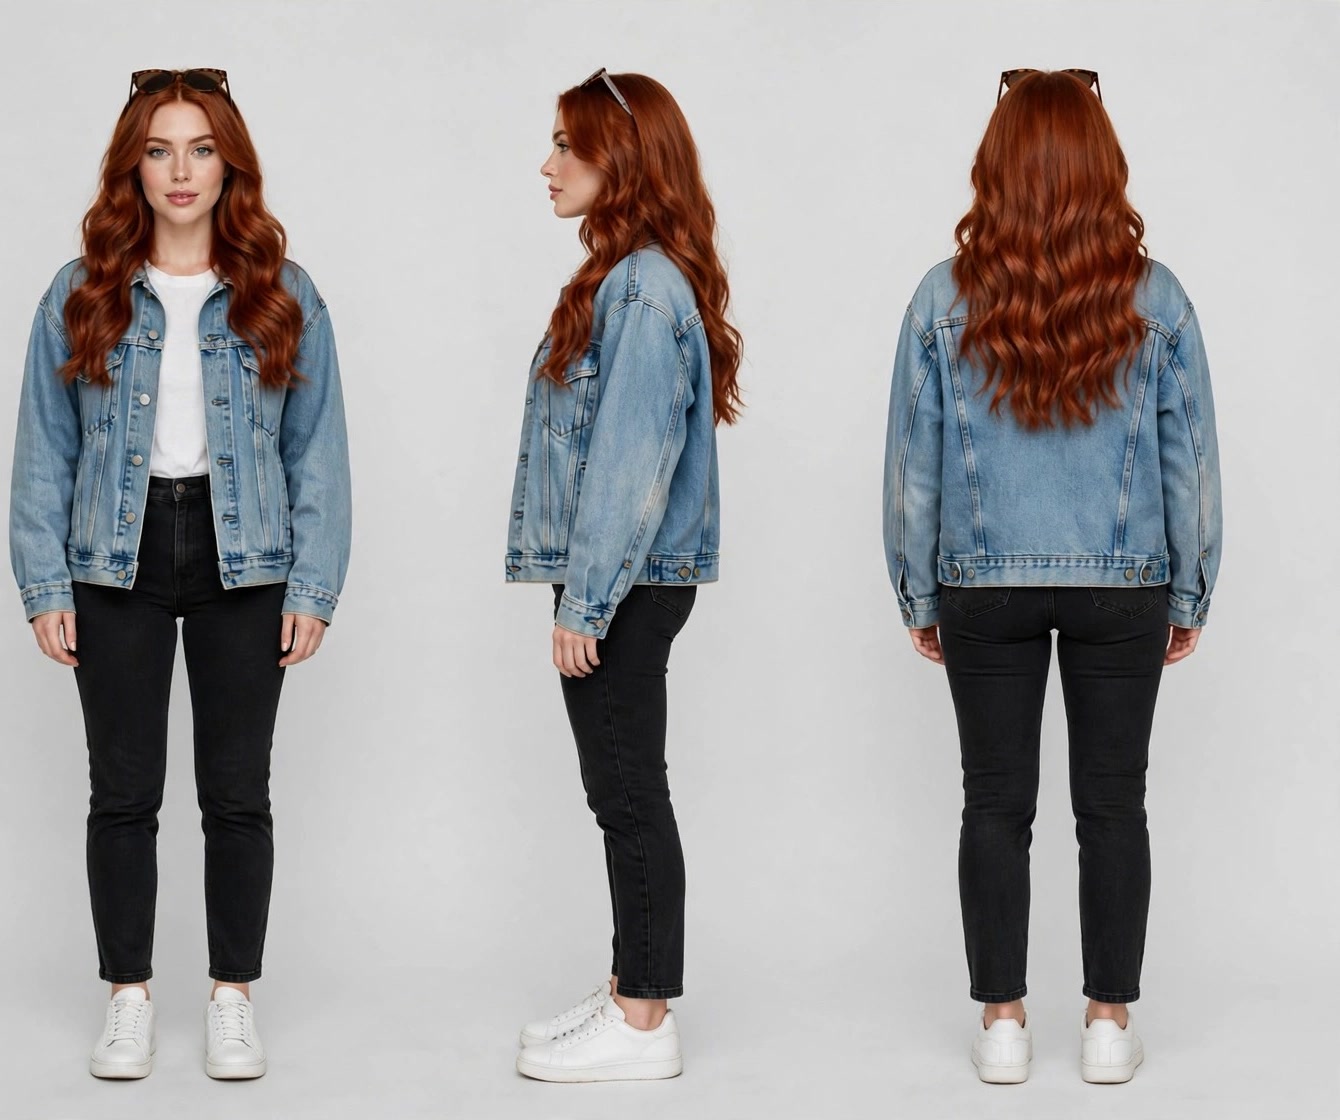
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Road trip stop. Scene: inside a parked car at a sunny beach parking lot, engine off, she sits in the passenger seat, the ocean and palm trees visible through the windshield, sunlight across the dashboard.
Camera: the viewer's point of view from the driver's seat, angled toward her, one continuous take.
0.0–2.0 s: she sings along to the song on the radio with her eyes closed, moving her shoulders to the beat, sunglasses on.
2.0–3.5 s: she pulls her sunglasses down her nose with one finger and looks over them into the lens with a teasing smile.
3.5–5.5 s: she says: "Okay, your turn to pick the song." and hands the phone toward the camera.
5.5–7.5 s: she holds out a paper bag of fries toward the camera, offering one, eyebrows raised.
7.5–9.0 s: she rests her elbow on the open window, the breeze catching her hair, glances at the ocean, then back at the lens.
9.0–10.0 s: she pushes the sunglasses up into her hair and gives the camera a warm, easy smile.
Mood: fun, relaxed, playful, best-road-trip-ever energy.
Lighting: bright natural sunlight, warm tones, soft reflections on the glass.

Audio: upbeat summer pop music from the car speakers; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, natural colors, crisp focus on her face, gentle handheld motion.
Avoid: changing her face or outfit, revealing or low-cut clothing, see-through fabric, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Get under here, you're soaked!Референсы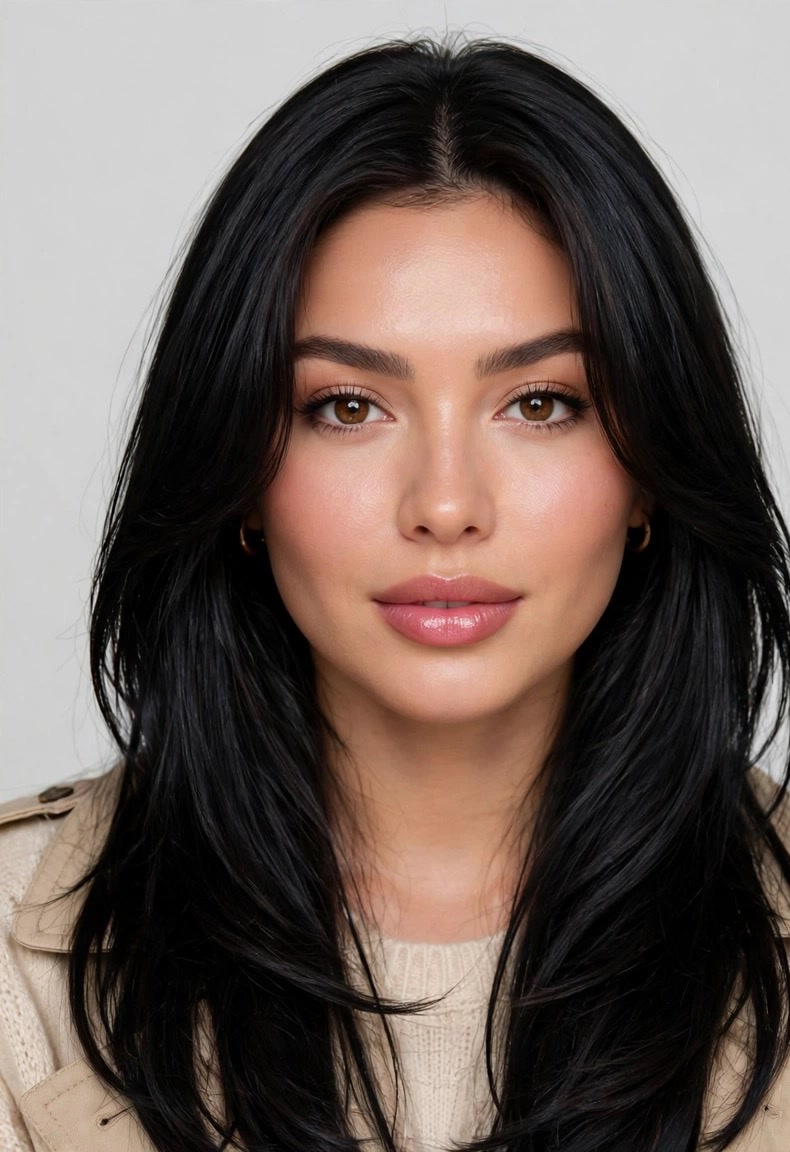
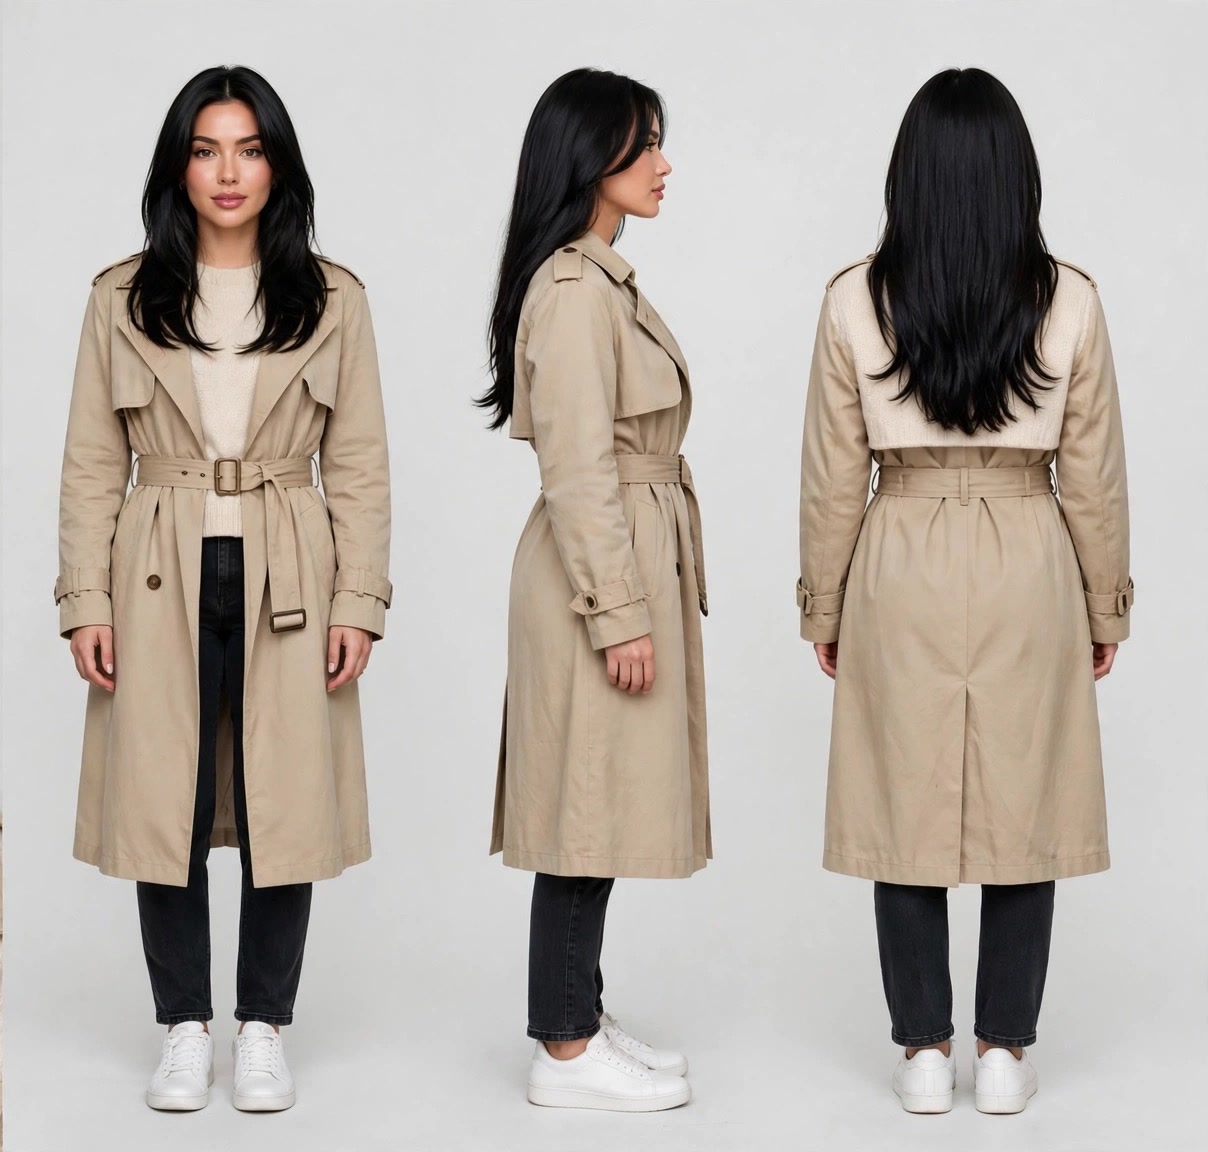
Reference images: image 1 is her headshot (face, features, hair, makeup); image 2 is a front / side / back three-view of the same woman (outfit, accessories, shoes, body). Keep exactly this face, hair and outfit in every frame. She is a 25-year-old woman with a polished Instagram look.

Rainy evening. Scene: a city sidewalk at dusk in light rain, wet pavement reflecting neon shop signs and street lights, people with umbrellas blurred in the background.
Camera: the viewer standing in the rain without an umbrella, one continuous take.
0.0–1.5 s: she walks toward the camera under a clear umbrella, raindrops on the canopy.
1.5–3.0 s: she notices the viewer getting wet, her eyes widen and she laughs.
3.0–5.0 s: she steps close and tilts the umbrella over the camera so the canopy fills the top of the frame, saying: "Get under here, you're soaked!"
5.0–7.0 s: under the umbrella, close to the lens, she shakes the rain off her hand and smiles, her face lit by the neon glow.
7.0–8.5 s: she nods toward the street as if to say "walk with me", eyebrows raised.
8.5–10.0 s: she turns slightly to start walking, still looking back at the lens with a warm smile, the umbrella over both of them.
Mood: romantic, caring, playful, cinematic.
Lighting: neon reflections, soft street lights, cool blue and warm pink tones, sparkling rain.

Audio: soft rain sounds and a gentle R&B instrumental; her line is clear, natural American English; no other voices, no laugh track.
Style: realistic Instagram Reel shot on an iPhone, vertical 9:16, natural colors, crisp focus on her face, gentle handheld motion.
Avoid: changing her face or outfit, revealing or low-cut clothing, see-through fabric, extra fingers, warped hands, strangers staring at the camera, on-screen text, subtitles, watermark.Look, isn't this spatula so handy?Референсы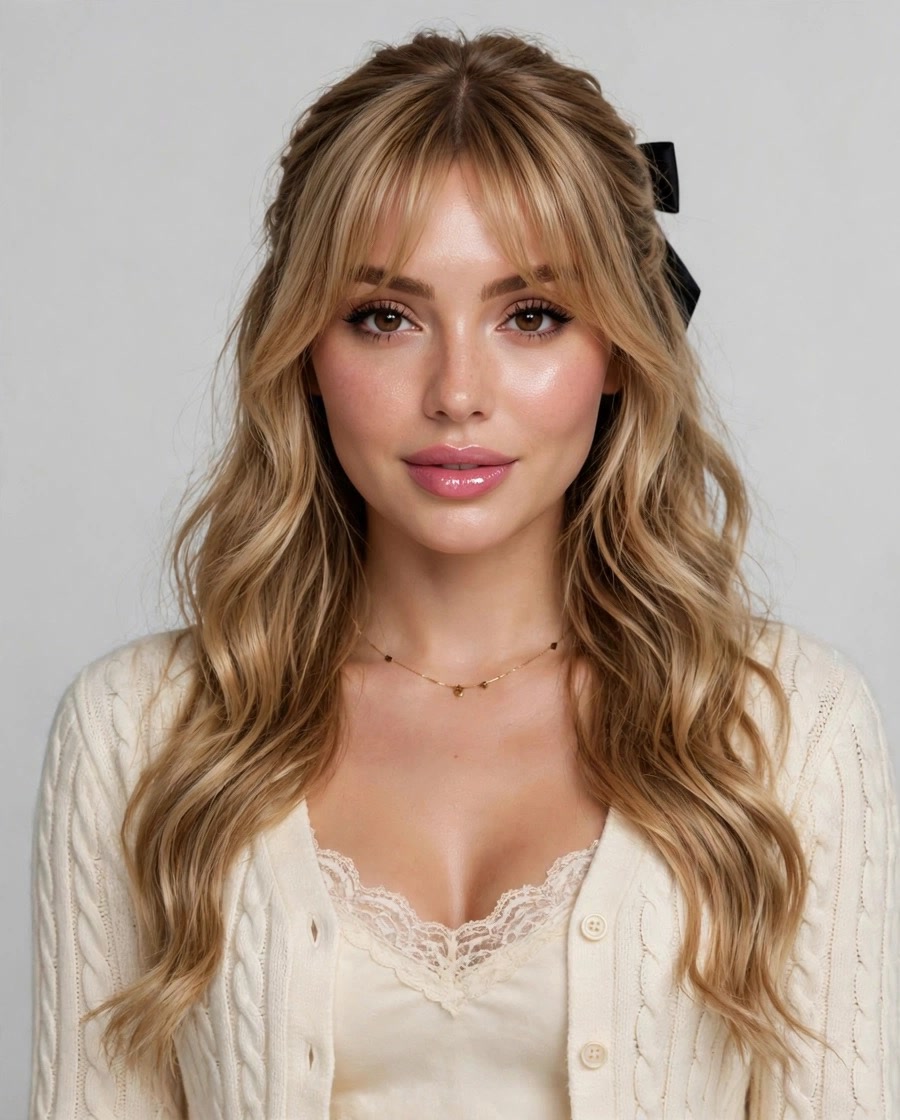
 Промпт адаптирован из поста @beizhi606
参考图说明:参考图1是人物大头照(脸、五官、发型、发色、妆容都以它为准),参考图2是同一个人的三视图(服装、配饰、鞋子、身材都以它为准)。人物是 25 岁的欧美女性,Instagram 博主风格的精致妆容。下文里「原视频里」的发型、发色和穿搭描述一律忽略,以参考图为准。

中文提示词(10.00秒)
人物:
脸部: 人物的长相、五官、发型、发色和妆容严格按照。
服装和身材: 人物的服装穿搭、配饰和身材比例严格按照。镜头2里人物背对镜头,背面的服装请参考三视图的背面。
一致性: 4个镜头里都是同一个人,脸和服装全程保持一致,切镜后不能变样;镜头2镜子里的倒影也必须是同一个人、同一套服装。

道具:
镜头1:一把黑色的厨房食物夹。
镜头4:一把黑色的锅铲。

场景:
场景是一个居家厨房,以及厨房门口连着的客厅。

厨房: 墙面贴着白色大理石纹理的瓷砖,灶台是黑色的,上面放着一口黑色的炒锅,台面上摆着各种调料瓶、刀架和杂物。厨房门是白色的,墙顶挂着几个红色的小灯笼。
客厅: 浅木色的地板,门背后挂着一面全身镜,地上有一只黑猫。

光线:
室内自然日光,光线柔和均匀,色调是偏冷的白灰色,干净通透。

分镜
镜头1|0.00–3.27秒|广角近景,拿着食物夹对镜头互动

机位: 手机离人物很近,略微俯拍,用广角镜头,画面是人物的脸和上半身,背景是厨房的瓷砖墙、白色的门和灶台上的黑色炒锅。
0.00–0.60秒: 人物低着头,眼睛往下看,带着一点浅笑;画面左侧的那只手拿着黑色食物夹,放在画面左下角。
0.60–1.00秒: 人物抬起头看向镜头,镜头稍微往前凑近一点。
1.00–1.60秒: 人物看着镜头,嘴角轻轻扬起,食物夹移到画面左侧边缘。
1.60–2.00秒: 人物把食物夹朝镜头伸过来,夹头出现在画面左侧前景里,有虚焦。
2.00–2.60秒: 人物用食物夹在镜头前一开一合地"夹"了几下,眼睛微微眯起,露出俏皮的笑。
2.60–3.27秒: 食物夹收回到画面左侧,人物看着镜头微笑。在3.27秒硬切。

镜头2|3.27–4.70秒|全身镜前,背对镜头再回头

机位: 镜头在人物身后偏右的位置,平视,画面是中景。画面左半部分是全身镜里人物的正面倒影,右半部分是人物本人的背面。客厅的木地板上能看到一只黑猫。
3.27–4.00秒: 人物背对镜头,面朝全身镜站着,一只手叉腰,另一只手轻轻扶着镜子的边缘;镜子里的倒影看着她自己。
4.00–4.20秒: 人物的头从肩膀上方转过来,回头看向镜头。
4.20–4.70秒: 人物回头直视镜头,表情平静;镜子里的倒影转成侧脸。在4.70秒硬切。

镜头3|4.70–5.50秒|高角度俯拍,在灶台边站着

机位: 镜头放在厨房的高处角落,从上往下俯拍人物的全身,用广角镜头,画面里能看到黑色灶台、炒锅、调料瓶和白色的门。
4.70–5.50秒: 人物站在灶台旁边,双手背在身后,抬头看着镜头微笑,身体轻轻晃一下。在5.50秒硬切。

镜头4|5.50–10.00秒|拿着锅铲,近景表情变化

机位: 手机离人物比较近,略微俯拍,用广角镜头,画面是人物的胸口以上。背景里有白色的门、门把手、大理石瓷砖墙、黑色炒锅,墙顶挂着红色小灯笼。
5.50–5.90秒: 人物画面左侧的那只手拿着黑色锅铲,举到肩膀的高度,锅铲头朝上。她看着镜头,开口用英文说出台词「Look, isn't this spatula so handy?」,带着笑。
5.90–6.30秒: 人物的眼睛看向画面一侧,嘴唇嘟起来。
6.30–6.90秒: 人物低头,眼睛往下看,嘴唇抿着。
6.90–7.30秒: 人物抬眼看向镜头,眉头微微皱起,嘴巴轻轻嘟着。
7.30–8.40秒(补充): 人物保持皱眉嘟嘴看着镜头,拿着锅铲的手在空中朝镜头轻轻点两下。
8.40–9.30秒(补充): 人物的眉头慢慢松开,嘴角忍不住往上扬。
9.30–10.00秒(补充): 人物看着镜头露出笑容,锅铲还举在肩膀旁边,定格收尾。从低头到抬头、举锅铲的动作要连贯流畅地过渡,不得跳帧或姿势瞬移。

风格:
风格是抖音/小红书的居家vlog短视频,手机广角原相机的质感,加了美颜和磨皮,肤色白皙通透。自然日光,冷白色调,写实,高清,表情生动自然。

音频:
全程是好听的轻快配乐(尤克里里、手风琴风格的明亮纯音乐),3.27秒、4.70秒、5.50秒的三次切镜都卡在节拍上。镜头4里人物开口用英文说出台词「Look, isn't this spatula so handy?」,人声是自然的美式英语,清晰自然,配乐压低、不盖过人声。除这句台词外,全程不得出现任何其他人声、怪叫、笑声或其他奇怪的声音。

参数:
16:9横屏,10.00秒,30fps,写实,4个镜头。

负面提示词: 换脸、服装变化、切镜后人物变样、镜子倒影和本人不一致、倒影变成别人、五官变形、手指畸形、食物夹或锅铲变形、多余手臂、广角导致的严重畸变、画面闪烁、低清、水印、字幕、跳帧、动作瞬移、姿势突变、奇怪的人声、怪叫、无故笑声Look, isn't this spatula so handy?Референсы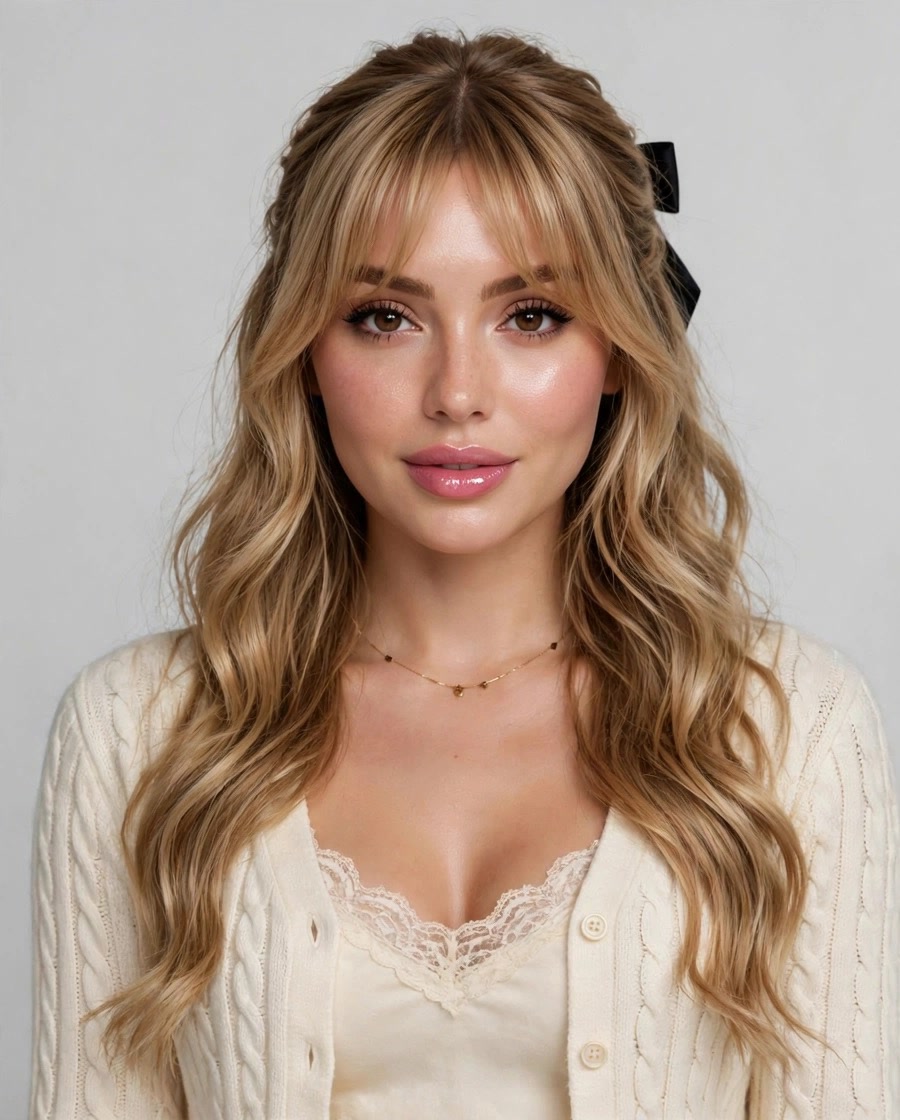
 Промпт адаптирован из поста @beizhi606
参考图说明:参考图1是人物大头照(脸、五官、发型、发色、妆容都以它为准),参考图2是同一个人的三视图(服装、配饰、鞋子、身材都以它为准)。人物是 25 岁的欧美女性,Instagram 博主风格的精致妆容。下文里「原视频里」的发型、发色和穿搭描述一律忽略,以参考图为准。

中文提示词(10.00秒)
人物:
脸部: 人物的长相、五官、发型、发色和妆容严格按照。
服装和身材: 人物的服装穿搭、配饰和身材比例严格按照。镜头2里人物背对镜头,背面的服装请参考三视图的背面。
一致性: 4个镜头里都是同一个人,脸和服装全程保持一致,切镜后不能变样;镜头2镜子里的倒影也必须是同一个人、同一套服装。

道具:
镜头1:一把黑色的厨房食物夹。
镜头4:一把黑色的锅铲。

场景:
场景是一个居家厨房,以及厨房门口连着的客厅。

厨房: 墙面贴着白色大理石纹理的瓷砖,灶台是黑色的,上面放着一口黑色的炒锅,台面上摆着各种调料瓶、刀架和杂物。厨房门是白色的,墙顶挂着几个红色的小灯笼。
客厅: 浅木色的地板,门背后挂着一面全身镜,地上有一只黑猫。

光线:
室内自然日光,光线柔和均匀,色调是偏冷的白灰色,干净通透。

分镜
镜头1|0.00–3.27秒|广角近景,拿着食物夹对镜头互动

机位: 手机离人物很近,略微俯拍,用广角镜头,画面是人物的脸和上半身,背景是厨房的瓷砖墙、白色的门和灶台上的黑色炒锅。
0.00–0.60秒: 人物低着头,眼睛往下看,带着一点浅笑;画面左侧的那只手拿着黑色食物夹,放在画面左下角。
0.60–1.00秒: 人物抬起头看向镜头,镜头稍微往前凑近一点。
1.00–1.60秒: 人物看着镜头,嘴角轻轻扬起,食物夹移到画面左侧边缘。
1.60–2.00秒: 人物把食物夹朝镜头伸过来,夹头出现在画面左侧前景里,有虚焦。
2.00–2.60秒: 人物用食物夹在镜头前一开一合地"夹"了几下,眼睛微微眯起,露出俏皮的笑。
2.60–3.27秒: 食物夹收回到画面左侧,人物看着镜头微笑。在3.27秒硬切。

镜头2|3.27–4.70秒|全身镜前,背对镜头再回头

机位: 镜头在人物身后偏右的位置,平视,画面是中景。画面左半部分是全身镜里人物的正面倒影,右半部分是人物本人的背面。客厅的木地板上能看到一只黑猫。
3.27–4.00秒: 人物背对镜头,面朝全身镜站着,一只手叉腰,另一只手轻轻扶着镜子的边缘;镜子里的倒影看着她自己。
4.00–4.20秒: 人物的头从肩膀上方转过来,回头看向镜头。
4.20–4.70秒: 人物回头直视镜头,表情平静;镜子里的倒影转成侧脸。在4.70秒硬切。

镜头3|4.70–5.50秒|高角度俯拍,在灶台边站着

机位: 镜头放在厨房的高处角落,从上往下俯拍人物的全身,用广角镜头,画面里能看到黑色灶台、炒锅、调料瓶和白色的门。
4.70–5.50秒: 人物站在灶台旁边,双手背在身后,抬头看着镜头微笑,身体轻轻晃一下。在5.50秒硬切。

镜头4|5.50–10.00秒|拿着锅铲,近景表情变化

机位: 手机离人物比较近,略微俯拍,用广角镜头,画面是人物的胸口以上。背景里有白色的门、门把手、大理石瓷砖墙、黑色炒锅,墙顶挂着红色小灯笼。
5.50–5.90秒: 人物画面左侧的那只手拿着黑色锅铲,举到肩膀的高度,锅铲头朝上。她看着镜头,开口用英文说出台词「Look, isn't this spatula so handy?」,带着笑。
5.90–6.30秒: 人物的眼睛看向画面一侧,嘴唇嘟起来。
6.30–6.90秒: 人物低头,眼睛往下看,嘴唇抿着。
6.90–7.30秒: 人物抬眼看向镜头,眉头微微皱起,嘴巴轻轻嘟着。
7.30–8.40秒(补充): 人物保持皱眉嘟嘴看着镜头,拿着锅铲的手在空中朝镜头轻轻点两下。
8.40–9.30秒(补充): 人物的眉头慢慢松开,嘴角忍不住往上扬。
9.30–10.00秒(补充): 人物看着镜头露出笑容,锅铲还举在肩膀旁边,定格收尾。从低头到抬头、举锅铲的动作要连贯流畅地过渡,不得跳帧或姿势瞬移。

风格:
风格是抖音/小红书的居家vlog短视频,手机广角原相机的质感,加了美颜和磨皮,肤色白皙通透。自然日光,冷白色调,写实,高清,表情生动自然。

音频:
全程是好听的轻快配乐(尤克里里、手风琴风格的明亮纯音乐),3.27秒、4.70秒、5.50秒的三次切镜都卡在节拍上。镜头4里人物开口用英文说出台词「Look, isn't this spatula so handy?」,人声是自然的美式英语,清晰自然,配乐压低、不盖过人声。除这句台词外,全程不得出现任何其他人声、怪叫、笑声或其他奇怪的声音。

参数:
16:9横屏,10.00秒,30fps,写实,4个镜头。

负面提示词: 换脸、服装变化、切镜后人物变样、镜子倒影和本人不一致、倒影变成别人、五官变形、手指畸形、食物夹或锅铲变形、多余手臂、广角导致的严重畸变、画面闪烁、低清、水印、字幕、跳帧、动作瞬移、姿势突变、奇怪的人声、怪叫、无故笑声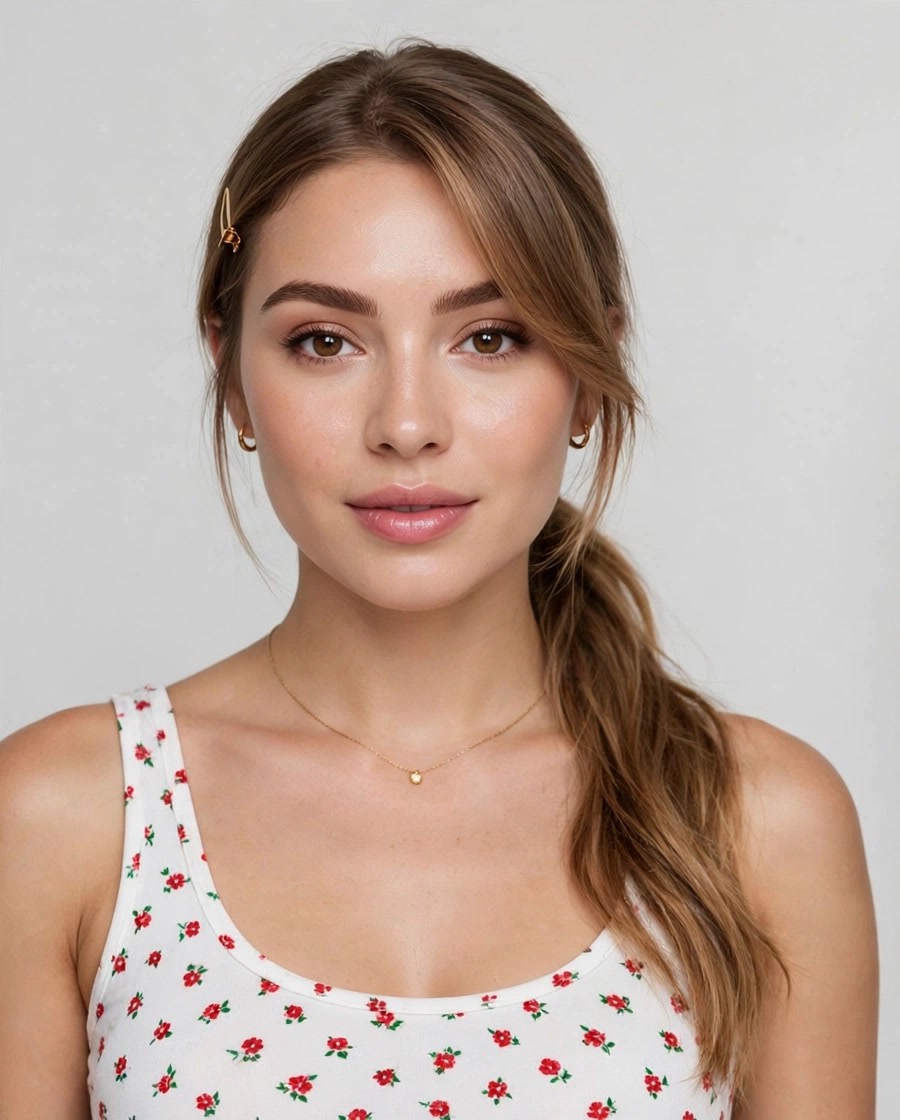
 Промпт адаптирован из поста @beizhi606
参考图说明:参考图1是人物大头照(脸、五官、发型、发色、妆容都以它为准),参考图2是同一个人的三视图(服装、配饰、鞋子、身材都以它为准)。人物是 25 岁的欧美女性,Instagram 博主风格的精致妆容。下文里「原视频里」的发型、发色和穿搭描述一律忽略,以参考图为准。

中文提示词(10.00秒)
·脸部:完全按【参考图1 大头照】,五官、脸型、发型、发色都以大头照为准,全程保持同一张脸。原视频里是黑色长发,低马尾搭在右肩前面,有侧分刘海,左侧别一个小发夹。
·服装和身材:完全按【参考图2 三视图】,包括服装款式、颜色、配饰和身材比例。以下是原视频的穿搭,只在没有参考时备用:
·白色背心,上面有红色小碎花印花:
·浅蓝色牛仔短裤:
·右手腕戴红色串珠手链,脖子上有金色细项链。
·一致性:全程人物的脸和服装都不能变。
场景

• 老式居民楼的楼道和阳台,人物站在楼上一层的水泥栏杆后面,栏杆是一根根竖着的方形水泥柱,表面斑驳。
• 背景是灰色水泥墙,墙上有几根电线横着穿过。
• 机位在楼下一层,画面最下方前景是一根黄色金属扶手。
• 中段镜头拉开一点时,能稍微看到上方一层水泥栏杆阳台的下沿和电线即可,不要拉成远景。

光线:阴天的自然光,光线柔和均匀,偏灰调,低饱和,写实。

机位(本版重点):手持拍摄,从楼下往上仰拍,竖屏。前半段是近距离中近景,人物上半身占画面主体;约 4.6 秒开始只轻轻往后拉一次,拉到中景(人物腰部以上、头部约占画面高度三分之一)就立刻停住,之后一直保持这个距离固定拍到结尾,不再继续拉远、不往下拉成远景,人物不能变小。全程只有轻微手持晃动。

分镜
• 0.00–0.40:镜头从下往上快速甩,画面先是模糊的黄色扶手和水泥栏杆,有动态模糊,随即稳定成近距离中近景。
• 0.40–0.60:人物站在栏杆后面,上半身往前探出栏杆,左手扶着栏杆顶部,右手从栏杆之间向下伸出,掌心朝下,手指张开,伸向镜头。
• 0.60–1.60:保持向下伸手的姿势,头往右歪,微笑着看向镜头,马尾垂在右肩前。
• 1.60–2.80:头慢慢回正,继续微笑看镜头,右手还向下伸着,手指轻轻动了一下。
• 2.80–3.60:头又往左歪,眼睛半眯,嘴角上扬,身体随着节奏轻轻晃动。
• 3.60–4.60:头回到正面,看着镜头,右手保持向下伸出,镜头不动。
• 4.60–6.50:镜头只轻轻往后拉一次,拉到中景就停:人物稍微变小一点,上方一层阳台下沿和电线稍微进画,黄色扶手仍在画面下方;人物保持伸手姿势看着镜头。
• 6.50–7.50:镜头停住不动,保持这个中景距离,人物保持向下伸手、微笑看镜头。
• 7.50–8.80:镜头仍固定在这个距离。人物慢慢把右手收回到栏杆上,双手扶着栏杆,头微微歪着。
• 8.80–10.00:人物保持双手扶栏杆、身体往前探的姿势,头抬着、微笑看着镜头直到结束,不要把头伏到手臂或栏杆上;镜头保持距离不再拉动。

风格:写实真人质感,手机竖屏随手拍的感觉,阴天的灰调,低饱和,有轻微手持晃动。

字幕:不要在生成时让模型写任何字幕文字(字幕后期再加)。

音频:保留背景音乐,镜头拉开的时候对准音乐节拍。

参数:10.00 秒,9:16 竖屏,720×1280,30fps。

负面提示词:一直拉远、持续变焦拉远、远景、人物变得很小、换脸、五官变形、脸显老、发型改变、服装颜色或款式变化、手链消失或戴错手、多出手指、手部畸形、伸出的手臂过长、肢体扭曲、栏杆穿过身体、建筑结构错乱、画面闪烁、乱码文字、水印。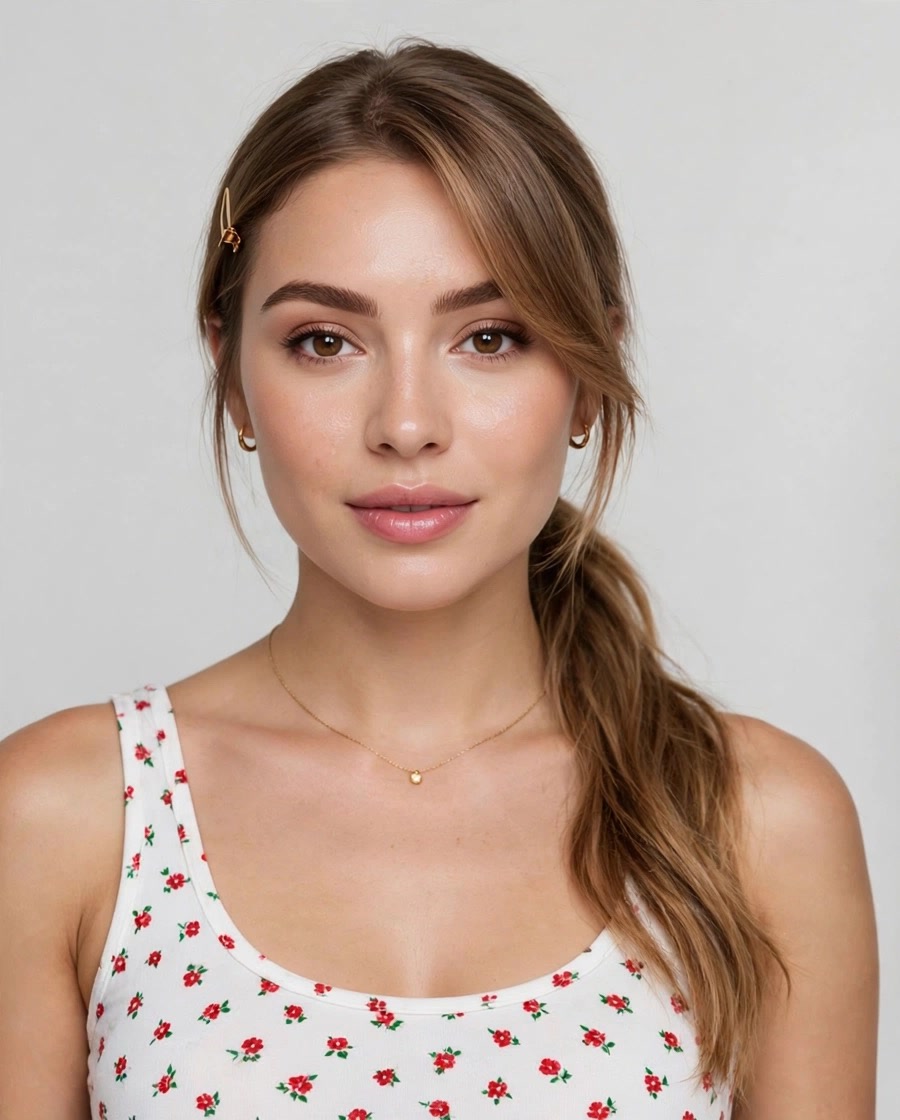
 Промпт адаптирован из поста @beizhi606
参考图说明:参考图1是人物大头照(脸、五官、发型、发色、妆容都以它为准),参考图2是同一个人的三视图(服装、配饰、鞋子、身材都以它为准)。人物是 25 岁的欧美女性,Instagram 博主风格的精致妆容。下文里「原视频里」的发型、发色和穿搭描述一律忽略,以参考图为准。

中文提示词(10.00秒)
·脸部:完全按【参考图1 大头照】,五官、脸型、发型、发色都以大头照为准,全程保持同一张脸。原视频里是黑色长发,低马尾搭在右肩前面,有侧分刘海,左侧别一个小发夹。
·服装和身材:完全按【参考图2 三视图】,包括服装款式、颜色、配饰和身材比例。以下是原视频的穿搭,只在没有参考时备用:
·白色背心,上面有红色小碎花印花:
·浅蓝色牛仔短裤:
·右手腕戴红色串珠手链,脖子上有金色细项链。
·一致性:全程人物的脸和服装都不能变。
场景

• 老式居民楼的楼道和阳台,人物站在楼上一层的水泥栏杆后面,栏杆是一根根竖着的方形水泥柱,表面斑驳。
• 背景是灰色水泥墙,墙上有几根电线横着穿过。
• 机位在楼下一层,画面最下方前景是一根黄色金属扶手。
• 中段镜头拉开一点时,能稍微看到上方一层水泥栏杆阳台的下沿和电线即可,不要拉成远景。

光线:阴天的自然光,光线柔和均匀,偏灰调,低饱和,写实。

机位(本版重点):手持拍摄,从楼下往上仰拍,竖屏。前半段是近距离中近景,人物上半身占画面主体;约 4.6 秒开始只轻轻往后拉一次,拉到中景(人物腰部以上、头部约占画面高度三分之一)就立刻停住,之后一直保持这个距离固定拍到结尾,不再继续拉远、不往下拉成远景,人物不能变小。全程只有轻微手持晃动。

分镜
• 0.00–0.40:镜头从下往上快速甩,画面先是模糊的黄色扶手和水泥栏杆,有动态模糊,随即稳定成近距离中近景。
• 0.40–0.60:人物站在栏杆后面,上半身往前探出栏杆,左手扶着栏杆顶部,右手从栏杆之间向下伸出,掌心朝下,手指张开,伸向镜头。
• 0.60–1.60:保持向下伸手的姿势,头往右歪,微笑着看向镜头,马尾垂在右肩前。
• 1.60–2.80:头慢慢回正,继续微笑看镜头,右手还向下伸着,手指轻轻动了一下。
• 2.80–3.60:头又往左歪,眼睛半眯,嘴角上扬,身体随着节奏轻轻晃动。
• 3.60–4.60:头回到正面,看着镜头,右手保持向下伸出,镜头不动。
• 4.60–6.50:镜头只轻轻往后拉一次,拉到中景就停:人物稍微变小一点,上方一层阳台下沿和电线稍微进画,黄色扶手仍在画面下方;人物保持伸手姿势看着镜头。
• 6.50–7.50:镜头停住不动,保持这个中景距离,人物保持向下伸手、微笑看镜头。
• 7.50–8.80:镜头仍固定在这个距离。人物慢慢把右手收回到栏杆上,双手扶着栏杆,头微微歪着。
• 8.80–10.00:人物保持双手扶栏杆、身体往前探的姿势,头抬着、微笑看着镜头直到结束,不要把头伏到手臂或栏杆上;镜头保持距离不再拉动。

风格:写实真人质感,手机竖屏随手拍的感觉,阴天的灰调,低饱和,有轻微手持晃动。

字幕:不要在生成时让模型写任何字幕文字(字幕后期再加)。

音频:保留背景音乐,镜头拉开的时候对准音乐节拍。

参数:10.00 秒,9:16 竖屏,720×1280,30fps。

负面提示词:一直拉远、持续变焦拉远、远景、人物变得很小、换脸、五官变形、脸显老、发型改变、服装颜色或款式变化、手链消失或戴错手、多出手指、手部畸形、伸出的手臂过长、肢体扭曲、栏杆穿过身体、建筑结构错乱、画面闪烁、乱码文字、水印。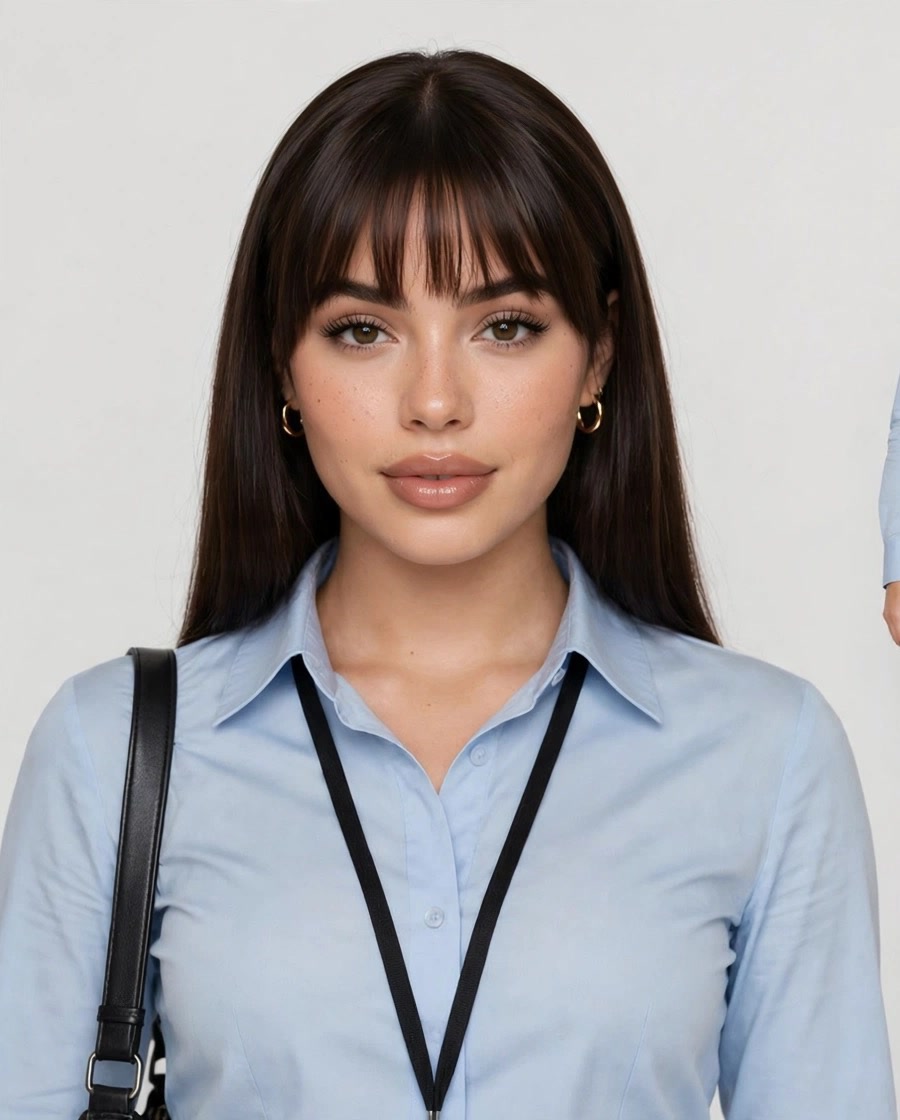
 Промпт адаптирован из поста @beizhi606
参考图说明:参考图1是人物大头照(脸、五官、发型、发色、妆容都以它为准),参考图2是同一个人的三视图(服装、配饰、鞋子、身材都以它为准)。人物是 25 岁的欧美女性,Instagram 博主风格的精致妆容。下文里「原视频里」的发型、发色和穿搭描述一律忽略,以参考图为准。

中文提示词(10.00秒)
人物

• 脸部:完全按【参考图1 大头照】,五官、脸型、发型、发色都以大头照为准,每个镜头保持同一张脸。原视频里是黑棕色齐腰长直发、齐刘海。
• 服装和身材:完全按【参考图2 三视图】,包括服装款式、颜色、配饰、鞋子和身材比例。原视频里的穿搭只作为没有参考时的备用:
• 浅蓝色长袖衬衫,扎进裙子里;
• 灰色包臀短裙;
• 黑色薄丝袜,黑色尖头细高跟鞋;
• 胸前挂黑色挂绳工牌;
• 黑色单肩包。

• 一致性:5 个镜头里人物的脸和服装不能变。

场景

• 地铁车厢里,白色车厢内壁,金属扶手竖杆。
• 车门边有黄黑警示条,门上有出口和安全标识。
• 车厢里有其他乘客:有的低头看手机,有的坐着,有的站着,有的放着红色行李箱和紫色袋子。乘客都是自然状态,不看镜头。

光线:地铁车厢顶部的白色日光灯,照明均匀明亮,偏冷白色调,写实。

机位:都是手机手持拍摄,平视或略低机位,竖屏。

分镜
镜头1|0.00–1.97秒|靠在车门边站着,旁边是看手机的乘客

• 机位:平视中全景,竖屏能拍到全身。画面左侧前景是一位穿蓝色T恤、低头看手机的男乘客,人物在画面中间偏右,背靠车门。
• 0.00–0.40:人物背靠车门,一条腿弯曲,脚掌向后抵在车门上。右手抬到颈侧摸着头发,看向镜头。
• 0.40–0.80:抬起的脚放回地面,变成双脚并拢站立,右手放下到胸前。
• 0.80–1.40:双手自然垂放,身体靠着车门,头微微低下。
• 1.40–1.97:右手抬到耳边,把头发往耳后拨,眼睛向下看。

镜头2|1.97–3.37秒|坐在座位上跷腿,侧脸看向左边

• 机位:略高的侧前方机位,中全景。人物在画面右侧,坐在地铁座椅上,左侧有一位戴眼镜、穿深色衣服的男乘客,低头看手机,旁边还站着一位乘客。
• 1.97–2.60:硬切进来。人物跷着二郎腿,黑色单肩包放在大腿上,双手放在包上,头转向画面左侧,侧脸朝镜头。
• 2.60–3.37:姿势不变,眼睛看着左前方,头发自然垂在背后,身体基本保持不动。

镜头3|3.37–5.33秒|手扶竖杆站着,拨头发

• 机位:正面平视中景,拍到大腿以上。人物站在车厢过道中间,左边是金属竖杆,背景是纵深的车厢和其他乘客。镜头缓慢往前推。
• 3.37–3.90:硬切进来。人物右手握着竖杆,左肩背着黑色包,看着镜头。
• 3.90–4.40:左手抬起来,把脸侧的头发往耳后拨。
• 4.40–5.33:左手停在耳边扶着头发,头微微向右歪,看着镜头,右手一直握着竖杆。

镜头4|5.33–7.27秒|背靠车厢隔板站着,手里拿奶茶

• 机位:平视全景,画面从车厢纵深方向拍过去。人物在画面右侧,背靠车门旁的白色隔板,左边是长长的车厢,里面有很多乘客和行李箱。
• 5.33–6.00:硬切进来。人物背靠隔板站着,双腿并拢,左手在胸前拿着一杯带吸管的奶茶,右手垂在身侧,黑色包放在脚边或挂在手臂上,看着镜头。
• 6.00–7.27:姿势基本不变,头微微转向车厢一侧,再转回来看着镜头,镜头有轻微的手持晃动。

镜头5|7.27–8.73秒|靠墙曲腿,拨头发后转头

• 机位:平视中全景,比镜头4离人物更近。人物还是靠着同一块白色隔板,左边背景是坐着的乘客和行李。
• 7.27–7.60:硬切进来。人物背靠隔板,一条腿弯曲,脚掌向后抵在隔板上。右手抬到头侧拨头发,左手拿着奶茶,头歪着看向镜头。
• 7.60–8.10:右手放下,叉在腰侧,还保持曲腿姿势。
• 8.10–8.73:抬起的脚放回地面,双腿并拢站直。头转向画面左侧,看向车厢里面,侧脸朝镜头。

(补充)镜头5延续|8.73–10.00

• 8.73–9.40:机位不变。人物保持站立,慢慢把头转回来看着镜头。
• 9.40–10.00:左手拿着奶茶放在胸前,右手自然垂下,身体轻轻靠着隔板,画面停在这个构图上直到结束。

风格:写实真人质感,手机竖屏随手拍的感觉,高清,自然生活场景,带轻微手持晃动。

音频:保留背景音乐,切镜点 1.97、3.37、5.33、7.27 秒对准音乐节拍。

参数:10.00 秒,9:16 竖屏,1080×1920,30fps。

负面提示词:换脸、五官变形、发型改变、服装颜色或款式变化、工牌消失、多出手指、肢体扭曲、腿部比例异常、路人看镜头、路人脸部畸形、画面闪烁、文字水印、背景变形、车厢结构错乱。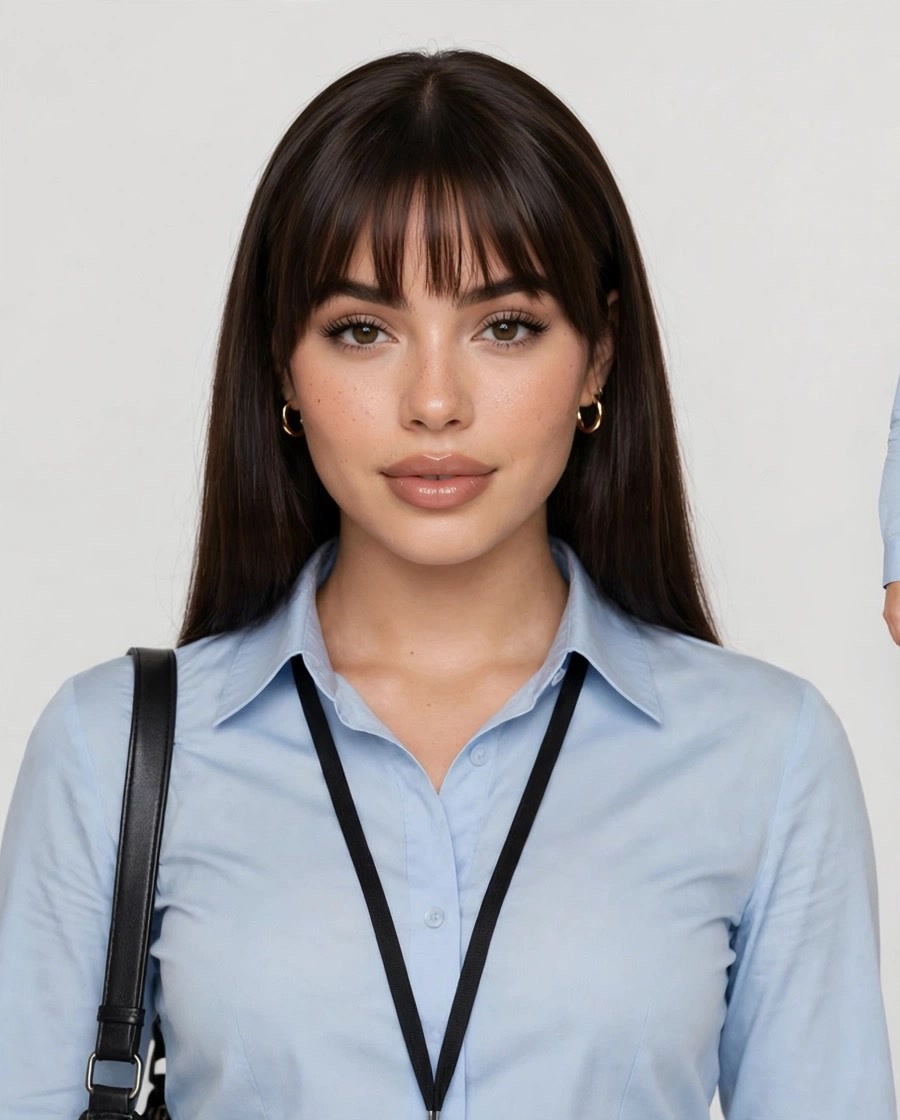
 Промпт адаптирован из поста @beizhi606
参考图说明:参考图1是人物大头照(脸、五官、发型、发色、妆容都以它为准),参考图2是同一个人的三视图(服装、配饰、鞋子、身材都以它为准)。人物是 25 岁的欧美女性,Instagram 博主风格的精致妆容。下文里「原视频里」的发型、发色和穿搭描述一律忽略,以参考图为准。

中文提示词(10.00秒)
人物

• 脸部:完全按【参考图1 大头照】,五官、脸型、发型、发色都以大头照为准,每个镜头保持同一张脸。原视频里是黑棕色齐腰长直发、齐刘海。
• 服装和身材:完全按【参考图2 三视图】,包括服装款式、颜色、配饰、鞋子和身材比例。原视频里的穿搭只作为没有参考时的备用:
• 浅蓝色长袖衬衫,扎进裙子里;
• 灰色包臀短裙;
• 黑色薄丝袜,黑色尖头细高跟鞋;
• 胸前挂黑色挂绳工牌;
• 黑色单肩包。

• 一致性:5 个镜头里人物的脸和服装不能变。

场景

• 地铁车厢里,白色车厢内壁,金属扶手竖杆。
• 车门边有黄黑警示条,门上有出口和安全标识。
• 车厢里有其他乘客:有的低头看手机,有的坐着,有的站着,有的放着红色行李箱和紫色袋子。乘客都是自然状态,不看镜头。

光线:地铁车厢顶部的白色日光灯,照明均匀明亮,偏冷白色调,写实。

机位:都是手机手持拍摄,平视或略低机位,竖屏。

分镜
镜头1|0.00–1.97秒|靠在车门边站着,旁边是看手机的乘客

• 机位:平视中全景,竖屏能拍到全身。画面左侧前景是一位穿蓝色T恤、低头看手机的男乘客,人物在画面中间偏右,背靠车门。
• 0.00–0.40:人物背靠车门,一条腿弯曲,脚掌向后抵在车门上。右手抬到颈侧摸着头发,看向镜头。
• 0.40–0.80:抬起的脚放回地面,变成双脚并拢站立,右手放下到胸前。
• 0.80–1.40:双手自然垂放,身体靠着车门,头微微低下。
• 1.40–1.97:右手抬到耳边,把头发往耳后拨,眼睛向下看。

镜头2|1.97–3.37秒|坐在座位上跷腿,侧脸看向左边

• 机位:略高的侧前方机位,中全景。人物在画面右侧,坐在地铁座椅上,左侧有一位戴眼镜、穿深色衣服的男乘客,低头看手机,旁边还站着一位乘客。
• 1.97–2.60:硬切进来。人物跷着二郎腿,黑色单肩包放在大腿上,双手放在包上,头转向画面左侧,侧脸朝镜头。
• 2.60–3.37:姿势不变,眼睛看着左前方,头发自然垂在背后,身体基本保持不动。

镜头3|3.37–5.33秒|手扶竖杆站着,拨头发

• 机位:正面平视中景,拍到大腿以上。人物站在车厢过道中间,左边是金属竖杆,背景是纵深的车厢和其他乘客。镜头缓慢往前推。
• 3.37–3.90:硬切进来。人物右手握着竖杆,左肩背着黑色包,看着镜头。
• 3.90–4.40:左手抬起来,把脸侧的头发往耳后拨。
• 4.40–5.33:左手停在耳边扶着头发,头微微向右歪,看着镜头,右手一直握着竖杆。

镜头4|5.33–7.27秒|背靠车厢隔板站着,手里拿奶茶

• 机位:平视全景,画面从车厢纵深方向拍过去。人物在画面右侧,背靠车门旁的白色隔板,左边是长长的车厢,里面有很多乘客和行李箱。
• 5.33–6.00:硬切进来。人物背靠隔板站着,双腿并拢,左手在胸前拿着一杯带吸管的奶茶,右手垂在身侧,黑色包放在脚边或挂在手臂上,看着镜头。
• 6.00–7.27:姿势基本不变,头微微转向车厢一侧,再转回来看着镜头,镜头有轻微的手持晃动。

镜头5|7.27–8.73秒|靠墙曲腿,拨头发后转头

• 机位:平视中全景,比镜头4离人物更近。人物还是靠着同一块白色隔板,左边背景是坐着的乘客和行李。
• 7.27–7.60:硬切进来。人物背靠隔板,一条腿弯曲,脚掌向后抵在隔板上。右手抬到头侧拨头发,左手拿着奶茶,头歪着看向镜头。
• 7.60–8.10:右手放下,叉在腰侧,还保持曲腿姿势。
• 8.10–8.73:抬起的脚放回地面,双腿并拢站直。头转向画面左侧,看向车厢里面,侧脸朝镜头。

(补充)镜头5延续|8.73–10.00

• 8.73–9.40:机位不变。人物保持站立,慢慢把头转回来看着镜头。
• 9.40–10.00:左手拿着奶茶放在胸前,右手自然垂下,身体轻轻靠着隔板,画面停在这个构图上直到结束。

风格:写实真人质感,手机竖屏随手拍的感觉,高清,自然生活场景,带轻微手持晃动。

音频:保留背景音乐,切镜点 1.97、3.37、5.33、7.27 秒对准音乐节拍。

参数:10.00 秒,9:16 竖屏,1080×1920,30fps。

负面提示词:换脸、五官变形、发型改变、服装颜色或款式变化、工牌消失、多出手指、肢体扭曲、腿部比例异常、路人看镜头、路人脸部畸形、画面闪烁、文字水印、背景变形、车厢结构错乱。Что Muse Video принимает, а что нет. Неподдерживаемые разрешения, соотношения сторон, длительности и входные данные отклоняются с кодом 400 ещё до создания задачи, поэтому ничего не списывается.
| Поддерживается | Не поддерживается | |
|---|---|---|
| Разрешение | Только 720p (resolution: 720p или без этого поля) | 1080p, 2K, 4K, 480p |
| Соотношение сторон | 16:9 горизонтальное, 1280×720 (по умолчанию); 9:16 вертикальное, 720×1280 | Квадрат 1:1, 4:3, 3:4, 21:9 и любые другие соотношения |
| Длительность | От 4 до 30 целых секунд; 5, 6, 8, 10, 15, 20, 25 и 30 с выходят ровно такой длины, остальные значения округляются вверх до ближайшего из них | Меньше 4 с, больше 30 с, дробные значения вроде 8.5 |
| Изображения | Либо 1 первый кадр, либо до 4 референсов, по которым сохраняется тот же человек или объект (не одновременно); PNG, JPEG или WebP, до 20 MB каждое, публичный URL или base64 | Первый кадр вместе с референсами, больше 4 референсов, последний кадр |
| Видео и аудио на входе | Нет: из медиа принимаются только изображения | Референсное видео, редактирование или продление видео, управляющее аудио, липсинк под ваше аудио |
| Звук | Модель генерирует его вместе с картинкой | Отключить звук нельзя (generate_audio: false отклоняется); наличие звука в каждом ролике не гарантируется |
| Прочие настройки | Промпт до 4000 символов на любом языке; движения камеры описываются в промпте | negative_prompt, seed (результаты не воспроизводятся), параметры управления камерой |
Как и любая видеомодель, Muse Video срабатывает не в 100% случаев. Неудачные задачи не оплачиваются.
Задача может завершиться неудачей и после того, как её приняли: модель может отказаться генерировать такой контент, генерация может упереться во временную ошибку, а готовый ролик, ориентация или длина которого не совпадает с запрошенной, отбраковывается. Неудачная задача переходит в состояние failed, причина указана в failMsg, а оплата возвращается.
Оба наших тестовых запроса при запуске вернули ролик, но этого слишком мало, чтобы обещать какой-либо процент успеха, поэтому мы его пока не публикуем. Закладывайте в пайплайн редкие сбои: повторяйте запрос при временных ошибках, переписывайте отклонённые промпты и не рассчитывайте, что ролик придёт с первой попытки.
Модель может отклонить промпт или входное изображение. Повтор того же запроса помогает редко: перепишите промпт или замените изображение.
Генерация может сорваться по причинам, не связанным с вашим запросом. Обычно помогает повторить тот же запрос чуть позже.
Готовый ролик с неверной ориентацией или короче запрошенного отбраковывается и не отдаётся вам. Повторите запрос.
По описанию Meta, звук генерируется вместе с картинкой, но один из двух наших тестовых роликов пришёл без звука. Если вам нужен звук, проверяйте каждый MP4 на наличие аудиодорожки.
$0.037 за запрошенную секунду. Первый кадр или референсы не меняют цену; неудачные задачи не оплачиваются.
| Запрос | Длина ролика | Цена |
|---|---|---|
| 4 с | 5 с | $0.148 |
| 5 с (по умолчанию) | 5 с | $0.185 |
| 6 с | 6 с | $0.222 |
| 7 с | 8 с | $0.259 |
| 8 с | 8 с | $0.296 |
| 10 с | 10 с | $0.37 |
| 15 с | 15 с | $0.555 |
| 20 с | 20 с | $0.74 |
| 25 с | 25 с | $0.925 |
| 30 с (максимум) | 30 с | $1.11 |
Ролики до 10 секунд обычно готовы за одну-две минуты, от 15 до 30 секунд — за три-семь минут; наши 4-секундные тестовые запросы заняли около полутора минут. В роликах длиннее 10 секунд план меняется примерно на 10-й и 20-й секунде.
Один человек крупным планом на фронтальную камеру, цепочка мелких жестов, тёплый приглушённый свет и музыка, как в примере выше.
Передайте в images до четырёх фото одного и того же человека и опишите новую сцену. В одном тесте четыре фото молодой женщины и промпт про пляж на закате дали за 88 секунд ролик 9:16 длиной 5,0 секунды со звуком: то же лицо и та же причёска, похожая одежда и даже «виктория» и смех в ладонь, взятые с фотографий. Ролик начался на пляже, а не с одной из фотографий. Это один тест, а не гарантия.
Вертикальные 9:16 для лент коротких видео или горизонтальные 16:9 для страниц и рекламы, от 5 до 30 секунд в 720p.
Предметное фото, иллюстрация или снимок в роли первого кадра, а движение описано в промпте.
Muse Video выдаёт только 720p в 16:9 или 9:16. Если нужно разрешение выше или другая форма кадра, выберите другую видеомодель на APIMODELS.
Изображения принимаются только как первый кадр или как референсы: ни последнего кадра, ни референсного видео, ни липсинка под ваше аудио.
Часть запросов завершается неудачей, а часть роликов приходит без звука. Если один пропущенный ролик ломает ваш продукт, добавьте повторы и проверки, прежде чем на него полагаться.
Muse Video — это API категории «генерация видео» от Meta. Muse Video — видеомодель Meta Superintelligence Labs. На APIMODELS это одна модель muse-video на едином видеоэндпоинте: отправьте только промпт — получите видео из текста; добавьте одно изображение первого кадра — и ролик начнётся с этой картинки; добавьте до четырёх референсных изображений — и модель сохранит того же человека или объект, но не начнёт ролик ни с одного из них. Запрос остаётся компактным. prompt обязателен (до 4000 символов, на любом языке). duration задаёт длину в целых секундах от 4 до 30 (поле seconds в стиле OpenAI тоже работает); если его не указать, ролик будет 5 секунд. aspect_ratio выбирает горизонтальный 16:9 (по умолчанию, 1280×720) или вертикальный 9:16 (720×1280); size 1280x720 или 720x1280 делает то же самое. Выход всегда 720p: 1080p и квадратного формата нет, и такой запрос получает 400 ещё до создания задачи. Для видео из изображения передайте первый кадр в image_url (подойдут и first_frame_url, image и input_reference), лучше в той же ориентации, что и ролик; референсные изображения, до четырёх, передаются в images (подойдут и image_urls, reference_image_urls). Каждое изображение — публичный URL или base64 data URI в формате PNG, JPEG или WebP. Выбирайте что-то одно: первый кадр вместе с референсами, больше четырёх референсов, последний кадр, референсное видео или аудио, negative_prompt, seed и отключение звука отклоняются с ошибкой 400. Длина ролика идёт шагами. Запросы на 5, 6, 8, 10, 15, 20, 25 или 30 секунд возвращаются ровно такой длины; любое другое целое число округляется вверх до следующего шага (4 → 5 с, 7 → 8 с, 11 → 15 с), поэтому ролик никогда не бывает короче оплаченного. Видео — H.264 MP4 с частотой 24 fps, и, по описанию Meta, Muse Video генерирует звук вместе с картинкой. В нашем тесте с референсами четыре снимка одной девушки дали 5-секундный ролик на пляже, где у неё сохранились лицо и причёска; ни с одного из снимков модель ролик не начинала. Генерация идёт как асинхронная задача: создайте её, затем опрашивайте статус или получите callback. Ролики до 10 секунд обычно занимают одну-две минуты, от 15 до 30 секунд — от трёх до семи. Не каждый запрос завершается успешно: модель может отказаться генерировать контент, генерация может столкнуться с временной ошибкой, а ролик с неверной ориентацией или длиной отбраковывается; неудачная задача не оплачивается. Цена — $0.037 за запрошенную секунду: 5 с — $0.185, 10 с — $0.37, 30 с — $1.11. Через платформу APIMODELS доступ к этой модели идёт по единому API с прозрачной оплатой по факту использования. Текущая цена: per second: $0.037, 5s (default): $0.185, 8s: $0.296, 10s: $0.37, 15s: $0.555, 20s: $0.74, 30s (maximum): $1.11.
Быстро собрать промо-видео бренда под рекламные кампании и продвижение в соцсетях.
Короткие вертикальные ролики для TikTok, Instagram и YouTube.
Показать возможности продукта и снять обучающие ролики, которые повышают конверсию.
Объяснения к курсам, разборы тем и обучающие видео — недорого и на потоке.
Muse Video доступна через APIMODELS по цене: per second: $0.037, 5s (default): $0.185, 8s: $0.296, 10s: $0.37, 15s: $0.555, 20s: $0.74, 30s (maximum): $1.11. Оплата идёт по факту использования — вы платите только за то, что сгенерировали.
Зарегистрируйтесь на APIMODELS, получите API-ключ и обращайтесь к нашему единому эндпоинту. Есть подробная документация с примерами на cURL, Python и Node.js.
APIMODELS отдаёт ту же самую модель Muse Video через свою агрегирующую платформу. Мы предоставляем единый интерфейс API, поэтому отдельные аккаунты у каждого поставщика не нужны — один ключ открывает доступ ко всем моделям.
Muse Video — видеомодель Meta Superintelligence Labs. Она превращает текстовый промпт в ролик 720p длиной от 4 до 30 секунд, горизонтальный 16:9 или вертикальный 9:16. К промпту можно добавить одно изображение первого кадра, и ролик начнётся с него, или до четырёх референсных изображений, чтобы в кадре остался тот же человек или объект. По описанию Meta, звук генерируется вместе с картинкой. На apimodels.app модель Muse Video от Meta доступна как одна модель muse-video на POST /v1/video/generations. Неудачные генерации не оплачиваются, цена — $0.037 за запрошенную секунду.
Полный список ограничений Muse Video: только 720p (нет 1080p, 2K, 4K и 480p); только горизонтальный 16:9 — 1280×720 или вертикальный 9:16 — 720×1280 (нет квадрата, 4:3, 21:9 и любых других соотношений); от 4 до 30 целых секунд, ровно 5, 6, 8, 10, 15, 20, 25 и 30 с, остальные длины округляются вверх, дробные значения не принимаются; изображения: либо один первый кадр, либо до четырёх референсных изображений, сохраняющих того же человека или объект, но не то и другое сразу; каждое — PNG, JPEG или WebP до 20 MB (нет последнего кадра, не больше четырёх референсов); нет видео и аудио на входе, нет липсинка под ваше аудио, нет редактирования и продления видео; по описанию Meta, модель генерирует звук, но звук не гарантирован в каждом ролике, и отключить его нельзя; нет negative_prompt, seed и параметров управления камерой (движение камеры описывайте в промпте); промпт — до 4000 символов. Неподдерживаемые входные данные — другое разрешение или соотношение сторон, первый кадр вместе с референсами, больше четырёх референсов, последний кадр, видео или аудио на входе, negative_prompt, seed или generate_audio: false — отклоняются с ошибкой 400 до создания задачи. Но и в этих рамках не каждый запрос завершается успешно: модель может отказаться генерировать контент или столкнуться с временной ошибкой, а неудачная задача не оплачивается.
Да. У одной модели muse-video три режима ввода, и режим определяется тем, что вы отправили. Только промпт — видео из текста. Одно изображение первого кадра — ролик начнётся с этой картинки: передайте его в image_url (подойдут и first_frame_url, image, input_reference). От одного до четырёх референсных изображений — модель сохранит того же человека, объект или стиль, но ролик не начнётся ни с одного из них; это удобно для персонажа, который переходит из ролика в ролик: передайте их массивом в images (подойдут и image_urls, reference_image_urls). Любой массив считается референсами, поэтому image_urls с одним элементом — это один референс, а не первый кадр. Первый кадр и референсы вместе не принимаются: если отправить и то и другое или больше четырёх референсов, запрос получит 400 до создания задачи. Каждое изображение — публичный URL или base64 data URI в формате PNG, JPEG или WebP, до 20 MB. Первый кадр лучше брать той же ориентации, что и ролик: горизонтальный для 16:9, вертикальный для 9:16. Последний кадр (last_frame_url), референсное видео и аудио на входе не поддерживаются. Все три режима стоят одинаково.
Референсы подсказывают модели, кто или что должно быть в кадре; кадрами ролика они не становятся. Передайте в images от одного до четырёх изображений одного и того же человека или объекта, опишите в промпте новую сцену и сошлитесь на референсы, например: «та же девушка, что на референсах». Мы проверили это один раз, 30 октября 2026 года: отправили четыре снимка одной девушки (лежит на подушке, улыбается, показывает знак V, смеётся, прикрыв рот рукой) с промптом "The same young woman from the reference images walks barefoot along a beach at sunset, smiling back at the camera, handheld vertical shot", 4 секунды, 9:16. Через 88 секунд пришёл ролик 720×1280 длиной 5.0 секунды со звуковой дорожкой. Он не начинался ни с одного референса: первый же план был на пляже. У девушки сохранились лицо, причёска и похожий стиль одежды (кремовый топ на бретельках с референсов превратился в белое платье-комбинацию), модель повторила и жесты с референсов — знак V и смех, прикрыв рот рукой, — а за 5 секунд сменила несколько планов: крупные, общий и вид со спины. Это один тест, а не гарантия сходства или того, как будет смонтирован ролик. Если ролик обязан начинаться с конкретной картинки, используйте первый кадр. Референсы ничего не добавляют к цене: 4-секундный запрос с ними списался ровно как 4-секундное видео из текста.
От 4 до 30 секунд, целыми секундами, через duration (работает и поле seconds в стиле OpenAI); без него ролик будет 5 секунд. Длина выхода идёт шагами: запросы на 5, 6, 8, 10, 15, 20, 25 или 30 секунд возвращаются ровно такой длины, а любое другое целое число округляется вверх до следующего шага: 4 → 5 с, 7 → 8 с, 9 → 10 с, 11–14 → 15 с, 16–19 → 20 с, 21–24 → 25 с, 26–29 → 30 с. Ролик никогда не бывает короче оплаченного. Если нужна точная длина, запрашивайте одно из этих значений. Дробные значения и числа вне диапазона 4–30 получают 400 до создания задачи.
Только 720p, в двух формах: горизонтальная 16:9 — 1280×720 (по умолчанию) и вертикальная 9:16 — 720×1280. Выбирайте через aspect_ratio со значением 16:9 или 9:16 либо через size 1280x720 или 720x1280; resolution необязателен и принимает только 720p. Квадрата, других соотношений и 1080p нет: такой запрос получает 400 до создания задачи, а не тихо возвращает другой размер. Каждый ролик — H.264 MP4 с частотой 24 fps.
По описанию Meta, Muse Video генерирует звук вместе с картинкой. В наших собственных тестах при запуске 30 октября 2026 года два 4-секундных запроса вернулись двумя роликами по 5.0 секунды: в горизонтальном была звуковая дорожка AAC, а вертикальный пришёл без звука. Поэтому, если вашему пайплайну нужен звук, проверяйте каждый MP4 на наличие аудиодорожки (это видно в ffprobe) и заранее предусмотрите запасной вариант для роликов без неё — например, музыку или закадровый голос. Отключить звук нельзя: generate_audio: false получает 400 ("muse-video cannot turn sound off: the model decides whether a clip has sound"), а generate_audio: true принимается, но звук не гарантирует.
Ролики до 10 секунд обычно занимают одну-две минуты, от 15 до 30 секунд — обычно от трёх до семи минут; наши 4-секундные тестовые запросы завершились примерно за 1.5 минуты. Вызов асинхронный: создание задачи сразу возвращает taskId, после чего опрашивайте GET /v1/video/generations?task_id= каждые 10–15 секунд или передайте callback_url и дождитесь нашего POST-запроса.
$0.037 за запрошенную секунду, оплата по длительности, которую вы отправили: 4 секунды — $0.148, 5 секунд (по умолчанию) — $0.185, 6 секунд — $0.222, 8 секунд — $0.296, 10 секунд — $0.37, 15 секунд — $0.555, 20 секунд — $0.74, 25 секунд — $0.925, 30 секунд — $1.11. Длительность между ступенями оплачивается по запрошенным секундам: 7 секунд стоят $0.259, а ролик приходит длиной 8 секунд. Первый кадр и референсные изображения ничего не добавляют к цене, так что все три режима стоят одинаково, а соотношение сторон на цену не влияет. Неудачные генерации не оплачиваются.
Не каждый запрос к Muse Video завершается успешно. Генерация может не удаться по трём причинам: модель отказывается генерировать контент, генерация сталкивается с временной ошибкой или готовый ролик приходит с неверной ориентацией либо короче запрошенного и отбраковывается. Неудачная задача переходит в состояние failed, причина указана в failMsg, и списания не будет. Процент успешных генераций мы пока не публикуем: оба наших тестовых запроса при запуске вернули ролик, но двух тестов слишком мало, чтобы что-то обещать. Временные ошибки повторяйте, отклонённый промпт переписывайте и не стройте пайплайн в расчёте на то, что первая попытка всегда сработает. Запросы, которые Muse Video не может выполнить, вообще не становятся задачами: отсутствующий промпт или промпт длиннее 4000 символов, duration не целым числом от 4 до 30, resolution не 720p, соотношение сторон не 16:9 и не 9:16, первый кадр вместе с референсами, больше четырёх референсов, последний кадр, видео или аудио на входе, negative_prompt, seed или generate_audio: false — всё это получает 400 с понятным сообщением об ошибке до создания задачи. Сами изображения проверяются во время работы: если картинка не PNG, JPEG или WebP или больше 20 MB, задача завершается ошибкой с причиной, например "first-frame image must be PNG, JPEG or WebP" или "reference image 2 must be PNG, JPEG or WebP", — тоже без списания.
Опишите, кто или что в кадре, как оно движется и как движется камера, например: «рыжий кот потягивается на подоконнике, в окно льётся солнечный свет, камера медленно наезжает». Промпт — до 4000 символов на любом языке. Ролики длиннее 10 секунд меняют план примерно на отметках 10 и 20 секунд, поэтому длинный промпт удобно писать по отрезкам: «первые 10 секунд …, затем …». Для видео из изображения берите первый кадр той же ориентации, что и ролик, а в промпте описывайте, что происходит дальше. С референсами называйте героя «тот же человек, что на референсах» и описывайте новую сцену: ролик не начнётся ни с одного из них.
Зарегистрируйтесь на apimodels.app и создайте API-ключ в консоли: один ключ и один баланс в долларах работают для всех моделей. Затем отправьте запрос: curl -X POST https://api.apimodels.app/v1/video/generations -H "Authorization: Bearer YOUR_API_KEY" -H "Content-Type: application/json" -d '{"model": "muse-video", "prompt": "рыжий кот потягивается на подоконнике, в окно льётся солнечный свет, камера медленно наезжает", "duration": 5, "aspect_ratio": "16:9"}'. Чтобы начать со своего первого кадра, добавьте "image_url", а чтобы сохранить того же человека или объект — "images" с референсами (до четырёх). В ответе будет taskId: опрашивайте GET /v1/video/generations?task_id= каждые 10–15 секунд, пока state не станет completed, или передайте callback_url, а затем скачайте MP4 из resultUrls в течение 30 дней.
Не полностью. Подходящие новые аккаунты получают $0.10 пробного баланса, но самый короткий запрос Muse Video — 4 секунды — стоит $0.148, поэтому для первого теста нужно пополнение; пополнение — от $10. Оплата по факту использования, без подписки. Песочница на этой странице показывает цену до нажатия Generate, а неудачные генерации не оплачиваются.
В APIMODELS Muse Video соседствует более чем с 60 моделями под одним API-ключом и общим балансом, поэтому выбор — это вопрос соответствия задаче, а не привязки к поставщику. Модель поддерживает Text to Video, Image to Video (First Frame), Up to 4 Reference Images, 720p · 16:9 / 9:16, 4–30s · Exact at 5/6/8/10/15/20/25/30s, Sound with the Picture, Failed Generations Not Charged, $0.037/s; вы можете сравнить её по цене и возможностям с другими моделями категории «генерация видео» и переключиться, изменив одну строку с именем модели — без нового аккаунта и без переписывания интеграции. Все варианты категории «генерация видео» с актуальными ценами — на apimodels.app/models.
Muse Video поддерживает: Text to Video, Image to Video (First Frame), Up to 4 Reference Images, 720p · 16:9 / 9:16, 4–30s · Exact at 5/6/8/10/15/20/25/30s, Sound with the Picture, Failed Generations Not Charged, $0.037/s. Полный список параметров и примеры вызовов — в документации APIMODELS.
Да. APIMODELS отдаёт Muse Video через единый API и один ключ — отдельные аккаунты у каждого поставщика не нужны, и вам не приходится самостоятельно решать вопросы регионального сетевого доступа к каждому из них.
Принимаем Stripe (Visa, Mastercard и другие международные карты) и Alipay. Баланс становится доступен сразу после оплаты.
