先给结论:可以通过 apimodels.app 调用 Space Bunny Alpha。用你的 apimodels key 发 POST https://api.apimodels.app/v1/chat/completions,"model" 填 "space-bunny-alpha";OpenAI 的 SDK 只改 base_url 和 key 就能用。价格是每百万 token 输入 $0.10、输出 $0.40、缓存输入 $0.01,按实际用量计费,推理 token 算输出,失败的调用不收钱。
没有人知道它是谁做的。它挂在一个叫 "Stealth" 的提供方名下,标称 1M token 上下文、最长 524K 输出、可调 reasoning_effort、工具调用、response_format,以及图片和视频输入。stealth 发布是实验室在正式发布前收集真实反馈的方式;厂商揭晓后通常会改名或下线,所以把这个 id 当临时的,代码里留一个备选模型。
我们没有照抄目录页,而是测了它。28 个任务覆盖 3D 图形、网页、编码、科普视频、推理、四种语言的写作、结构化输出、工具调用、图片和视频输入、一份 9.1 万 token 的文档,以及 reasoning_effort 这个参数;每个任务一次真实 API 调用,每个产物都在 Chrome 里打开或手工核对。下面是我们看到的东西,包括不好使的那部分。
它 2026 年 9 月 23 日以 stealth/space-bunny-alpha 上架 OpenRouter,预览期标价 $0。在 apimodels.app 上同一个模型叫 space-bunny-alpha,每百万 token $0.10 / $0.40:没有官方定价可比,因为这个价买的是网关、共用的 key 和计费,不是模型本身。如果你已经有带余额的 OpenRouter 账号,那里是免费的;在这里调它的理由只有一把 key 调所有模型、一份余额,以及和我们另外 46 个语言模型一样的 OpenAI 兼容端点。
提供方的 stealth 条款写明提示词和输出可能被他们留存,但不用于训练。限流是预览本身的、不是我们的:持续高并发可能返回 HTTP 429;如果收到带 "no provider" 的 404,就是预览结束了。
| 项目 | apimodels.app | OpenRouter(预览) |
|---|---|---|
| 模型 ID | space-bunny-alpha | stealth/space-bunny-alpha |
| 接口 | POST https://api.apimodels.app/v1/chat/completions | POST https://openrouter.ai/api/v1/chat/completions |
| 每百万 token 输入 / 输出 | $0.10 / $0.40,缓存输入 $0.01 | 预览期 $0 / $0 |
| 上下文 / 最长输出 | 1M token / 524K token | 相同 |
| 推理 | reasoning_effort;推理过程随响应返回;推理 token 按输出计 | 相同 |
| 工具 / response_format | 工具调用实测通过;schema 不强制(见下) | 标称支持 |
| 图片 / 视频输入 | 图片可用;视频只到达抽样帧、无音频 | 标称支持 |
| 失败的调用 | 不计费 | 免费 |
每个案例一次调用,2026 年 9 月 29 日,max_tokens 预算 20 万,免得推理过程把正文饿死。判定口径:pass 是做到了要求、能跑或答对;partial 是能跑或有答案但缺陷说得出名字;fail 是跑不起来或答错。HTML 产物在 Chrome 里打开并盯着控制台;测试用 Node 24 真跑;SQL 在 PGlite 上跑;Remotion 组件对着真实的 remotion 和 React 包做类型检查;数值题手工核对。
各组的规律是一致的:生成很强,验证为零。它做出来的视觉产物全部能跑;每道编码题都有一个它自己跑一遍就能发现的小缺陷;它报出的词数、测试套件和「精确输出」都没有真正执行过。拿到手当未测试的源码对待。
| 组别 | 案例 | 通过 | 部分 | 失败 | 判定依据 |
|---|---|---|---|---|---|
| 3D / 图形 | 4 | 4 | 0 | 0 | Three.js 太阳系与产品展示、纯 CSS 翻转卡、SMIL 动画 logo:全部渲染、零控制台报错 |
| 网页 / UI | 2 | 2 | 0 | 0 | 58 KB 落地页和 64 KB Chart.js 仪表盘,每个控件在 Chrome 里逐个验证 |
| 编码 | 4 | 0 | 4 | 0 | 逻辑每次都对;漏一个 bug、3 条测试断言写反、SQL 一个乱码 token、手算分位数错 4 个 |
| 视频 / 科普 | 3 | 2 | 0 | 1 | 中文分镜脚本与 Remotion 组件通过;canvas 科普动画差一个引号 |
| 推理 | 3 | 3 | 0 | 0 | 数论答对;欠定谜题正确答「不唯一」;行程满足全部约束(medium 强度重跑) |
| 写作 | 4 | 4 | 0 | 0 | 合律的七言绝句、数字逐项保真的译文、2,300 词长文、母语水准的日韩文案 |
| 结构化输出 | 2 | 1 | 0 | 1 | 并行工具调用完美;严格 JSON schema 静默不强制 |
| 多模态 | 2 | 1 | 1 | 0 | 图片理解优秀;视频只到达几帧、无音频 |
| 长上下文 | 1 | 1 | 0 | 0 | 91,298 token 里 3 个针全部精确引用捞出 |
| 强度 / 速度 | 3 | 3 | 0 | 0 | low、默认、high 答案一致且正确;一段 86 词的回答前推理了 11 秒 |
第一组是同一条提示词在 reasoning_effort low 和 medium 下的结果:两页都完整、都能渲染,区别只是第一个 HTML 字节之前的推理量,434 字对 9,301 字。第二组是同一个产物的两个状态:模型原样返回的,和补上那一个缺失引号之后的。模型不跑自己写的东西,得你来跑。
两者都正确渲染。low 3.8 秒出第一个 token,medium 23 秒;默认强度没跑完(推理 110,334 字后在 303 秒被掐)。
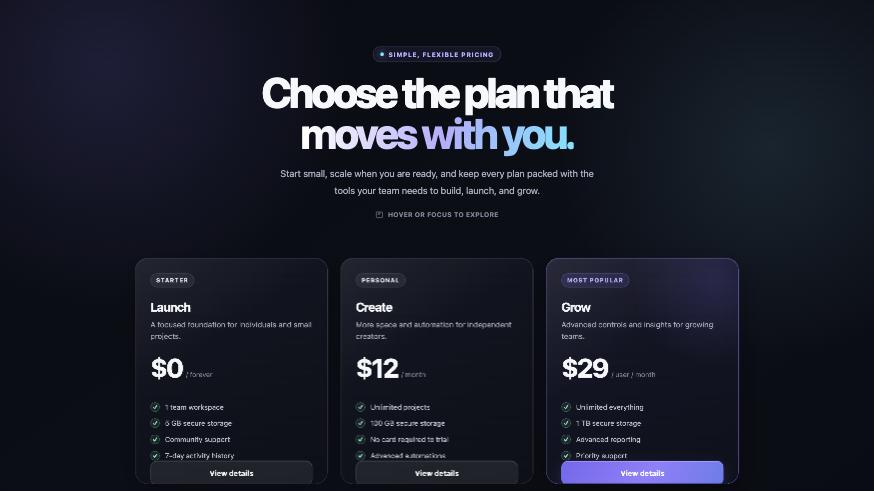
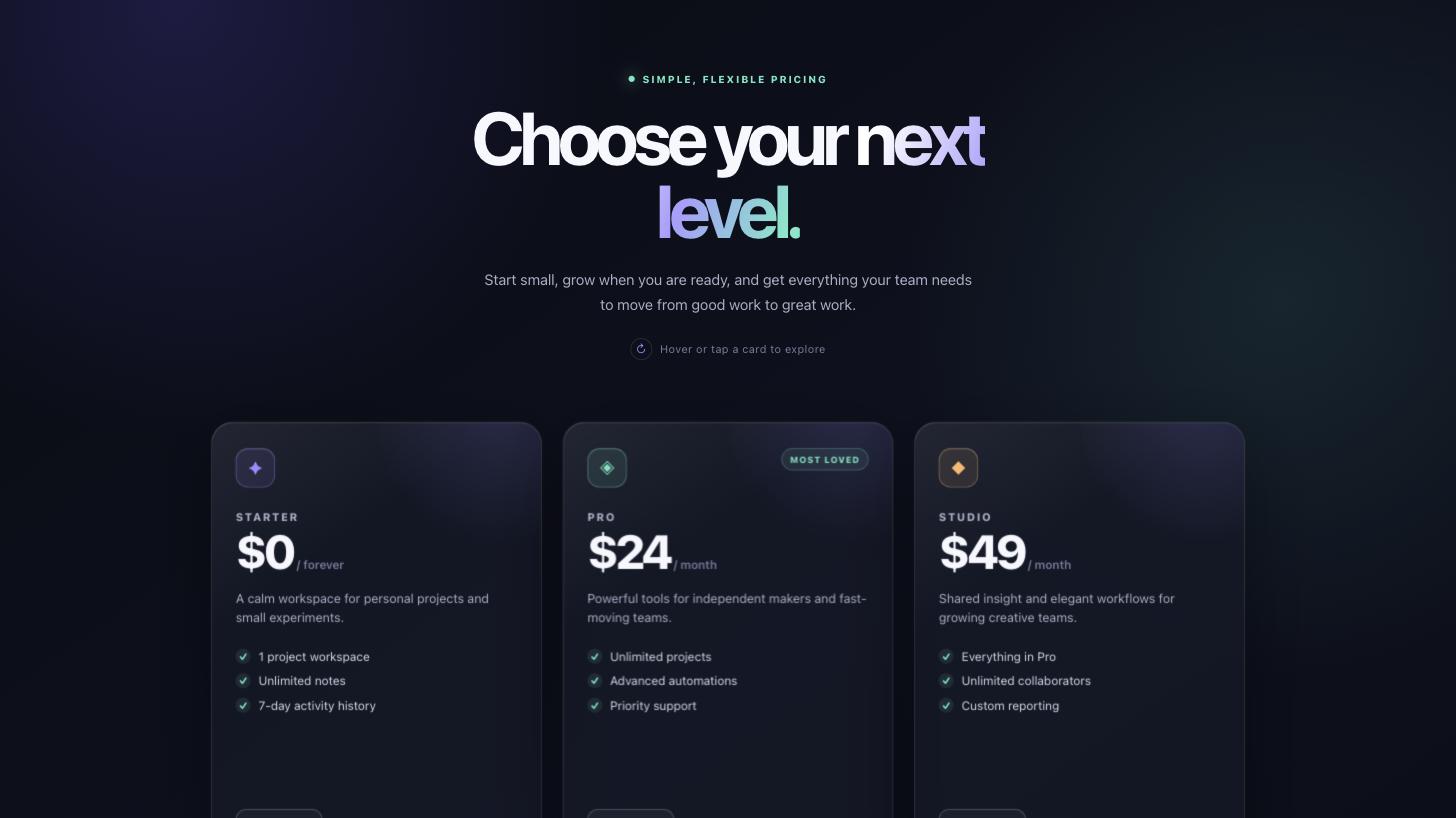
六张卡片悬停时 3D 翻转,带光泽扫过和 prefers-reduced-motion 分支,两版都没有 JavaScript。输出长度几乎一样(25,057 对 24,611 字),变的是推理量,差二十倍。
Write a single-file HTML page with pure CSS (no JS) 3D effects: a grid of six pricing cards that flip on hover in 3D with perspective, a subtle tilt that follows a CSS-only hover, layered depth using transform-style: preserve-3d, a glossy sheen sweep, and reduced-motion support. Mobile responsive. Return only the HTML.
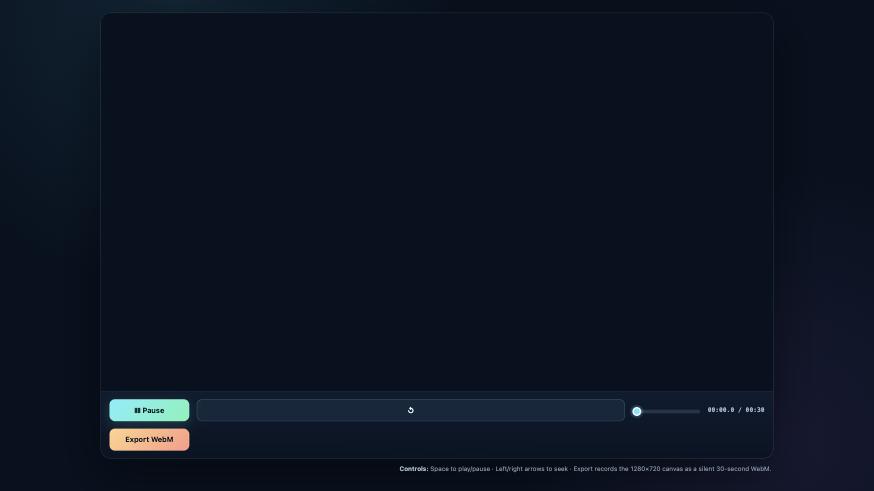
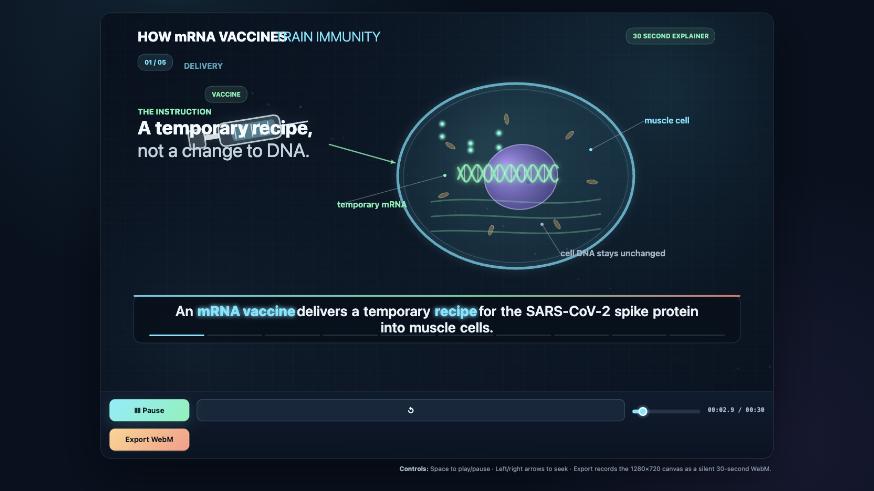
原样返回是一片空白:1,450 行里少一个闭合引号,浏览器报 SyntaxError,什么都不跑。补上那一个字符,五幕动画、字幕、拖动和播放暂停全部正常。
修好的版本仍有模型没看见的排版缺陷:两段标题文字重叠,第一幕的注射器图案压在标语上。字幕里的科学表述是谨慎的(临时配方、DNA 不变、抗原呈递细胞、记忆细胞)。
Make a single-file HTML "explainer video" about how mRNA vaccines train the immune system, 30 seconds long, 1280x720, rendered on a canvas with requestAnimationFrame: 5 scenes with smooth transitions, simple vector illustrations drawn in code (cell, mRNA strand, ribosome, spike protein, antibodies), animated captions with a timeline, a play/pause button, a progress bar, and an "Export WebM" button that records the canvas with MediaRecorder. Scientifically accurate captions. No external assets. Return only the HTML.
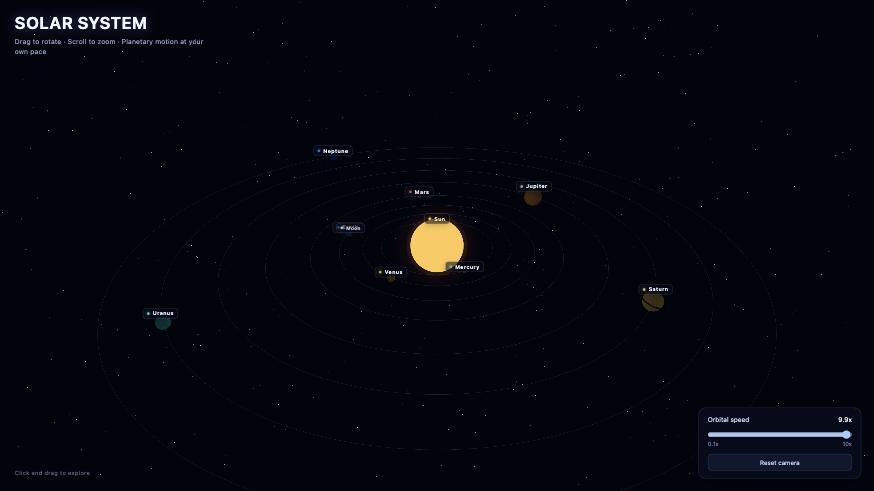
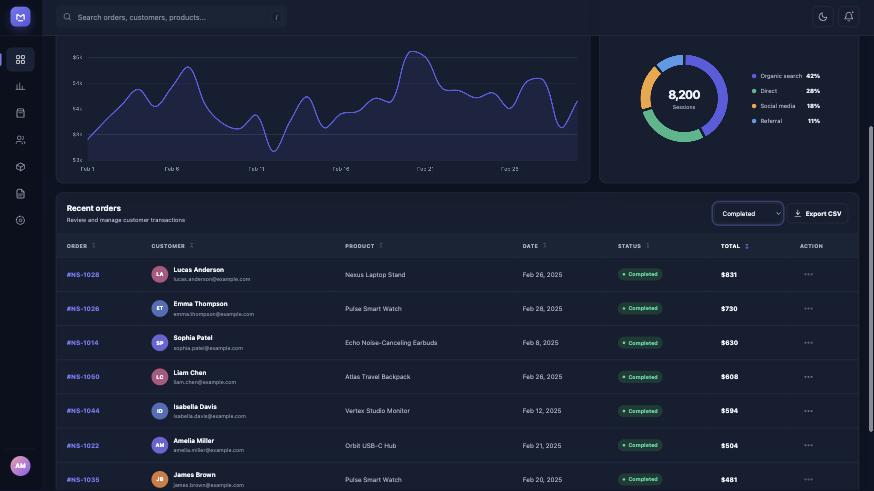
两者都原样能跑。太阳系有轨道控制、跟随每颗行星的标签和 0.1 到 10 倍速滑块;仪表盘用带种子的随机数,30 天曲线每次加载都一样,40 行表格可排序可筛选,暗色模式存在 localStorage 里。
medium 强度下的生成时间:太阳系 73 秒(10,121 输出 token),仪表盘 247 秒(18,895 输出 token),是整组里最慢的产物。两者都没有控制台报错。
Build a single-file HTML page (Three.js from a CDN, no build step) showing an animated solar system: the Sun with an emissive glow, the 8 planets with correct relative orbit order, distinct sizes and colors, orbit rings, Saturn with a ring, Earth with a moon, a starfield background, OrbitControls for mouse rotation/zoom, a floating label that follows each planet, and a speed slider (0.1x–10x). / Create a single-file admin dashboard in HTML/CSS/JS using Chart.js from a CDN: a collapsible sidebar, top bar with search, four KPI tiles with sparklines, a line chart of daily revenue for 30 days and a doughnut of traffic sources (seeded PRNG), a sortable and filterable data table of 40 orders with pagination, and a dark/light toggle persisted in localStorage.
这个模型先推理后作答,推理过程先于正文流出,并且算在 completion_tokens 里计费。默认强度下,凡是生成类任务推理量都极大:我们最早的三道编码题分别推理了 129,262、58,603、110,334 字,第一个正文字节分别在 284 秒和 276 秒才出现(第二道根本没出),三条流都在约 300 秒被提供方掐断、没有 finish_reason。后面一份三日行程同样如此(94,085 字,303 秒被掐),一首四行诗在 352 字正文之前推理了 226 秒。
传 reasoning_effort 就能解决,而且看不出代价。CSS 卡片那题,low 推理 434 字、medium 9,301 字,都在约 55 秒完成,两页渲染效果一样好。简单、题意明确的问题上这个参数没有影响:数论题在 low、默认、high 下答案一样正确,推理量分别是 415、499、452 字。这个旋钮只在开放式或生成量大的任务上起作用,而那正是你需要它的地方。
| 强度(同一 CSS 卡片提示词) | 推理字数 | 首个正文 token | 总耗时 | 结果 |
|---|---|---|---|---|
| low | 434 | 3.8 秒 | 53 秒 | 渲染正常、零报错 |
| medium | 9,301 | 23 秒 | 55 秒 | 渲染正常、零报错 |
| 默认(不传) | 110,334 | 276 秒 | 303 秒被掐 | HTML 未写完 |
严格 JSON schema。我们通过 response_format 传了 json_schema、strict: true、additionalProperties: false 和六个必填键。返回的是合法 JSON,厂商名、发票号、三条明细和总额都对,但 date 变成了 issue_date,total 变成了 amount_due 加 subtotal,每条明细还带着 schema 禁止的 line_total。这条线路上没有任何东西强制 schema。拿你的 schema 校验响应、失败就重试;工具调用(并行两个调用、参数精确、2 秒)才是今天从这个模型拿结构化结果的可靠办法。
视频输入。我们发了一段 2.02 秒、60 帧、带 AAC 音轨的片子。模型把开头的俯瞰和结尾的水面视角都描述对了,但它拿到的时间戳只到 0.2 秒、没有音频,于是把片长估成 0.2 到 0.3 秒,也说不出有没有声音。视频到达模型时只是几帧抽样。问它画面里有什么可以;别问时长、运动和声音。
自我验证。13 个代码产物里有 2 个坏在恰好一个字符上(SQL 关联条件里一个多余 token,1,450 行 JavaScript 里少一个引号);它给一个正确的缓存写了 13 条测试,其中 3 条断言和自己的代码相反;它声称 pandas 脚本会打印的「精确表格」12 个分位数错了 4 个;一篇 2,300 词的文章被标成 2,500 词。它没有执行过自己产出的任何东西。而凡是我们自己跑过的,底层逻辑每次都站得住。
用 OpenAI 兼容的 chat 端点加你的 apimodels key;下面的示例就是我们实际发的请求。两个设置:传 reasoning_effort(代码、网页、规划、长文用 "low" 或 "medium",只有短问答才留默认),以及不要限制 max_tokens。网关只在你传了 max_tokens 时才转发,不传就由上游按模型自身 524K 的上限处理;设小会拿到空正文,因为推理过程先把额度吃掉了。长生成请用流式:跑超过几分钟的非流式请求会返回空。
吞吐量含推理流约每秒 90 到 140 token,所以一个 16K token 的页面在 medium 下大约 75 秒。响应里推理过程是 content 旁边的一个独立字段;usage 把推理计在 completion_tokens 里(reasoning_tokens 报 0),计费就按这个数。
cURL
curl https://api.apimodels.app/v1/chat/completions \
  -H "Authorization: Bearer $APIMODELS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "space-bunny-alpha",
    "reasoning_effort": "medium",
    "stream": true,
    "messages": [
      {"role": "user", "content": "Build a single-file HTML page with a pure-CSS 3D flip-card grid. Return only the HTML."}
    ]
  }'
# No max_tokens: the gateway forwards nothing and the model's own 524K limit applies.
# Reasoning streams first (delta.reasoning), then the answer (delta.content).
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.apimodels.app/v1", api_key="YOUR_APIMODELS_KEY")

stream = client.chat.completions.create(
    model="space-bunny-alpha",
    messages=[{"role": "user", "content": "Build a single-file HTML page with a pure-CSS 3D flip-card grid. Return only the HTML."}],
    stream=True,
    extra_body={"reasoning_effort": "medium"},   # low or medium for code, pages, plans
    # max_tokens omitted on purpose: the reasoning trace is billed inside completion_tokens
)
for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
print(delta.content, end="", flush=True)可以。用你的 apimodels key 发 POST https://api.apimodels.app/v1/chat/completions,"model" 填 "space-bunny-alpha"。请求和响应就是 OpenAI Chat Completions,OpenAI 的 SDK 只改 base_url 和 key 就能用。每百万 token $0.10 / $0.40,缓存输入 $0.01,失败的调用不收钱。
没有人公开过。它从 2026 年 9 月 23 日起挂在 OpenRouter 一个匿名的 "Stealth" 提供方名下,这是实验室在正式发布前收集反馈的常见做法。响应里带 provider: "Stealth"。厂商揭晓后它大概率会改名或下线,代码里要留备选。
几乎都是 max_tokens 的问题。推理过程先于正文流出,而且算在 completion_tokens 里,几千 token 的上限会被推理全部吃掉,正文为空、finish_reason 是 length。不传 max_tokens 或设大,并传 reasoning_effort low 或 medium 让推理短一点。另一个原因是非流式请求跑超过几分钟:长生成用 stream: true。
擅长产出,不擅长核对。6 个 3D 和网页产物原样在 Chrome 里能跑、零控制台报错,一个 Remotion 组件在严格 TypeScript 下对着真实包类型检查通过。但 4 道纯编码题全是部分通过:漏了一个 bug、写了三条和自己正确代码相反的测试、SQL 里留了一个乱码 token、声称脚本会打印的分位数算错四个。它返回的一切都要跑、要 lint、要类型检查。
response_format 会被接受,但实测里严格 schema 没被强制:必填键被改名、出现了被禁止的额外字段,尽管 JSON 本身合法、事实也对。在你这边校验并重试,或者改用工具调用 —— 它并行返回两个参数精确的调用只用 2 秒。
取决于 reasoning_effort 远多于取决于提示词。low 或 medium 下,编码和网页任务 4 到 40 秒出第一个正文 token,一个 16K token 的页面端到端约 75 秒;吞吐量含推理约每秒 90 到 140 token。默认强度下,生成量大的任务先推理 4 到 5 分钟才出第一个字,28 次里 4 次在约 300 秒被上游掐断。短问答无论如何几秒就出。